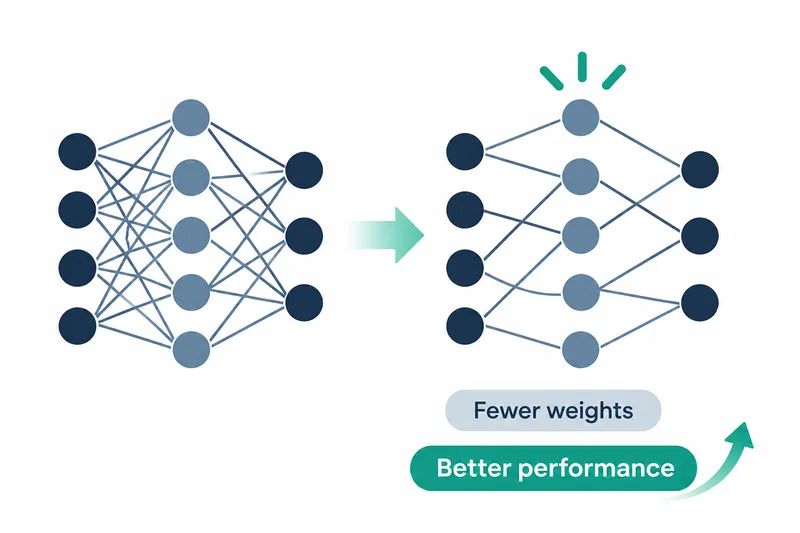
ニューヨーク大学とカルガリー大学の研究チームが、大規模言語モデルの重みの一部を0にするだけで新たな能力を学ぶ削除チューニング、つまり一部の重みを消してタスクを学ぶ手法を提案した。モデルをタスクごとに調整する開発者は、全重みを再保存する代わりに、小さな削除リストを保存できる。研究チームの実験では、大規模モデルほど全重みを変更する学習に近い精度を示し、以前のタスクの性能もよりよく維持した。
1. 重みを書き直す代わりに削除位置を学ぶ
削除チューニングは、モデル内部の情報の流れを調節するゲート投影の重み、つまり情報の流れを調節する層の学習値を対象とする。各値を維持するか0にするかを選ぶ二値マスク、つまり各要素の維持の有無を示す配列が学習結果となる。既存の数値を書き換えず、残す位置と消す位置を指定する方式だ。
学習中は連続値で削除の判断を調整し、最終的に維持か削除のどちらかを選ぶ。初期選択には、重みの大きさと入力の活性値を用いるWandaスコア、つまり重みの重要度を推定する基準を使う。削除率は固定せず、主な強化学習の比較に用いた六つのモデルでは、全重みの0.05%未満を削除した。
2. 大規模モデルでは全重みの学習に近づいた
研究チームは、毎回最も確率の高い回答の断片を選ぶ貪欲デコーディング、つまり各段階で最優先の候補を選ぶ生成法で評価し、検証精度が最も高いチェックポイント、つまり学習中に保存したモデル状態を報告した。以下は、同じモデルで数学問題を強化学習、つまり報酬に応じて回答を改善する方式で学習した比較だ。追加の行列だけを学習するLoRA、つまり一部の低次元行列だけを学習する手法も比較対象に加えた。
表:同じ80億パラメータモデルの数学精度と保存サイズ
条件:Llama3-8B-Instruct、GSM8K、GRPO、最高検証チェックポイント、貪欲デコーディング、H200 GPU・FSDP。保存サイズは、全面ファインチューニングのfp32重みや圧縮マスクなどからモデルを復元するために必要なディスク容量の下限
単位:精度 %、保存サイズ MB(1 GB = 1024 MB)
| 項目 | 精度 | 保存サイズ |
|---|---|---|
| 基本モデル | 60.27 | 0 |
| 全面ファインチューニング | 83.24 | 30633 |
| LoRA(r=1) | 83.38 | 10.0 |
| 削除チューニング | 83.55 | 8.4 |
削除チューニングは、この条件で全面ファインチューニングと同程度の精度を示しながら、保存する変更分を減らした。表の基本モデルのサイズ0は、元のモデル以外に追加保存する学習結果がないことを意味する。
小規模モデルでは差が残った。同じ数学タスクを学習した10億パラメータモデルでは、削除チューニングが54.44%、全面ファインチューニングが60.50%だった。別の数学学習データSimpleRL-Zooで訓練したQwen2.5-14Bは、六つのベンチマークの平均でそれぞれ55.43%、54.87%を記録した。
同じ六つのベンチマークで評価したQwen3-30B-A3Bでは、それぞれ58.54%、58.43%だった。全300億パラメータのうち30億を活性化する混合エキスパートモデル、つまり入力ごとに一部の専門家層だけを使う構造にまで適用範囲を広げた結果だ。
3. 正解の模倣と自己蒸留にも適用した
決められた正解に倣って学ぶ教師ありファインチューニング、つまり正解例を基準にモデルを調整する学習でも効果が見られた。30億パラメータのLlamaモデルの知識評価であるMMLU-Proの平均精度は、削除チューニングが22.28%、全面ファインチューニングが21.19%だった。推論評価のBBEHでは、両方式の平均精度が同じだった。
モデル自身が生成した回答上で教師の次トークン予測に倣う自己蒸留、つまり教師モデルの予測を生徒モデルに伝える学習では、70億パラメータのQwenモデルでツール使用と科学問題を学習した。研究チームは両タスクで全面ファインチューニングに匹敵する結果を報告し、ツール使用精度は削除チューニングが69.07%、全面ファインチューニングが68.04%、科学問題の精度はそれぞれ70.61%、71.20%だった。教師ありファインチューニングと自己蒸留で、削除マスクは全面ファインチューニングのチェックポイントの600~4700分の1のサイズだった。
複数回回答を生成する評価でも新たな問題を解いた。温度1.0で問題ごとに128個の回答を生成したとき、80億パラメータのLlamaモデルのGSM8K解決率は削除チューニングが99.62%、基本モデルが95.29%だった。これは1回の回答の精度ではなく、複数の試行のうちに問題を解けた割合だ。
4. 小さな保存容量の代償は学習メモリだ
主な強化学習の比較で、削除チューニングのマスクは全面ファインチューニングのチェックポイントの3600~4700分の1のサイズだった。タスクを切り替える際は、小さなマスクを読み込み、元の重みに適用できる。保存負担が減っても、学習中は対象の重みごとに学習変数を設けるため、学習メモリは全面ファインチューニングより少なく、LoRAより多い。
以前のタスクの維持も利点だ。三つのサイズのLlamaモデルで、六つのタスクの平均精度が強化学習を通じて基本モデルとの差1%ポイント以内にとどまった。一方、LoRAと、無作為に選んだ一部の重みだけを変更する学習は、最大5.4%ポイント低下した。
複数のタスクを順に継続学習する実験は、今後の課題として残っている。今回のマスクはゲート投影の個々の重みを削除する方式であり、一定のまとまりで削除してモデルの適応と圧縮を同時に実現する方式も、今後の課題として示された。
5. 最初の削除位置より学習しながら選ぶ過程が重要だった
Wandaスコアで削除位置を一度選んだ結果は、六つのモデルで基本モデルとの差が2.4%ポイント以内だった。同じWandaスコアを出発点としてマスクを学習すると、基本モデルを最大53.2%ポイント上回った。初期の削除位置だけでは得られなかった改善が、学習過程から生まれたという分析だ。
研究チームは、重みの変化がどれほど多様な方向に広がるか、元の行列の構造をどれほど変えるか、主要な重みにどれほど手を加えるかも比較した。この三つの指標を合わせて見ると、削除チューニングはLoRAや無作為な疎ファインチューニング、つまり一部の重みだけを選んで調整する学習よりも、全面ファインチューニングに近かった。少数の重みを削除するだけでも、変化の形は全重みを学習するときに似ることがあるという説明だ。
削除チューニングの実用的な価値は、大規模モデルの事後学習精度に近づきながら、タスクごとの保存負担と以前のタスクの性能損失をともに減らす点にある。