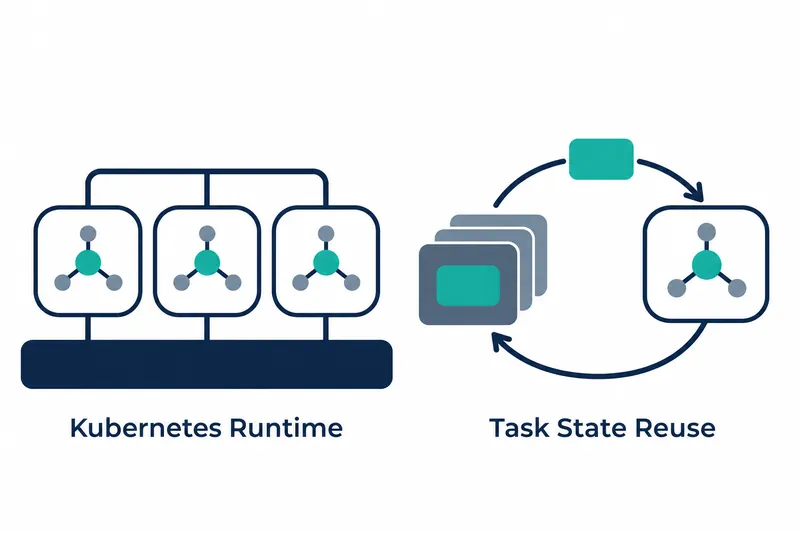
NVIDIAは、Kubernetes上でエージェント環境を素早く停止して再利用するオープンソースのランタイム、つまりプログラムの実行環境であるAgent Substrateを公開した。エージェントプラットフォームの運用者は、待機中の各セッションに作業用リソースを割り当て続ける代わりに、セッションの状態を保存できる。これにより、作業を処理する実行単位を集めた小規模なワーカープールを、複数のセッションで共有する構成にできる。
1. セッションごとにワーカーを割り当てる無駄を減らす
エージェントは、コマンドの実行やファイルの修正後、モデルの応答や人の入力を待つことを繰り返す。このとき、ファイルやプロセス、作業ディレクトリは次の段階まで維持する必要がある。しかし、セッションごとにKubernetesの作業実行単位であるPodを起動し続けると、待機中もメモリを占有する。毎回新しいPodを作る場合は、作業を実行するコンピューターを決める配置処理や、イメージとネットワークの準備に数秒かかることがある。
コーディング支援ツールは、モデル呼び出しとリポジトリ操作を行き来しながら環境を維持する必要がある。多数のセッションに専用の実行環境を1つずつ割り当てるのではなく、停止した作業の状態を保存して再開する仕組みが必要な理由だ。
学習済みモデルをさらに訓練する強化学習の事後学習では、コード実行器やシミュレーターなど、CPU中心の環境にリクエストがまとまって集中する。NVIDIAによると、規模は初期実験の数百から、運用段階の数十万の環境にまで拡大し得る。最も遅い環境が次の学習バッチの準備完了時点を決めるため、環境の新規作成による遅延はGPUの待機につながる。
2. アイドル状態を保存し、空きワーカーで復元する
Agent Substrateは、準備済みのKubernetesワーカーPod群の上に、リソース割り当てと状態管理を担う独立した制御レイヤーを置き、多数のエージェント環境をより小規模なワーカープールに接続する。隔離された実行空間であるサンドボックスには、gVisorや、仮想化で隔離した小さなコンピューター環境であるマイクロ仮想マシンを使う。環境がアイドル状態になるとメモリとファイルシステムの状態を保存し、ワーカーを返却する。次の呼び出し時には、空きワーカーで保存済みの状態から作業を再開する。
復元時は新しいPodの作成手順を経由しない。ワーカー自体は通常のKubernetes Podなので、クラスターの配置とクォータのポリシーは引き続き適用される。同社の発表によると、このランタイムは標準コンテナの10倍の密度で、数百万のエージェントとツールを実行するよう設計されている。
3. 飽和時の待機とサンドボックス内のリソース競合に対処する
ワーカーがすべて使用中の場合、新しいリクエストを即座に失敗させる代わりに、一定の上限内で待機させ、ワーカーが空いたら再開を試みる機能が開発された。これを担うのは、リクエストを適切な実行先に転送するコンポーネントであるルーターだ。すでに実行中の環境へのリクエストが、処理前のリクエストが順番に待つリストであるキューに閉じ込められないようにする追加の改善も紹介された。
サンドボックスには、ログ記録や、他のサービスに代わってリクエストを転送するプロキシ、メトリクス収集を担う補助コンテナを含めることができる。マイクロ仮想マシンのサンドボックスにコンテナごとのCPUとメモリ制限を適用すれば、あるコンテナがメモリ上限を超えたとき、そのコンテナだけを停止し、残りの環境は実行を続けられる。
研究者がコードのコンパイルや計算を行うGPUサンドボックスを、停止してから復元する設計も提案された。デバイス提供者が安全な停止方法と復元に必要なデバイス特性を提供すると、ランタイムはそれらを保存し、条件に合うデバイスに復元する。NVIDIA GPUが最初の対応対象となる。
4. 推論状態を環境管理にフィードバックする
Agent Substrateがエージェントのツール利用環境を管理する一方、NVIDIA Dynamoは、学習済みモデルがGPU上で結果を出す処理であるモデル推論を調整する。Dynamoルーターは、以前のモデル呼び出しの計算結果を格納したKVキャッシュの位置と、GPUワーカーの混雑度を把握する。セッションを区別する値であるセッション識別子や、ツール呼び出しの境界などの情報も活用し、後続のモデルリクエストを調整できる。
連携の要点は、推論側の進行情報をエージェント環境の管理にフィードバックすることだ。Dynamoは、最初のトークンまでの予測時間、リクエストの進行度、キャッシュの準備状況、利用可能なリソースが使われている度合いを示すGPUプールの飽和度などのシグナルを提供できる。Agent Substrateは、これらを基に、環境を維持するか、長い推論待ちの間に保存するか、モデルの応答が近づいた時点で再起動するかを決めるよう設計された。環境を常時起動するコストと、毎回再起動する遅延を同時に減らす取り組みだ。
5. 効率改善にはレイヤー間の調整が伴う
アイドルセッションによるワーカーの占有をなくし、状態を再利用すれば、CPUとメモリの無駄や段階ごとの再起動の負担を減らせる。一方、運用者は、環境の実行と推論をそれぞれ管理する2つのレイヤーのシグナルとリソース運用を合わせる必要がある。リソースを起動し続けるコストを減らす分、状態の保存と再開のタイミングを調整することが重要になる。
GPU状態の復元はおおむね同じGPUモデルで可能であり、ドライバーのバージョンまで一致する必要がある場合もあるため、条件に合うデバイスがなければ新規に起動する。NVIDIAは、APIが引き続き変更されており、新しいKubernetesのリソース割り当て基盤上でGPU対応を再構築しているほか、Dynamoとの一部の連携は実験段階だと明らかにした。
Agent Substrateは、Cloud Native Computing Foundation(CNCF)のサンドボックスプロジェクトとして寄贈された独立したオープンソースだ。NVIDIA Dynamoは推論を担い、KAI SchedulerはワーカーPodを配置し、Agent Substrateは状態を持つエージェント環境を管理する。ワーカーPodは通常のKubernetes Podなので、GPU学習プロセスや推論サーバーと並べて配置できる。
Agent Substrateの価値は、作業状態の保存を推論の進行情報と結び付け、エージェントの待ち時間を、共有リソースを使い回す機会に変える点にある。