百度は長い文書をページごとに分けて送るのではなく、1回のリクエストで解析する文書認識モデルUnlimited OCR 2を公開した。複数ページにまたがる表や文章のつながりを処理したい開発者は、文書全体を入力し、ページ間の文脈を活用できる。
1. 必要な部分だけを参照し、ページ群を再利用する
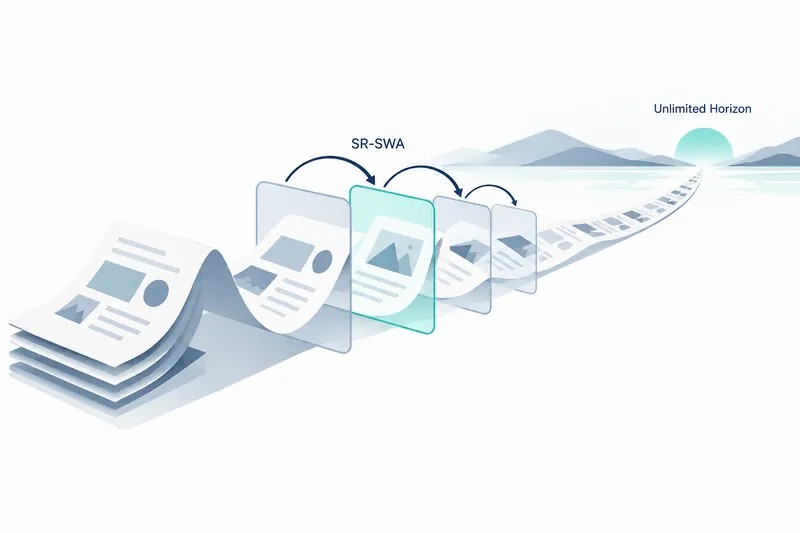
従来のUnlimited OCRはテキストの作業メモリを一定に保つ設計だったが、文書が長くなるほど、生成の各段階で全ページの視覚情報を再び参照する必要があった。新モデルは関連情報だけを選んで参照する疎参照スライディングウィンドウアテンション(SR-SWA)で、この負担を減らす。文書の全内容を同じ強さで振り返る代わりに、現在のページに関係する一部の参照情報に集中する方式だ。
文書全体をGPUメモリに載せ続ける負担は、別の逐次処理方式で減らす。境界ページが重なるページ群に文書を分けて処理し、境界での以前の計算結果を保存したKVキャッシュを再利用しつつ、現在のページ群の外にあるキャッシュを解放する。1回のリクエストを受け取り、内部では本のページをめくるように必要なページ群だけをメモリに残す方式だ。
2. ページ画像を順番にまとめて渡す
開発者はTransformersで手軽に試せるほか、サービス運用には百度が推奨するSGLangを使える。複数のページ画像ファイルを順番に渡すと、1回のリクエストで文書全体を解析し、ページ間の文脈も活用する。
リポジトリの複数ページの例を示す。
pages = [f"your_doc/page_{i}.jpg" for i in range(1, 8)]

text, num_tokens = model.infer_multi(tokenizer, image_files=pages,
                                     output_path="output/multi", save_results=True)
百度はPython 3.10とPyTorch 2.13.0でテストした。
テストに使ったモデルライブラリはTransformers 4.52.1で、GPUはNVIDIA A800 80GBだ。
モデルの生の出力はMarkdownではなく、文書要素を区別して格納した構造化ブロック文字列だ。リポジトリの後処理ツールでページマーカー、見出しレベル、表、座標を整理し、評価用のMarkdownに変換する。
3. 100ページ規模の評価で比較モデルより高いスコアを記録した
百度が公開したMarathonDocBenchは、103~300ページの文書100件と、位置と種類を示す注釈付きレイアウト要素約20万個を含む。総合スコアは文字認識だけでなく、表や数式、読み順、ページをまたぐ構造などを併せて評価する。同社発表によるとUnlimited OCR 2は77.06で、比較モデルで最高のKimi-K3の33.74を上回った。
表:MarathonDocBench総合スコア
条件:MarathonDocBenchの100文書(103~300ページ)、技術報告書の表2にあるモデル別評価結果、同社発表による
単位:スコア(%)
| モデル | 総合スコア(%) |
|---|---|
| Unlimited-OCR 2 | 77.06 |
| Kimi-K3 | 33.74 |
| Gemini-3.8-Flash | 28.61 |
| Qwen-3.8-Flash-Next | 27.83 |
| Gemini-3.1-Pro Preview | 26.97 |
| Qwen3.8-Max | 22.93 |
| Minimax-M3 | 17.97 |
| DeepSeek-4.1-Flash | 12.34 |
| GLM-5.3-Flash | 7.51 |
ページをまたぐ文章や表が豊富な評価で得た結果である点が重要だ。同社発表によると、最大30ページを扱う別の評価MPDocBenchでも総合スコア84.59を記録した。
4. メモリはページ群で抑え、運用負担は設定と変換に移す
同社発表によると、100ページ規模で1段階ずつ結果を生成するデコーディング速度は、フルアテンションの7.0倍、従来の参照方式R-SWAの5.6倍だった。ページ画像をタイルという小さな断片に分割して処理するガンダムモードで、同時に処理する入力数を示すバッチサイズ3、ページ当たりの生成量1,024トークンで測定した結果だ。
同報告書のMarathonDocBench測定では、単一リクエストのKVキャッシュのピークメモリ使用量は、標準デコーディングの47.00GBからページ群の逐次処理の1.77GBに減った。同時リクエスト16件の条件では、スループットが毎秒360トークンから1,315トークンに増えたと同社は発表した。
開発者は長い文書を1回のリクエストで渡し、GPUメモリの負担を減らせる。一方、サービスへの統合では、ページ群のサイズと出力予算を文書に合わせて調整し、構造化出力を必要な形式に変換する作業を担うことになる。
5. 単一ページの最高スコアより長文処理に重点を置いた
単一ページの評価では、同社発表によると以下の比較モデル2つのスコアがより高かった。長文文書の処理とは異なる選択基準を示している。
表:単一ページの総合スコア
条件:技術報告書の表3にあるOmniDocBench v1.6の評価結果、同社発表による
単位:スコア(%)
| モデル | 総合スコア(%) |
|---|---|
| Unlimited-OCR 2 | 94.02 |
| OvisOCR2 | 96.47 |
| TeleOCR | 96.91 |
小さなページ群はピークメモリを抑えるが、境界をまたぐブロックの文脈が途切れ、結合品質に影響する可能性がある。報告書は、疎アテンションが文書全体の情報を保持できず、見出し階層のような文書レベルの構造理解にも限界があると説明している。
Unlimited OCR 2は文書の長さに伴う段階ごとの計算負担を抑え、複数ページの解析を単一リクエスト型のサービスへ移行することに重点を置いたモデルだ。