XeStrata xe0.1.43.1 于 UTC 10 月 12 日 20:19、韩国时间 10 月 13 日凌晨发布。这是一个让 Intel GPU 上 Qwen3.8-Flash-Next 的预填充回到原有路径的热修复。
预填充是模型读入整个提示的阶段。据维护者说明,xe0.1.43 在 Intel Arc GPU 上没有用矩阵引擎(XMX),而是用较慢的 DP4a 路径执行这一阶段,在 Arc Pro B70 的 32K 下慢了约三分之一。
在 Arc Pro B70、IQ3_XXS 量化、32K 条件下,xe0.1.43 的 1,590 tok/s 在 xe0.1.43.1 中变为 2,415 tok/s,答案与 xe0.1.43 之前相同。这是维护者一方的回退对比,既不是独立复现,也不是所有受支持 GPU 的数据。
更早修复的软件包机器码调换
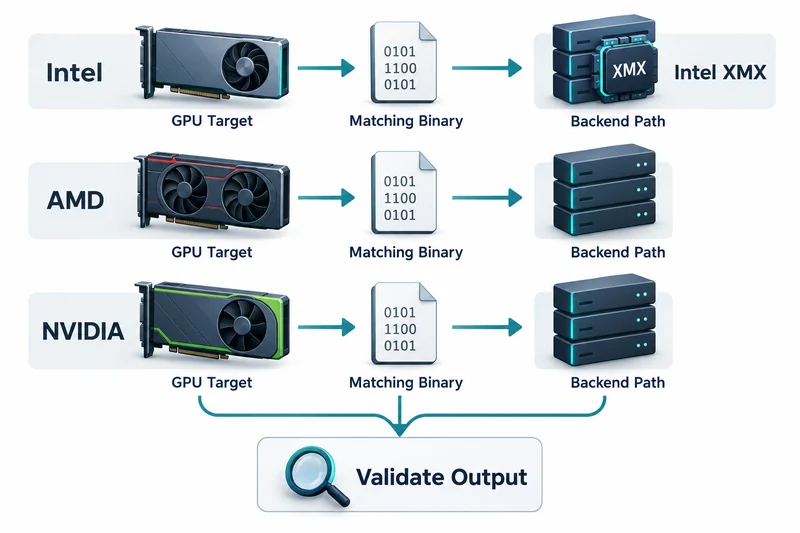
UTC 10 月 11 日发布的 xe0.1.42 修复的是性质不同的缺陷。由于构建软件包的编译器(intel/llvm)存在缺陷,部分 GPU 目标的位置被放入了其他 GPU 的机器码。
明确列出的情况是 AMD gfx1030、gfx1101、gfx1201 等以及 NVIDIA sm_80、sm_86、sm_89 被相互调换。这类名称是编译器为特定 GPU 代际生成机器码时使用的目标标记。
在这些 GPU 上,引擎可能停止运行(RX 9070 XT 上的 ILLEGAL_INSTRUCTION)、运行缓慢或给出错误答案。项目表示,已确认用修正后的编译器构建的软件包中装入了与各 GPU 相符的机器码。
打包缺陷与路径选择缺陷的区别
xe0.1.42 的问题是与设备相符的代码有没有被放进软件包,xe0.1.43.1 的问题则是运行时在多条路径中选了哪一条。
正确的二进制文件也可能选择慢速路径,而开启加速路径也修不好按错误目标构建的软件包。
所以,只有版本号和 tok/s 数字、缺少 GPU 和后端信息的报告,很难区分这两种缺陷。
各厂商不同的矩阵加速硬件
根据项目文档,XeStrata 面向 Linux 上的一块 Intel Arc、AMD Radeon(RDNA2 或更新)或 NVIDIA GPU。矩阵运算在 Intel 上用 XMX、在 AMD(RDNA3 或更新)上用 WMMA、在 NVIDIA 上用张量核心,没有矩阵引擎的 GPU 则使用 DP4a 等整数点积指令。
在 AMD 上,预填充的稠密矩阵乘法由发行版的 ROCm rocBLAS 和 hipBLASLt 执行。ROCm 是 AMD GPU 的运行时与库集合,文档写明该表中只确认过 RX 9060 XT(gfx1200)。
也就是说,这些不是同一种加速器在不同厂商那里的不同叫法,而是不同的硬件功能。这也是 Intel 路径恢复的消息难以推及其他厂商显卡性能预期的原因。
注意事项:引用数字的条件与对话保存的兼容性
在热修复与上游的对比中,RTX 4070 和 RX 9060 XT 仍标注为测量中。从 1,590 到 2,415 tok/s 的回退对比,也与同一发布中的上游 Strata 对比是不同的实验。
由于版本变化,旧版本用 --conversation-save 保存的对话将无法读取。
发布说明中的安装步骤是先用校验和确认下载的软件包,再检查设置。
sha256sum -c SHA256SUMS --ignore-missing
xestrata --setup
如果缺少 GPU 库或 render 组,xestrata --setup 会输出安装命令并停止;运行该命令后再次执行 setup 即可。
更新前应留下的记录
先记录当前的软件包版本、模型文件、GPU 架构和运行时库,更新后就更容易分辨哪里发生了变化。
保留之前的配置和几个有代表性的提示,也可以比较答案是否发生了变化。
把预填充和生成分开比较
只有用相同的模型和相同的输入长度分别测量预填充和生成速度,这类路径回退才会显现。把两者混在一起的单个数字,无法看出是哪个阶段变慢了。
本文基于对发布说明和项目文档的阅读整理而成,没有亲自运行 XeStrata,也没有验证 GPU 组合。
XeStrata 的两次修复针对的是不同层面的问题:软件包是否装有正确的机器码,以及运行时是否选择了矩阵引擎路径,仅凭速度数字,哪一点都看不出来。