XeStrata xe0.1.43.1がUTCで10月12日20:19、韓国時間で10月13日未明に公開された。Intel GPUでのQwen3.8-Flash-Nextのプリフィルを元の経路に戻すホットフィックスだ。
プリフィルは、モデルがプロンプト全体を読み込む段階だ。メンテナーの説明によると、xe0.1.43はIntel Arc GPUでこの段階を行列エンジン(XMX)ではなく遅いDP4a経路で動かし、Arc Pro B70の32Kで約3分の1遅くなっていた。
Arc Pro B70、IQ3_XXS量子化、32Kの条件で、xe0.1.43の1,590 tok/sがxe0.1.43.1では2,415 tok/sになり、答えもxe0.1.43より前と同じだという。メンテナー側の退行比較であり、独立した再現でも、すべての対応GPUの数値でもない。
それより前に直されたパッケージ内の機械語の入れ替わり
UTCで10月11日に出たxe0.1.42は、性質の異なる欠陥を直した。パッケージをビルドするコンパイラ(intel/llvm)のバグで、一部のGPUターゲットの位置に別のGPU用の機械語が入っていた。
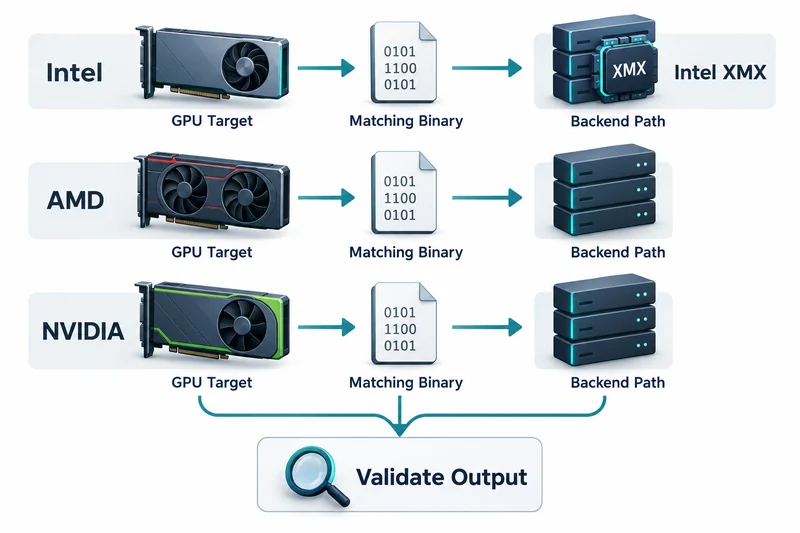
明記されたのは、AMDのgfx1030、gfx1101、gfx1201などと、NVIDIAのsm_80、sm_86、sm_89が入れ替わったケースだ。こうした名前は、コンパイラが特定のGPU世代向けの機械語を作るときに使うターゲットの表記だ。
該当するGPUでは、エンジンが止まる(RX 9070 XTでのILLEGAL_INSTRUCTION)、遅く動く、誤った答えを出すことがあった。プロジェクトは、直したコンパイラで作ったパッケージにGPUごとの機械語が正しく入っていることを確かめたと説明している。
パッケージングの欠陥と経路選択の欠陥の違い
xe0.1.42はデバイスに合うコードがパッケージに入ったかの問題で、xe0.1.43.1は実行中に複数の経路のうちどれが選ばれたかの問題だった。
正しいバイナリでも遅い経路を選ぶことはあり、加速経路を有効にしても、誤ったターゲットでビルドされたパッケージは直らない。
そのため、バージョン番号とtok/sの数字だけでGPUやバックエンドの情報がない報告では、2つの欠陥を見分けにくい。
ベンダーごとに異なる行列演算ハードウェア
プロジェクトのドキュメントによると、XeStrataはLinux上の1枚のIntel Arc、AMD Radeon(RDNA2以降)、NVIDIA GPUを対象にする。行列演算はIntelではXMX、AMD(RDNA3以降)ではWMMA、NVIDIAではテンソルコアで動き、行列エンジンのないGPUはDP4aなどの整数内積命令を使う。
AMDでは、プリフィルの密な行列積はディストリビューションのROCm rocBLASとhipBLASLtで動く。ROCmはAMD GPU向けのランタイムとライブラリの集まりで、ドキュメントはその表でRX 9060 XT(gfx1200)だけを確認したと書いている。
つまり、同じアクセラレーターをベンダーごとに別の名前で呼んでいるのではなく、異なるハードウェア機能だ。Intelの経路が戻ったという知らせを、他のベンダーのカードの性能への期待に移しにくいのはこのためだ。
注意点:数値を引用する条件と保存した会話の互換性
ホットフィックスのupstreamとの比較では、RTX 4070とRX 9060 XTはまだ測定中のままだ。1,590から2,415 tok/sへの退行比較も、同じリリースにあるupstreamのStrataとの比較とは別の実験だ。
バージョンが変わったため、以前のバージョンの--conversation-saveで保存した会話は読み込まれない。
リリースノートのインストール手順は、ダウンロードしたパッケージをチェックサムで確かめてから設定を点検する順番だ。
sha256sum -c SHA256SUMS --ignore-missing
xestrata --setup
xestrata --setupは、GPUライブラリやrenderグループが足りなければインストールするコマンドを表示して止まるので、そのコマンドを実行してからもう一度setupを実行する。
更新前に残しておく記録
現在のパッケージのバージョン、モデルファイル、GPUアーキテクチャ、ランタイムライブラリを先に記録しておけば、更新後に何が変わったかを見分けやすい。
以前の設定と代表的なプロンプトをいくつか残しておけば、答えが変わったかどうかも比べられる。
プリフィルと生成を分けて見る比較
同じモデルと同じ入力長でプリフィルと生成の速度を別々に測って初めて、今回のような経路の退行が表れる。2つを混ぜた1つの数字では、どの段階が遅くなったかは分からない。
この記事はリリースノートとプロジェクトのドキュメントを読んでまとめたもので、XeStrataを実際に動かしたり、GPUの組み合わせを検証したりはしていない。
XeStrataの2つの修正は、パッケージに正しい機械語が入っているかと、実行中に行列エンジンの経路が選ばれているかという別々の層の問題であり、速度の数字だけではどちらも見えてこない。