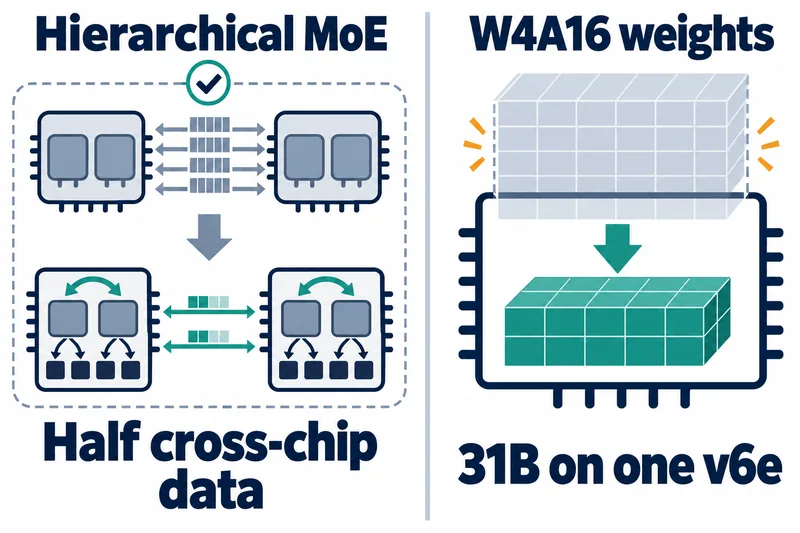
vLLM 项目于 10 月 8 日发布的 TPU Inference v0.31.0 新增了减少 MoE 通信量的分层分发,以及 JAX 路径的 compressed-tensors W4A16 线性运算。
前者减少分布在多颗芯片上的专家模型的数据传输,后者让低比特权重模型能够装入内存。分层分发也已支持与 FP8 all-gather 配合使用。
这两项功能针对不同的瓶颈。MoE 对每个输入只计算部分专家,耗时不仅来自计算,也来自向专家发送数据的芯片间通信。
相比之下,Gemma 4 31B 案例首先要解决的是模型能否装入内存。W4A16 开发 PR 涉及在训练中考虑量化误差的 QAT 模型。该 PR 表示,采用 16 位浮点格式 bf16 的模型无法装入单颗 v6e 芯片。
由两个核心分担的芯片间传输
分层分发让芯片上的两个核心分别从其他芯片收集一半输入特征,再在芯片内部交换剩余部分。PR 作者表示,这种结构将芯片间传输量减半。
适用范围是将专家分布到多个设备的专家并行(EP)分组矩阵乘法(GMM)路径。配置条件是同一芯片的两个核心在模型轴上配对,且输入特征宽度 hidden 为 256 的倍数。
配置名称为 MOE_HIERARCHICAL_DISPATCH,默认关闭。不满足支持条件时会回退到原有路径。
PR 作者在 v7x-32 上测量了 Qwen3.8-2.4T-A95B-FP8。配置结合了拆分张量运算的 tp=4,以及分担注意力请求处理的 attn_dp=8。在逐个生成 Token 的解码过程中,每步分发耗时从 11.7ms 降至 7.2ms。
但完整解码步骤的耗时从 89.5ms 降至 85.5ms,缩短了 4.5%。这是 PR 作者的性能剖析测量结果,并非对公开说明所链接的内部追踪资料也进行了独立验证。
FP8 all-gather 兼容性 PR 提供了另一组比较。在使用 FP8 汇集多颗芯片数据的配置下,v7x-32 的解码批大小为 384 时,耗时从 77.38ms 降至 74.10ms,减少了 4.2%。
这组比较的基准值取自 PR #3665。它与前述 4.5% 的基准不同,因此不能将两项改善比例相加。
同一 PR 报告,GSM8K 数学题评测得分从 0.978 小幅降至 0.9773。关于数据传输路径输出逐位一致的说明,不能延伸为对 FP8 组合质量的保证。
容纳 31B 模型的 4 位权重支持范围
W4A16 以 4 位存储权重,以 16 位处理层间传递的激活值。此次 JAX 实现支持 compressed-tensors 的 pack-quantized 格式中的对称 int4 权重,不单独量化激活值。
支持范围包括为每组权重设定量化基准的 group 方式,以及按通道设定基准的 channel 方式。权重在高带宽内存 HBM 中保持 int4 格式,gmm_v2 内核仅在芯片内部工作内存中还原计算所需的片段。不支持非对称格式、8 位格式或 actorder=group。
支持线性运算与支持 int4 MoE 专家是两回事。在此 PR 中,compressed-tensors 中除 FP8 以外的 MoE 量化方式会在加载模型时报错。
PR 作者报告,Gemma 4 31B QAT W4A16 在单颗 v6e 芯片上占用 21.67 GiB HBM,输出吞吐量达到 500 Token/秒。
测量条件为 16 个并发请求,每个请求固定输出 256 个 Token,并使用 ignore_eos 忽略结束 Token。最大模型长度为 2048,最大并发序列数为 16,结果取三次运行的中位数。
不过,测量所用镜像包含 vLLM 0.29.1rc1.dev468。这是为功能提供依据的开发 PR 资料,而非针对最终 v0.31.0 重新测量的结果。
能够装入内存不代表质量相同。在 PR 作者公开的 3,880 项标签识别评测中,bf16 → W4A16 的得分分别为 E2B 68.5% → 65.7%、E4B 73.1% → 71.4%、12B 76.0% → 75.0%。
作者报告的差值分别为 −2.8、−1.6、−1.0 个百分点。E4B 的差值采用原文报告值,并非根据四舍五入后的分数重新计算。
31B W4A16 的得分为 77.6%,但没有可供比较的 bf16 得分。评测资料的构成和可复现性也未经独立审查,因此仅凭这些数值无法判断 31B 是否保持了质量。
PR 作者的报告值。在 3,880 条公开评测记录上,与使用同一 vLLM 运行镜像提供服务的 bf16 检查点逐条比较。括号内为 95% 自助法区间。
| 模型 | bf16 | W4A16 | 差值(百分点) |
|---|---|---|---|
| E2B | 68.5% | 65.7% | −2.8 (−4.0 至 −1.6) |
| E4B | 73.1% | 71.4% | −1.6 (−2.5 至 −0.9) |
| 12B | 76.0% | 75.0% | −1.0 (−1.7 至 −0.3) |
| 31B | — | 77.6% | — |
启动时间也是成本。PR 报告,该路径的编译耗时约为 XLA 路径的 2.7 倍,31B 首次编译约需 27 分钟,保留 JAX 编译缓存时约需 9 分钟。
作者还观察到,在较小的投影运算中 bf16 更快。所有 W4A16 服务性能测量均在单颗 v6e 芯片上完成,未测试通过张量并行使用多颗芯片的 TP>1 配置,也未测试 v5e。
MoE 方面,更重要的数字是完整步骤耗时缩短 4.5%,而非通信量减半。即使大幅减少数据传输,其余计算仍然耗时,因此没有依据期待整体吞吐量按同样比例提升。
W4A16 的 31B 结果更接近运行可行性的变化,而不是速度竞争。由于 bf16 无法装入同一颗芯片,500 Token/秒并非相对 bf16 的加速比例,而是在指定并发请求条件下可达到的吞吐量。
因此,MoE 服务运营者更适合评估自身的通信瓶颈和并行配置;内存不足的运营者则可另行权衡检查点兼容性,以及质量和启动时间的代价。
分发适用条件与检查点格式核对
评估分层分发时,除了 MOE_HIERARCHICAL_DISPATCH 是否开启,还可一并核对 EP GMM 路径、两个核心在模型轴上的布局,以及 hidden 为 256 倍数的条件。不满足条件便回退到原有路径,是核对时的判断依据。
W4A16 可先核对检查点是否采用对称 int4、是否为 pack-quantized 格式,以及是否涉及不支持的选项。分组宽度小于该芯片矩阵运算单元(MXU)的列宽时使用 gmm_v2,否则或采用按通道方式时使用 XLA 量化矩阵乘法路径。后者在输入维度跨设备拆分的层中无法拆分量化尺度,因此会报错。
不过,仅凭公开依据,还无法给出用于判断是否实际启用的运行命令或日志字符串。这里的核对仅限于将文档记载的支持条件与自身配置进行比较。
接下来值得关注的是分层分发在实际服务负载下的效果,以及 W4A16 的多芯片扩展能力。目前公开资料支持的范围,是特定配置下的通信改善,以及单颗芯片容纳模型的可行性。
v0.31.0 的价值不在于让所有模型都更快,而在于扩大了受支持条件下分别缓解 MoE 通信瓶颈和模型内存瓶颈的选择。