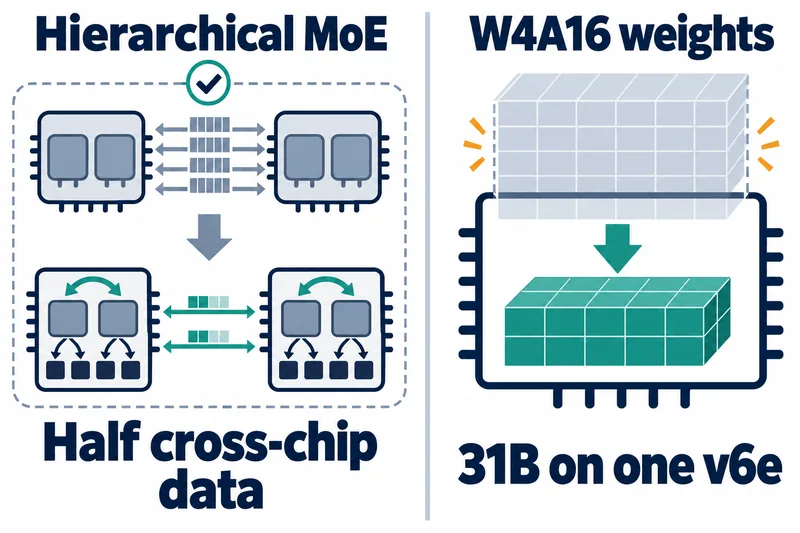
vLLMプロジェクトが10月8日に公開したTPU Inference v0.31.0は、MoE通信量を減らす階層型分配と、JAX経路のcompressed-tensors W4A16線形演算を追加した。
前者は複数チップに分散したエキスパートモデルのデータ移動を減らし、後者は重みを低ビットで保存したモデルをメモリに収める機能だ。階層型分配はFP8 all-gatherとも併用できるようになった。
両機能が対象とするボトルネックは異なる。入力ごとに一部のエキスパートだけを計算するMoEでは、演算だけでなく、エキスパートにデータを送るチップ間通信にも時間がかかる。
一方、Gemma 4 31Bの事例は、モデルがメモリに収まるかどうかが出発点だった。量子化誤差を学習に織り込むQATモデルを扱ったW4A16の開発PRによると、16ビット浮動小数点形式のbf16モデルはv6eの1チップに収まらなかった。
チップ外への転送を分担する2つのコア
階層型分配では、チップ内の2つのコアがそれぞれ入力特徴の半分を他のチップから集め、残りをチップ内で交換する。PR作成者は、この構造でチップ間転送量を半減させたと説明している。
適用対象は、エキスパートを複数デバイスに分散するエキスパート並列化(EP)のグループ化行列積(GMM)経路だ。モデル軸で同じチップの2つのコアが対をなし、入力特徴の幅であるhiddenが256の倍数となる構成が条件だ。
設定名はMOE_HIERARCHICAL_DISPATCHで、デフォルトは無効だ。対応条件を満たさない場合は従来の経路に戻る。
PR作成者はQwen3.8-2.4T-A95B-FP8をv7x-32で測定した。構成は、テンソル演算を分割するtp=4と、アテンション要求を分散処理するattn_dp=8の組み合わせだ。トークンを逐次生成するデコード中の分配時間は、1ステップ当たり11.7msから7.2msに短縮された。
ただし、デコードステップ全体では89.5msから85.5msへの短縮で、改善幅は4.5%だった。これはPR作成者によるプロファイル測定であり、公開説明からリンクされた内部トレース資料まで独立に検証した結果ではない。
FP8 all-gatherとの互換性を追加したPRは、別の比較を示している。複数チップのデータ収集にFP8を使う構成では、v7x-32のデコードバッチサイズ384で、所要時間が77.38msから74.10msへ4.2%短縮された。
この比較の基準値はPR #3665から引用した値だ。前述の4.5%とは基準が異なるため、両方の改善率を足し合わせることはできない。
同じPRは、GSM8Kの数学問題評価スコアが0.978から0.9773へわずかに低下したと報告している。データ移動経路の出力がビット単位で一致するという説明を、FP8との組み合わせにおける品質保証にまで広げることはできない。
31Bを収める4ビット重みの対応範囲
W4A16は重みを4ビットで保存し、層間で受け渡す活性値を16ビットで扱う方式だ。今回のJAX実装は、compressed-tensorsのpack-quantized形式で対称int4重みに対応し、活性値は別途量子化しない。
対象は、重みのグループごとに量子化基準を設けるgroup方式と、チャネルごとに基準を設けるchannel方式だ。重みは高帯域幅メモリのHBMにint4のまま保持され、gmm_v2カーネルが演算に使う部分だけをチップ内の作業メモリで復元する。非対称形式、8ビット形式、actorder=groupには対応しない。
線形演算への対応とint4のMoEエキスパートへの対応は別だ。このPRでは、compressed-tensorsのFP8以外のMoE量子化方式は、モデル読み込み時にエラーとなる。
PR作成者は、Gemma 4 31B QAT W4A16がv6eの1チップでHBMを21.67 GiB使用し、出力スループット500トークン/秒を記録したと報告した。
条件は同時リクエスト16件、リクエスト当たりの出力を256トークンに固定し、終了トークンを無視するignore_eosを使用したものだ。最大モデル長は2048、最大同時シーケンス数は16で、3回の実行の中央値である。
ただし、測定用イメージにはvLLM 0.29.1rc1.dev468が含まれる。最終版v0.31.0を改めて測定した結果ではなく、機能の根拠となる開発PRの資料だ。
メモリに収まることは、同じ品質を意味しない。PR作成者が公開したラベル読み取り評価3,880件では、bf16 → W4A16のスコアはE2Bが68.5% → 65.7%、E4Bが73.1% → 71.4%、12Bが76.0% → 75.0%だった。
作成者が報告した差は、それぞれ−2.8、−1.6、−1.0パーセントポイントだ。E4Bの差は、丸められたスコアから再計算した値ではなく、原文の報告値である。
31B W4A16のスコアは77.6%だが、比較対象となるbf16のスコアはない。評価データの構成と再現性を独立に監査した結果でもないため、この数値だけで31Bの品質が維持されているかは判断できない。
PR作成者の報告値だ。公開評価3,880件で、同じvLLM実行イメージで提供したbf16チェックポイントとレコードごとに比較した。括弧内は95%ブートストラップ範囲である。
| モデル | bf16 | W4A16 | 差(ポイント) |
|---|---|---|---|
| E2B | 68.5% | 65.7% | −2.8 (−4.0~−1.6) |
| E4B | 73.1% | 71.4% | −1.6 (−2.5~−0.9) |
| 12B | 76.0% | 75.0% | −1.0 (−1.7~−0.3) |
| 31B | — | 77.6% | — |
起動時間もコストとなる。PRによると、この経路のコンパイルはXLA経路の約2.7倍長く、31Bでは初回コンパイルに約27分、JAXコンパイルキャッシュを保持した場合に約9分かかった。
小規模な射影演算ではbf16のほうが速かったとの観察もある。W4A16のサービング測定はすべてv6eの1チップで行われ、テンソル並列化で複数チップを使うTP>1構成とv5eは試験していない。
MoE側で重要なのは、通信量の半減よりもステップ全体の4.5%短縮という数値だ。データ移動を大幅に減らしても残りの演算時間は残るため、全体のスループットも同じ割合で向上すると期待する根拠はない。
W4A16の31Bの結果は、速度競争というより実行可能性の変化に近い。bf16が同じチップに収まらなかったため、500トークン/秒はbf16に対する高速化率ではなく、明示された同時リクエスト条件で実現できるスループットを示している。
したがって、MoEの運用者は自身の通信ボトルネックと並列構成を、メモリが不足する運用者はチェックポイントの互換性と品質・起動時間のコストを、それぞれ切り分けて判断するのが妥当だ。
分配の適用条件とチェックポイント形式の確認
階層型分配を検討する際は、MOE_HIERARCHICAL_DISPATCHの有効・無効だけでなく、EP GMM経路、2つのコアのモデル軸上の配置、hiddenが256の倍数という条件を併せて照合できる。条件外では従来の経路に戻る点が確認の基準となる。
W4A16では、チェックポイントが対称int4かどうか、pack-quantized形式かどうか、非対応のオプションを含むかを先に照合できる。グループ幅が対象チップの行列演算ユニット(MXU)の列幅より小さければgmm_v2、それ以上またはチャネル単位の方式ならXLAの量子化行列積経路となる。後者は、入力次元がデバイス間で分割された層では量子化スケールを分割できず、エラーになる。
ただし、公開された根拠だけでは、適用の有無を判別する実行コマンドやログ文字列までは提示できない。ここでの確認は、文書化された対応条件を自身の構成と照合する範囲にとどまる。
次の注目点は、階層型分配が実際のサービス負荷で示す効果と、W4A16の複数チップへの拡張性だ。現時点の公開資料が裏付けるのは、特定構成での通信改善と、1チップにモデルを収められることまでである。
v0.31.0の価値は、すべてのモデルを高速化することではなく、対応条件の範囲内でMoEの通信ボトルネックとモデルのメモリボトルネックをそれぞれ緩和する選択肢を広げた点にある。