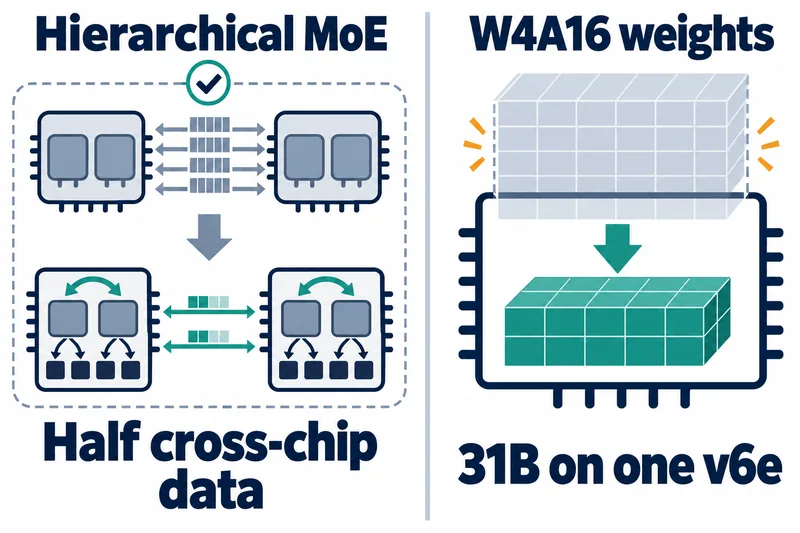
vLLM 프로젝트가 10월 8일 공개한 TPU Inference v0.31.0은 MoE 통신량을 줄이는 계층적 분배와 JAX 경로의 compressed-tensors W4A16 선형 연산을 추가했다.
전자는 여러 칩으로 나뉜 전문가 모델의 데이터 이동을 줄이고, 후자는 가중치를 낮은 비트 수로 저장한 모델을 메모리에 담는 기능이다. 계층적 분배는 FP8 all-gather와도 함께 사용할 수 있게 됐다.
두 기능이 겨냥하는 병목은 다르다. 입력마다 일부 전문가만 계산하는 MoE에서는 연산뿐 아니라 전문가에게 데이터를 보내는 칩 간 통신도 시간이 든다.
반면 Gemma 4 31B 사례의 출발점은 모델이 메모리에 들어가는지였다. 양자화 오차를 학습에 반영한 QAT 모델을 다룬 W4A16 개발 PR에 따르면, 16비트 부동소수점 형식인 bf16 모델은 v6e 한 칩에 들어가지 않았다.
칩 밖 전송을 나누는 두 코어
계층적 분배는 칩의 두 코어가 각각 입력 특징의 절반을 다른 칩에서 모은 뒤, 나머지를 칩 내부에서 교환하는 방식이다. PR 작성자는 이 구조로 칩 간 전송량을 절반으로 줄였다고 설명한다.
적용 범위는 전문가를 여러 장치에 나누는 전문가 병렬화(EP)의 묶음 행렬곱(GMM) 경로다. 모델 축에서 같은 칩의 두 코어가 짝을 이루고, 입력 특징의 너비인 hidden이 256의 배수인 구성이 조건이다.
설정 이름은 MOE_HIERARCHICAL_DISPATCH이며 기본값은 비활성화다. 지원 조건에 맞지 않으면 기존 경로로 돌아간다.
PR 작성자는 Qwen3.8-2.4T-A95B-FP8을 v7x-32에서 측정했다. 구성은 텐서 연산을 나누는 tp=4와 어텐션 요청을 나눠 처리하는 attn_dp=8의 조합이다. 토큰을 순차 생성하는 디코딩 중 분배 시간은 단계당 11.7ms에서 7.2ms로 줄었다.
하지만 전체 디코딩 단계는 89.5ms에서 85.5ms로, 4.5% 짧아졌다. 이는 PR 작성자의 프로파일 측정이며, 공개 설명에 연결된 내부 추적 자료까지 독립적으로 검증한 결과는 아니다.
FP8 all-gather 호환 PR은 별도의 비교를 제시한다. 여러 칩의 데이터를 모을 때 FP8을 사용하는 구성에서, v7x-32의 디코딩 배치 크기 384 기준 시간이 77.38ms에서 74.10ms로 4.2% 줄었다.
이 비교의 출발값은 PR #3665에서 가져온 값이다. 앞선 4.5%와 기준이 다르므로 두 개선율을 합칠 수 없다.
같은 PR은 GSM8K 수학 문제 평가 점수가 0.978에서 0.9773으로 소폭 낮아졌다고 보고한다. 데이터 이동 경로의 출력이 비트 단위로 같다는 설명을 FP8 조합의 품질 보장으로 확대할 수는 없다.
31B를 담는 4비트 가중치의 범위
W4A16은 가중치를 4비트로 저장하고, 층 사이에 전달되는 활성값은 16비트로 다루는 방식이다. 이번 JAX 구현은 compressed-tensors의 pack-quantized 형식에서 대칭 int4 가중치를 지원하며, 활성값을 별도로 양자화하지 않는다.
가중치 묶음마다 양자화 기준을 두는 group 방식과 채널별 기준을 두는 channel 방식이 대상이다. 가중치는 고대역폭 메모리인 HBM에 int4로 남고, gmm_v2 커널은 연산에 쓸 조각만 칩 내부 작업 메모리에서 복원한다. 비대칭 형식, 8비트 형식, actorder=group은 지원하지 않는다.
선형 연산 지원과 int4 MoE 전문가 지원은 별개다. 이 PR에서 compressed-tensors의 FP8 이외 MoE 양자화 방식은 모델을 불러올 때 오류로 처리된다.
PR 작성자는 Gemma 4 31B QAT W4A16이 v6e 한 칩에서 HBM 21.67 GiB를 사용하며 출력 처리량 500토큰/초를 기록했다고 보고했다.
조건은 동시 요청 16개, 요청당 출력 256토큰 고정, 종료 토큰을 무시하는 ignore_eos 사용이었다. 최대 모델 길이는 2048, 최대 동시 시퀀스는 16이며, 세 차례 실행의 중앙값이다.
다만 측정 이미지는 vLLM 0.29.1rc1.dev468을 포함한다. 최종 v0.31.0을 새로 측정한 결과가 아니라 기능을 뒷받침하는 개발 PR 자료다.
메모리에 들어간다는 사실이 같은 품질을 뜻하지는 않는다. PR 작성자의 공개 라벨 판독 평가 3,880건에서 bf16 → W4A16 점수는 E2B 68.5% → 65.7%, E4B 73.1% → 71.4%, 12B 76.0% → 75.0%였다.
작성자가 보고한 차이는 각각 −2.8, −1.6, −1.0%포인트다. E4B 차이는 반올림된 점수로 다시 계산한 값이 아니라 원문 보고값이다.
31B W4A16 점수는 77.6%지만 비교할 bf16 점수는 없다. 평가 자료의 구성과 재현성을 독립적으로 감사한 결과도 아니므로, 이 수치만으로 31B의 품질 유지 여부를 판단할 수 없다.
PR 작성자의 보고값이다. 공개 평가 3,880건에서 같은 vLLM 실행 이미지로 서빙한 bf16 체크포인트와 레코드별로 비교했다. 괄호 안은 95% 부트스트랩 범위다.
| 모델 | bf16 | W4A16 | 차이(%포인트) |
|---|---|---|---|
| E2B | 68.5% | 65.7% | −2.8 (−4.0 ~ −1.6) |
| E4B | 73.1% | 71.4% | −1.6 (−2.5 ~ −0.9) |
| 12B | 76.0% | 75.0% | −1.0 (−1.7 ~ −0.3) |
| 31B | — | 77.6% | — |
시작 시간도 비용이다. PR은 해당 경로의 컴파일이 XLA 경로보다 약 2.7배 오래 걸렸고, 31B는 처음 컴파일할 때 약 27분, JAX 컴파일 캐시를 유지했을 때 약 9분 걸렸다고 보고한다.
작은 투영 연산에서는 bf16이 더 빨랐다는 관찰도 있다. 모든 W4A16 서빙 측정은 v6e 한 칩에서 이뤄졌으며, 텐서 병렬화로 여러 칩을 쓰는 TP>1 구성과 v5e는 시험하지 않았다.
MoE 쪽에서 중요한 수치는 통신량 절반보다 전체 단계의 4.5% 단축이다. 데이터 이동을 크게 줄여도 나머지 연산 시간이 남으므로, 같은 비율의 전체 처리량 향상을 기대할 근거는 없다.
W4A16의 31B 결과는 속도 경쟁보다 실행 가능성의 변화에 가깝다. bf16이 같은 칩에 들어가지 않았으므로 500토큰/초는 bf16 대비 가속률이 아니라, 명시된 동시 요청 조건에서 가능한 처리량을 보여준다.
따라서 MoE 운영자는 자신의 통신 병목과 병렬 구성을, 메모리가 부족한 운영자는 체크포인트 호환성과 품질·시작 시간의 비용을 따로 판단하는 편이 타당하다.
분배 적용 조건과 체크포인트 형식 확인
계층적 분배를 검토할 때는 MOE_HIERARCHICAL_DISPATCH의 활성화 여부만 볼 것이 아니라 EP GMM 경로, 두 코어의 모델 축 배치, hidden의 256 배수 조건을 함께 대조할 수 있다. 조건 밖에서는 기존 경로로 돌아간다는 점이 확인 기준이다.
W4A16은 체크포인트의 대칭 int4 여부, pack-quantized 형식과 미지원 옵션을 먼저 대조할 수 있다. 그룹 너비가 해당 칩의 행렬 연산 장치(MXU) 열 너비보다 작으면 gmm_v2, 그 이상이거나 채널별 방식이면 XLA 양자화 행렬곱 경로다. 후자는 입력 차원이 장치 사이에 분할된 층에서 양자화 스케일을 나눌 수 없어 오류를 낸다.
다만 공개 근거만으로 적용 여부를 판별할 실행 명령이나 로그 문자열까지 제시할 수는 없다. 여기서의 확인은 문서화된 지원 조건을 자신의 구성과 대조하는 범위다.
다음으로 볼 지점은 계층적 분배의 실제 서비스 부하 효과와 W4A16의 여러 칩 확장성이다. 현재 공개 자료는 특정 구성의 통신 개선과 한 칩에서의 모델 수용 가능성까지 뒷받침한다.
v0.31.0의 가치는 모든 모델을 더 빠르게 만드는 데 있지 않고, 지원 조건 안에서 MoE 통신 병목과 모델 메모리 병목을 각각 줄이는 선택지를 넓힌 데 있다.