vLLM 0.31.0 于2026年10月5日加入 vllm preload,让新引擎复用已处理的 GPU 权重,避免重新加载。本文的实现说明以 v0.31.0 发布标签中的源码为准。
重启后仍能使用的已处理权重
重新拉起推理服务引擎的开销发生在任何内核运行之前。每次重启都要重复从磁盘读取检查点、进行量化后处理、按 TP rank 分片这一过程。vLLM 文档称 preload 能把重启时间从 "minutes" 缩短到 "seconds",但没有给出模型、GPU 和测量条件。
结构并不复杂。`vllm preload` 为每块 GPU 启动一个守护进程,守护进程把本 rank 的分片加载一次、完成量化后处理,再把所有参数导出为 CUDA IPC 句柄。以 `--load-format ipc_cache` 启动的引擎只在没有存储的 meta 设备上搭建模型骨架,并通过 Unix 域套接字向同一 GPU 上的守护进程请求张量。
在默认 zero_copy 模式下,引擎直接映射守护进程的 GPU 内存,每块 GPU 只保留一份权重。守护进程必须一直运行,该模式也不能与卸载权重的 sleep 模式同用。copy 模式先复制权重再释放守护进程缓存,以放弃后续复用换取独立持有权重。
为什么相同的 safetensors 头部无法区分权重
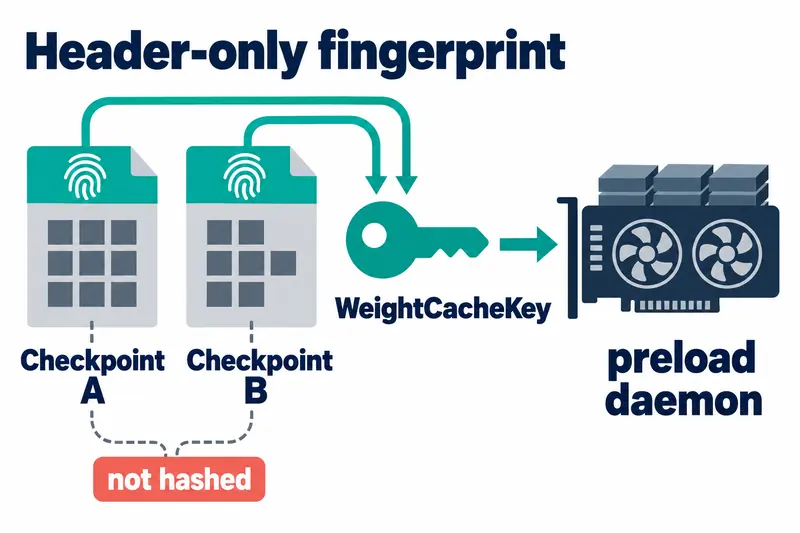
映射之前,引擎会与守护进程比对指纹(WeightCacheKey)。文档列出的比对项是检查点内容、模型架构、TP/DP 规模与 rank、dtype、量化方法与配置、模型 revision 和 vLLM 版本。按照文档中 "Safe fallback" 的说明,任何一项不同都会退回磁盘加载。
问题在于“检查点内容”的范围。阅读 v0.31.0 标签下的 `protocol.py` 可以看到,`hash_checkpoint()` 只把每个分片的文件名和 safetensors 头部送入哈希器。头部只有张量名、dtype、shape 和字节偏移,不包含权重值。docstring 明确写着,这样设计是为了让存放在不同目录中的相同权重得到同一个键。
10月1日提交的议题 #59647 复现了这一副作用。报告者复制了 Qwen3-0.6B,保持头部不变,只把 `model.norm.weight` 全部改写为 0。这份副本单独启动时输出 "!!!!!!!!!!!!",但以 `ipc_cache` 挂到持有原始权重的守护进程上后,输出与原模型相同的句子。两个进程都没有留下任何警告。
据报告,Qwen3-0.6B 被哈希的头部只有 35,560 字节,而文件共 1,503,300,328 字节。 指纹不一致时的回退路径本身是有效的。议题 #60178 记录了在 10月3日 main 构建的数据并行下 `dp_size` 不同时,引擎留下警告并退回磁盘加载的情况。 漏洞只在于一个不看数值的指纹。
修复 PR #59648 把分片文件大小和每个张量数据区的前 1 KiB 混入指纹。PR 自己写明了局限:如果数值只在所有张量前 1 KiB 之后发生变化,键不会改变;并把它定义为缓存正确性指纹,而不是安全边界。截至 2026年10月14日核实时,该 PR 和原议题都仍未关闭。
每次重启都要重读 66 个头部
同一个指纹还带来了反方向的开销。v0.31.0 `ipc_loader.py` 中的 `_fetch_entries()` 每次向守护进程请求张量时都会调用 `WeightCacheKey.from_model_config()`,而该函数会再次执行 `hash_checkpoint()`。 也就是说,即便守护进程已经持有权重,每次重启仍要打开原始检查点文件。
一位用户在议题 #60944 中测量了这项开销。条件是 vLLM 0.31.0、存放在 OSSFS 上的 66 个分片约 28.75 GiB 的 Qwen3.8-27B-FP8、单张 H20-3e、TP=1。每次都执行原始指纹计算时,到 `/health` 返回 200 平均需要 78.79 秒;改为复用守护进程首次计算的指纹后为 46.85 秒。两种条件都使用同一个守护进程、`zero_copy`、`fallback=false` 和预热好的编译缓存。
拆开数字就能看出开销的性质。在该用户留在 PR #59648 的计时中,读取头部涉及 66 个文件、共 203,664 字节,耗时约 32 秒。 简单换算约为每个分片 0.49 秒,每个文件读取量仅 3 KB 多。吞掉重启时间的是远程文件系统的往返延迟,而不是带宽。
即使跳过指纹,模型加载阶段约为 5.6 秒,整个启动仍在 47 秒左右。 文档中的 "seconds" 读起来是针对权重加载阶段的描述。缓存命中时跳过 `profile_run`、测量 CUDA 图捕获时间等,仍是 Fast Start 路线图上未完成的条目。
这只是单一环境的测量结果。使用本地 NVMe 可能减少延迟,但没有公开的对应测量。另一项修复方案将张量采样读取合并为最多 32 个并行请求;它在远程存储上的启动耗时尚无实测。
缓存未命中后的磁盘回退
默认的 `fallback: true` 让失败变得悄无声息。根据基于 10月3日 main 源码构建报告的议题 #60178,用 `--data-parallel-size 2` 启动非 MoE 的普通模型时,守护进程与引擎的 `dp_size` 指纹不一致。服务器照常响应,但每个 rank 只留下一行警告就从磁盘重新加载。在此期间,守护进程仍在每块 GPU 上占着自己的那份副本。
`fallback: false` 会把这类未命中暴露为启动失败。 但 #59647 这类头部冲突属于指纹一致的情况,这个设置也拦不住。 未命中被埋在警告里,错误命中则完全不留信号。
Fast Start 功能议题 #56049 的路线图也记录了同样的缺口。截至 10月14日核实时,"Daemon-loss semantics"(守护进程退出后运行中引擎的权重随即失效)以及在 CI 中比较缓存加载与常规加载贪心 token 的输出等价性测试仍未完成。
与 SGLang 权重管理的不同取舍
SGLang 可以在服务器进程持续运行时释放显存,也能通过 update_weights API 替换模型权重。remote_instance 格式则允许从另一台正在运行的 SGLang 实例获取权重。
相关文档没有说明 remote_instance 如何核对检查点是否相同。vLLM preload 则让新引擎借用另一进程中的 GPU 权重,因此正确识别目标检查点尤其重要。
因此,preload 的收益在很大程度上取决于运行条件。如果是一个守护进程在不可变的模型存储上持续服务同一个检查点的部署,跳过磁盘加载和量化后处理的好处可以完整保留。
轮流加载相同结构的微调模型或训练检查点仍有风险。问题 #59647 已复现这种错误复用。
检查守护进程与缓存复用
v0.31.0 的 `preload.py` 为守护进程父进程提供了 `--weight-cache-health-port`,`/health` 在所有 rank 就绪后返回 200,就绪之前或有 rank 退出时返回 503。该端口默认关闭,开启后默认主机为 0.0.0.0。
引擎一侧可以用 `fallback: false` 把未命中变成启动失败。 接下来查看引擎日志中出现的是映射成功的那一行,还是回退警告那一行。这两个字符串来自 v0.31.0 `ipc_loader.py` 的日志格式和议题中的复现日志。
vllm preload --model <local-model-dir> --weight-cache-health-port <port>
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:<port>/health
vllm serve <local-model-dir> --load-format ipc_cache \
    --model-loader-extra-config '{"fallback": false}'
# engine log
#   "Mapped <N> tensors from the weight cache daemon (zero_copy mode)"
#   "Weight cache unusable (...); falling back to disk loading"
出现映射成功的日志并不保证权重正确。正如 #59647 报告者所做的那样,切换检查点后,用默认加载格式(`auto`)启动同一模型的引擎,比较一次 temperature 0 的输出是否一致,是 0.31.0 中剩下的确认手段。
下一步的变化很可能来自对指纹读取量的调整。#59648 通过读取更多逐张量样本来提高准确性,#60944 则提议一种可选模式,让运营者显式信任特定守护进程从而跳过复查。 这两个方向最终以什么默认值收敛,大概会决定 preload 能否接入训练循环。
vLLM 0.31.0 的 preload 能减少重启开销,但仅凭头部生成的指纹无法保证缓存权重属于请求的检查点。