`vllm preload`는 2026년 10월 5일 출시된 vLLM 0.31.0에 포함됐다. 처리 완료된 GPU 가중치를 남겨 엔진 재시작 때 다시 읽지 않도록 한다. 구현 설명은 v0.31.0 릴리스 태그 기준이다.
재시작해도 남는 처리 완료 가중치
서빙 엔진을 다시 띄울 때의 비용은 커널보다 앞단에 있다. 체크포인트를 디스크에서 읽고, 양자화 후처리를 거쳐, TP 랭크별로 샤딩하는 과정이 재시작마다 반복된다. vLLM 문서는 preload가 이 재시작 시간을 "minutes"에서 "seconds"로 줄인다고 쓰지만, 모델·GPU·측정 조건은 붙이지 않았다.
구조는 단순하다. `vllm preload`가 GPU마다 데몬 프로세스를 띄우고, 데몬은 자기 랭크의 샤드를 한 번 로드해 양자화 후처리를 끝낸 뒤 모든 파라미터를 CUDA IPC 핸들로 내보낸다. `--load-format ipc_cache`로 시작한 엔진은 저장 공간 없는 meta 디바이스에 모델 골격만 만들고, 같은 GPU의 데몬에게 Unix 도메인 소켓으로 텐서를 요청한다.
기본 zero_copy 모드에서는 엔진이 데몬의 GPU 메모리를 그대로 사용해 가중치 사본을 하나만 둔다. 데몬이 계속 살아 있어야 하고, 가중치를 내리는 sleep 모드와는 함께 쓸 수 없다. copy 모드는 엔진에 사본을 만든 뒤 데몬 캐시를 해제하므로 다음 재시작에서의 재사용과 맞바꾸는 방식이다.
같은 safetensors 헤더가 다른 모델을 가리는 이유
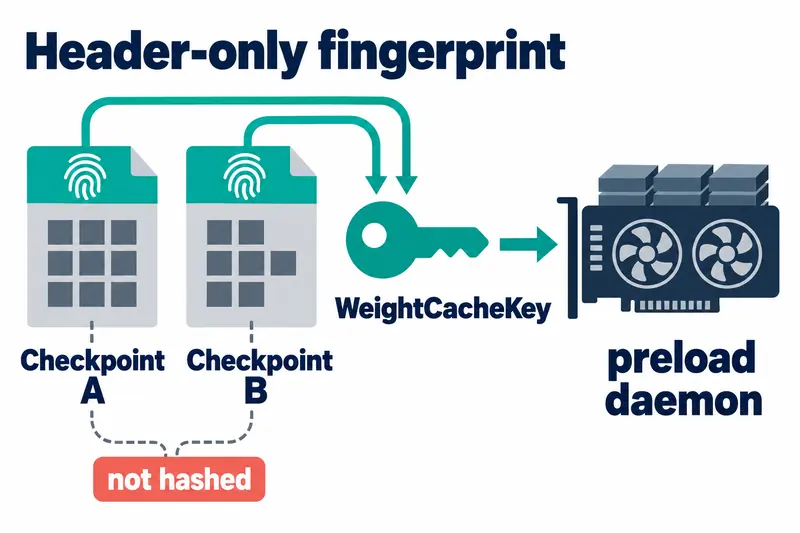
엔진은 매핑 전에 데몬과 지문(WeightCacheKey)을 맞춰 본다. 문서가 밝힌 비교 항목은 체크포인트 내용, 모델 아키텍처, TP/DP 크기와 랭크, dtype, 양자화 방식과 설정, 모델 revision, vLLM 버전이다. 어느 하나라도 다르면 디스크 로드로 돌아간다는 것이 문서의 "Safe fallback" 설명이다.
문제는 "체크포인트 내용"의 범위다. v0.31.0 태그의 `protocol.py`를 읽어 보면 `hash_checkpoint()`는 각 샤드의 파일 이름과 safetensors 헤더만 해시기에 넣는다. 헤더에는 텐서 이름, dtype, shape, 바이트 오프셋만 있고 가중치 값은 없다. 같은 가중치가 다른 디렉터리에 있어도 같은 키를 얻게 하려는 설계였다는 점은 docstring에 그대로 적혀 있다.
그 부작용은 10월 1일 올라온 이슈 #59647에서 재현됐다. 보고자는 Qwen3-0.6B를 복사한 뒤 헤더는 그대로 두고 `model.norm.weight`만 0으로 덮었다. 이 사본은 단독으로 띄우면 "!!!!!!!!!!!!"를 출력했지만, 원본을 들고 있는 데몬에 `ipc_cache`로 붙이자 원본과 같은 문장을 냈다. 어느 프로세스도 경고를 남기지 않았다.
보고서에 따르면 Qwen3-0.6B에서 해시되는 헤더는 1,503,300,328바이트 파일 중 35,560바이트였다. 지문이 어긋날 때의 대체 경로 자체는 동작한다. 10월 3일자 main 빌드의 데이터 병렬 설정에서 `dp_size`가 달라지자 엔진이 경고를 남기고 디스크로 돌아간 사례가 이슈 #60178에 있다. 빈틈은 값을 보지 않는 지문 하나에 있다.
수정 PR #59648은 샤드 파일 크기와 텐서마다 데이터 영역 첫 1 KiB를 지문에 섞는다. PR 스스로 모든 텐서의 첫 1 KiB 뒤쪽에서만 값이 바뀌면 키가 움직이지 않는다고 한계를 적었고, 이를 보안 경계가 아닌 캐시 정확성 지문이라고 규정했다. 이 PR과 원 이슈는 2026년 10월 14일 확인 시점에 모두 열려 있다.
재시작 때마다 다시 읽는 헤더 66개
같은 지문이 반대 방향의 비용도 만든다. v0.31.0 `ipc_loader.py`의 `_fetch_entries()`는 데몬에 텐서를 요청할 때마다 `WeightCacheKey.from_model_config()`를 호출하고, 이 함수가 `hash_checkpoint()`를 다시 실행한다. 데몬이 이미 가중치를 들고 있어도 원본 체크포인트 파일을 재시작마다 열어 본다는 뜻이다.
한 사용자는 이 비용을 이슈 #60944에 측정해 올렸다. 조건은 vLLM 0.31.0, OSSFS 위 66개 샤드 약 28.75 GiB의 Qwen3.8-27B-FP8, H20-3e 한 장, TP=1이었다. 원래 지문 계산을 매번 수행한 경우 `/health` 200까지 평균 78.79초가 걸렸다. 데몬의 첫 지문을 재사용하도록 바꾼 경우는 46.85초였다. 두 조건 모두 같은 데몬과 `zero_copy`, `fallback=false`, 미리 데워진 컴파일 캐시를 썼다.
수치를 나눠 보면 성격이 드러난다. 사용자가 PR #59648에 남긴 계측에서 헤더 읽기는 66개 파일, 총 203,664바이트에 약 32초였다. 단순 계산으로 샤드당 약 0.49초이고, 읽은 양은 파일당 3 KB 남짓이다. 대역폭이 아니라 원격 파일시스템의 왕복 지연이 재시작 시간을 잡아먹은 셈이다.
지문을 건너뛴 조건에서도 모델 로딩 단계는 약 5.6초였지만 전체 시작은 47초 안팎이었다. 문서의 "seconds"는 가중치 로딩 단계에 해당하는 설명으로 읽힌다. 캐시 히트 시 `profile_run` 생략이나 CUDA 그래프 캡처 시간 측정은 Fast Start 로드맵에 미완료 항목으로 남아 있다.
이 수치는 단일 환경의 결과다. 로컬 NVMe에서는 지연이 줄 가능성이 있지만 공개된 비교 측정은 없다. 별도의 수정안은 텐서 표본 읽기를 최대 32개씩 병렬 처리한다. 그 변경이 원격 저장소에서 시작 시간을 얼마나 바꿀지는 아직 측정되지 않았다.
캐시를 못 찾으면 디스크로 돌아가는 경로
기본값 `fallback: true`는 실패를 조용하게 만든다. 10월 3일자 main 소스 빌드에서 보고된 이슈 #60178에 따르면, MoE가 아닌 일반 모델을 `--data-parallel-size 2`로 띄우면 데몬과 엔진의 `dp_size` 지문이 어긋난다. 서버는 정상 응답하지만 각 랭크는 경고 한 줄을 남기고 디스크에서 다시 로드한다. 그동안 데몬은 GPU마다 자기 사본을 계속 붙잡고 있었다.
`fallback: false`는 이런 미스를 시작 실패로 드러낸다. 하지만 #59647 같은 헤더 충돌은 지문이 일치하는 경우라서 이 설정으로도 걸러지지 않는다. 미스는 경고로 묻히고, 잘못된 히트는 아무 신호도 남기지 않는 구조다.
Fast Start 기능 이슈 #56049의 로드맵도 같은 빈틈을 적어 두었다. 데몬이 종료되면 실행 중인 엔진의 가중치가 무효가 된다는 "Daemon-loss semantics"와, 캐시 로드와 일반 로드의 그리디 토큰을 CI에서 비교하는 출력 동등성 테스트가 10월 14일 확인 시점에 미완료로 남아 있다.
SGLang의 가중치 관리와 다른 선택
SGLang은 서버를 유지한 채 메모리를 비우거나 update_weights API로 가중치를 교체할 수 있다. remote_instance 형식으로 실행 중인 다른 SGLang 인스턴스의 가중치를 가져오는 방법도 제공한다.
다만 해당 SGLang 문서는 remote_instance가 체크포인트의 동일성을 어떻게 확인하는지 설명하지 않는다. vLLM preload는 새 엔진이 다른 프로세스의 GPU 가중치를 빌려 쓰는 방식이라, 정확한 지문으로 모델을 구분하는 일이 특히 중요하다.
그래서 preload의 이득은 운영 조건에 크게 좌우된다. 불변 모델 저장소에서 데몬 하나가 한 체크포인트만 계속 서빙하는 배포라면 디스크 로드와 양자화 후처리를 건너뛰는 이점이 그대로 남는다.
반면 같은 구조의 파인튜닝 모델이나 학습 중간 체크포인트를 번갈아 띄우는 환경에는 위험이 남는다. 이슈 #59647이 바로 그 경우를 재현했다.
데몬 상태와 캐시 재사용 확인
v0.31.0 `preload.py`에는 데몬 부모 프로세스용 `--weight-cache-health-port`가 있고, `/health`는 모든 랭크가 준비되면 200, 그 전이나 랭크가 죽으면 503을 돌려준다. 이 포트는 기본값이 꺼져 있고, 켜면 기본 호스트가 0.0.0.0이다.
엔진 쪽은 `fallback: false`로 미스를 시작 실패로 만들 수 있다. 그다음 엔진 로그에서 매핑 성공 줄과 대체 경로 경고 줄 중 어느 쪽이 찍혔는지를 본다. 두 문자열은 v0.31.0 `ipc_loader.py`의 로그 형식과 이슈 재현 로그에 나온다.
vllm preload --model <local-model-dir> --weight-cache-health-port <port>
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:<port>/health
vllm serve <local-model-dir> --load-format ipc_cache \
    --model-loader-extra-config '{"fallback": false}'
# engine log
#   "Mapped <N> tensors from the weight cache daemon (zero_copy mode)"
#   "Weight cache unusable (...); falling back to disk loading"
매핑 성공 줄이 곧 올바른 가중치라는 보장은 아니다. #59647 보고자가 쓴 방법처럼, 체크포인트를 바꾼 직후에는 같은 모델을 기본 로드 형식(`auto`)으로 띄운 엔진과 temperature 0 출력이 같은지 한 번 비교하는 것이 0.31.0에서 남은 확인 수단이다.
다음 변화는 지문을 얼마나 읽느냐의 조정에서 나올 가능성이 높아 보인다. #59648은 텐서별 샘플을 더 읽어 정확성을 높이는 쪽이고, #60944는 운영자가 특정 데몬을 명시적으로 신뢰해 재검사를 건너뛰는 옵트인 모드를 제안했다. 두 방향이 어떤 기본값으로 정리되는지가 preload를 학습 루프에 붙일 수 있는지를 가를 듯하다.
vLLM 0.31.0의 preload는 재시작 비용을 줄이지만, 헤더만 읽는 지문으로는 재사용한 가중치가 요청한 체크포인트와 같은지 보장할 수 없다.