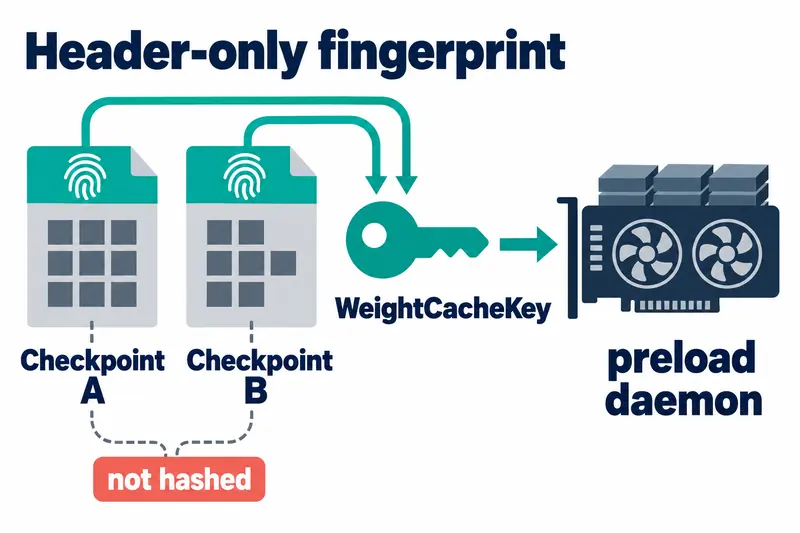
vLLM 0.31.0は2026年10月5日にvllm preloadを導入した。処理済みのGPU上の重みを残し、エンジン再起動時の再読込を省く仕組みだ。実装の記述はv0.31.0のリリースタグに基づく。
再起動後も使える処理済みの重み
推論サーバーのエンジンを立ち上げ直すコストは、カーネルが動く前の段階にある。チェックポイントをディスクから読み、量子化後処理を行い、TPランクごとにシャーディングする工程が再起動のたびに繰り返される。vLLMのドキュメントはpreloadがこの再起動時間を"minutes"から"seconds"に縮めると書くが、モデル・GPU・測定条件は示していない。
仕組みは単純だ。`vllm preload`はGPUごとにデーモンプロセスを起動し、デーモンは自分のランクのシャードを一度だけ読み込んで量子化後処理を終え、すべてのパラメータをCUDA IPCハンドルとして公開する。`--load-format ipc_cache`で起動したエンジンは、ストレージを持たないmetaデバイス上にモデルの骨格だけを作り、同じGPUのデーモンにUnixドメインソケットでテンソルを要求する。
標準のzero_copyモードでは、エンジンがデーモンのGPUメモリを直接参照し、GPUごとの重みは1組で済む。デーモンは稼働し続ける必要があり、重みを退避するsleepモードとは併用できない。copyモードはエンジン側に複製を作った後でデーモンのキャッシュを解放するため、後の再利用との引き換えになる。
safetensorsヘッダーだけでは重みを区別できない理由
エンジンはマッピングの前に、デーモンと指紋(WeightCacheKey)を照合する。ドキュメントが挙げる比較項目は、チェックポイントの内容、モデルアーキテクチャ、TP/DPのサイズとランク、dtype、量子化方式と設定、モデルのrevision、vLLMのバージョンだ。どれか1つでも異なればディスク読み込みに戻るというのが、ドキュメントの"Safe fallback"の説明である。
問題は「チェックポイントの内容」の範囲だ。v0.31.0タグの`protocol.py`を読むと、`hash_checkpoint()`は各シャードのファイル名とsafetensorsヘッダーだけをハッシュ関数に渡している。ヘッダーにあるのはテンソル名、dtype、shape、バイトオフセットだけで、重みの値は含まれない。同じ重みが別のディレクトリにあっても同じキーになるようにする設計だったことは、docstringにそのまま書かれている。
その副作用は、10月1日に登録されたIssue #59647で再現された。報告者はQwen3-0.6Bをコピーし、ヘッダーはそのままに`model.norm.weight`だけを0で上書きした。このコピーは単独で起動すると"!!!!!!!!!!!!"を出力したが、元の重みを持つデーモンに`ipc_cache`で接続すると元のモデルと同じ文を出した。どちらのプロセスも警告を残さなかった。
報告によると、Qwen3-0.6Bでハッシュされるヘッダーは1,503,300,328バイトのファイルのうち35,560バイトだった。 指紋が食い違うときのフォールバック経路自体は機能している。10月3日時点のmainビルドのデータ並列の設定で`dp_size`が異なるとエンジンが警告を残してディスクに戻った事例が、Issue #60178にある。 穴は値を見ない指紋1つにある。
修正PR #59648は、シャードのファイルサイズと、テンソルごとのデータ領域の先頭1 KiBを指紋に加える。PR自身が、すべてのテンソルの先頭1 KiBより後ろだけで値が変わればキーは変わらないという限界を記し、これをセキュリティ境界ではなくキャッシュの正しさのための指紋と位置づけた。このPRと元のIssueは、2026年10月14日の確認時点でいずれもオープンのままだ。
再起動ごとに読み直す66個のヘッダー
同じ指紋は逆方向のコストも生む。v0.31.0の`ipc_loader.py`にある`_fetch_entries()`は、デーモンにテンソルを要求するたびに`WeightCacheKey.from_model_config()`を呼び、この関数が`hash_checkpoint()`を再び実行する。 デーモンがすでに重みを持っていても、再起動のたびに元のチェックポイントファイルを開くということだ。
ある利用者がこのコストをIssue #60944で測定した。条件はvLLM 0.31.0、OSSFS上の66シャード・約28.75 GiBのQwen3.8-27B-FP8、H20-3e 1枚、TP=1だった。元の指紋計算を毎回行った場合、`/health`が200を返すまで平均78.79秒かかった。デーモンが最初に計算した指紋を再利用するよう変更した場合は46.85秒だった。どちらの条件も同じデーモン、`zero_copy`、`fallback=false`、事前にウォームアップしたコンパイルキャッシュを使っている。
数値を分解すると性質が見えてくる。利用者がPR #59648に残した計測では、ヘッダーの読み込みは66ファイル・合計203,664バイトで約32秒だった。 単純計算でシャードあたり約0.49秒、読み込み量はファイルあたり3 KB強にすぎない。再起動時間を食っていたのは帯域ではなく、リモートファイルシステムの往復遅延だったわけだ。
指紋を省いた条件でもモデル読み込み段階は約5.6秒だったが、起動全体は47秒前後だった。 ドキュメントの"seconds"は、重み読み込み段階についての説明と読める。キャッシュヒット時の`profile_run`省略やCUDAグラフのキャプチャ時間の測定は、Fast Startのロードマップで未完了の項目として残っている。
この結果は単一環境での測定だ。ローカルNVMeでは遅延が小さい可能性があるが、比較測定は公表されていない。別の修正案はテンソルの標本読み込みを最大32件並列化するが、リモートストレージでの起動時間はまだ測られていない。
キャッシュが使えない場合のディスク読み込み
既定の`fallback: true`は失敗を静かにする。10月3日時点のmainのソースビルドで報告されたIssue #60178によると、MoEではない通常のモデルを`--data-parallel-size 2`で起動すると、デーモンとエンジンの`dp_size`の指紋が食い違う。サーバーは正常に応答するが、各ランクは警告を1行残してディスクから読み込み直す。その間もデーモンはGPUごとに自分のコピーを保持し続けていた。
`fallback: false`はこうしたミスを起動失敗として表に出す。 しかし#59647のようなヘッダーの衝突は指紋が一致するケースなので、この設定でも防げない。 ミスは警告に埋もれ、誤ったヒットは何の兆候も残さない構造だ。
Fast Start機能のIssue #56049のロードマップも同じ穴を記している。デーモンが終了すると実行中のエンジンの重みが無効になるという"Daemon-loss semantics"と、キャッシュ読み込みと通常読み込みの貪欲デコードのトークンをCIで比較する出力等価性テストは、10月14日の確認時点で未完了のままだ。
SGLangの重み管理との違い
SGLangはサーバープロセスを維持したままGPUメモリを解放でき、update_weights APIで重みを交換することもできる。remote_instance形式では、稼働中の別のSGLangインスタンスから重みを取得する。
ただし、その文書はremote_instanceがチェックポイントの同一性をどう確認するかを説明していない。vLLM preloadでは新しいエンジンが別プロセスのGPU上の重みを借りるため、対象モデルを正しく見分ける指紋が特に重要になる。
そのためpreloadの利点は運用条件に大きく左右される。不変のモデルストレージで1つのデーモンが1つのチェックポイントだけを提供し続けるデプロイなら、ディスク読み込みと量子化後処理を省く利点はそのまま残る。
一方、同じ構造の微調整モデルや学習途中のチェックポイントを切り替える用途には危険が残る。issue #59647がまさにその誤った再利用を再現した。
デーモン状態とキャッシュ再利用の確認
v0.31.0の`preload.py`にはデーモンの親プロセス用の`--weight-cache-health-port`があり、`/health`はすべてのランクが準備できると200、それ以前やランクが落ちたときは503を返す。このポートは既定で無効で、有効にすると既定のホストは0.0.0.0になる。
エンジン側では`fallback: false`でミスを起動失敗にできる。 次に、エンジンログにマッピング成功の行とフォールバック警告の行のどちらが出たかを見る。2つの文字列はv0.31.0の`ipc_loader.py`のログ形式とIssueの再現ログに出てくる。
vllm preload --model <local-model-dir> --weight-cache-health-port <port>
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:<port>/health
vllm serve <local-model-dir> --load-format ipc_cache \
    --model-loader-extra-config '{"fallback": false}'
# engine log
#   "Mapped <N> tensors from the weight cache daemon (zero_copy mode)"
#   "Weight cache unusable (...); falling back to disk loading"
マッピング成功の行が出ても、正しい重みである保証にはならない。#59647の報告者が使った方法のように、チェックポイントを切り替えた直後に、同じモデルを既定の読み込み形式(`auto`)で起動したエンジンとtemperature 0の出力が一致するかを一度比べるのが、0.31.0で残る確認手段だ。
次の変化は、指紋がどれだけ読むかの調整から生まれる可能性が高そうだ。#59648はテンソルごとのサンプルを多く読んで正確さを上げる方向で、#60944は運用者が特定のデーモンを明示的に信頼して再検査を省くオプトインのモードを提案した。 この2つの方向がどんな既定値に落ち着くかが、preloadを学習ループに組み込めるかを分けそうだ。
vLLM 0.31.0のpreloadは再起動コストを減らすが、ヘッダーだけの指紋では再利用した重みが要求したチェックポイントと同じだとは保証できない。