Thinking Machines Lab 于 2026 年 11 月 5 日发布的 Inkling 2 Small,其权重于 11 月 12 日在 Hugging Face 上公开。Unsloth 发布了缩小权重体积的文件,让开发者能根据可用内存选择本地运行所需的文件。
一览
Inkling 2 Small 接收文本和图像,输出文本。它采用稀疏 MoE 架构,每个 token 使用 384 个专家中的 8 个。总参数量为 594B,但参与计算的活跃参数仅为 17B。即使只有部分参数参与计算,也必须存储全部权重,因此不能仅凭活跃参数量判断文件大小。
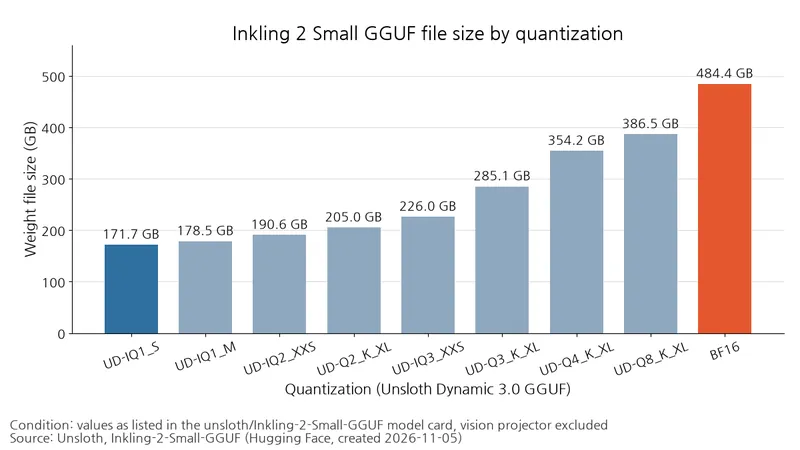
量化选项:从 171.7GB 到 484.4GB
GGUF 是 llama.cpp 和 Unsloth Desktop 使用的权重文件格式。Unsloth 发布了以更少比特表示权重的 8 种量化版本及 BF16 基准版。最高概率 token 一致率指各预测位置上,最高概率预测 token 与基准版相同的比例;平均 KLD 衡量输出概率分布的差异,越小越接近基准版。
条件:由 Unsloth 测量,使用 wikitext-2 的 64×4096 个 token 与 BF16 GGUF 比较,双方均使用 llama.cpp 默认的 F16 KV 缓存。大小不含视觉投影器。
表:各量化版本的大小及相对 BF16 的比较值
单位:文件大小为 GB,一致率为 %
| 量化 | 文件大小 | 平均 KLD | 相对 BF16 的最高概率 token 一致率 |
|---|---|---|---|
| UD-IQ1_S 1比特 | 171.7 | 0.0922 | 89.7 |
| UD-IQ2_XXS 2比特 | 190.6 | 0.0577 | 91.8 |
| UD-Q3_K_XL | 285.1 | 0.0176 | 95.3 |
| UD-Q4_K_XL | 354.2 | 0.0029 | 98.0 |
| BF16 基准 | 484.4 | 基准 | — |
按 Unsloth 的数据,1 比特文件比原始 NVFP4 权重文件集的 394GB 小 57%。在表中代表性选项中,从 UD-Q3_K_XL 换为 UD-Q4_K_XL 会多占用 69.1GB,但一致率提高 2.7 个百分点,平均 KLD 从 0.0176 降至 0.0029。
Unsloth 的 BF16 基准版是无损转换版本,保留第 0~39 层的原始 NVFP4 专家权重,仅将其余部分以 16 比特浮点格式保存。
文件大小不等于推理所需的全部内存。除操作系统外,还需为保存先前 token 计算结果的 KV 缓存、运行时临时空间即运行时缓冲区,以及处理图像特征的视觉投影器预留内存。Unsloth 建议根据 RAM 和 VRAM 或统一内存的容量选择量化版本。
性能:与其他模型并列比较
条件:Thinking Machines Lab 公布的评测,FrontierCode v2.0 使用 stirrup v0.2.1,其余三项评测使用 mini-swe-agent v2.4.6。Inkling 2 Small 的评测设置为 effort 0.99(xhigh)、temperature 1.0,智能体任务记录最多 1M 个 token。
表:各模型的编程与任务评测得分
单位:%
| 模型 | DeepSWE v1.1 | SWEBench Pro v2 (Hard) | FrontierCode v2.0 | Terminal Bench Science v0.1 |
|---|---|---|---|---|
| Inkling 2 Small | 72.1 | 86.3 | 25.4 | 5.7 |
| GLM-5.3-Flash | 63.4 | 82.8 | 17.6 | 4.8 |
| DeepSeek-V4.1-Flash-1017 | 77.0 | 89.7 | 28.5 | 12.9 |
| Muse Spark Open | 60.0 | 82.4 | 7.6 | 1.9 |
| Kimi K3 | 68.5 | 88.2 | 17.3 | 8.1 |
根据 Thinking Machines 公布的数据,Inkling 2 Small 在用于比较模型性能的编程基准评测中位居对比组前列。同次公布的 AA Index v5.0 为 30.6,Vals Index v2.2 为 56.1%。所列四项评测均低于 DeepSeek-V4.1-Flash-1017,其中 Terminal Bench Science v0.1 为 5.7%,落后于后者的 12.9%。
使用 llama.cpp 本地运行
llama.cpp 的构建版本是第一道门槛。Inkling 2 Small 使用新的 inkling2 架构,因此需要支持 Inkling 2 的构建版本,仅支持原有 Inkling 的版本无法加载模型。Unsloth 文档建议获取 llama.cpp 官方仓库的 PR 32187 并构建。
hf download unsloth/Inkling-2-Small-GGUF \
    --include "UD-IQ2_XXS/*" "mmproj-F16.gguf" --local-dir Inkling-2-Small-GGUF
用下载的文件运行 llama-server 后,对话界面位于 http://localhost:8080。若 VRAM 无法容纳,可降低 -ngl 或使用 -ngl 0 进行 CPU 推理。图像输入需要 --mmproj 和 658MB 的视觉投影器 mmproj-F16.gguf;仅处理文本时则去掉 --mmproj。将分片文件放在同一文件夹中,只需传入首个文件,其余分片会自动拼接。
GGUF 模板的默认推理强度为 high。上下文最多为 1,048,576 个 token,但考虑到内存用量,Unsloth 建议从 32K 个 token 开始。
适用场景
权重以 Apache 2.0 许可公开。原始模型已与 SGLang、vLLM 等集成,也可在 Tinker Playground 直接试用。
根据 Thinking Machines 模型卡,原始 NVFP4 检查点需要总计至少 500GB VRAM 的 GPU 集群,即组合使用多块 GPU 的设备配置。示例为 2×NVIDIA B300 和 4×NVIDIA H200;MXFP8 检查点则至少需要总计 800GB,例如 4×B300 或 8×H200。Thinking Machines 表示,NVFP4 是原生精度,MXFP8 在评测中的收益仅为 1~2 个百分点。这些条件适用于直接运行原始检查点,与 171.7GB GGUF 的要求不同。
局限
量化表中的最高概率 token 一致率是量化损失指标,而非任务基准评测的准确率。Thinking Machines 表示,Inkling 2 Small 的输入仅限文本和图像,对聊天体验的优化相对较少。
本地运行的核心取舍,在于将权重体积缩小多少,以及能容忍与基准版多大的预测差异。