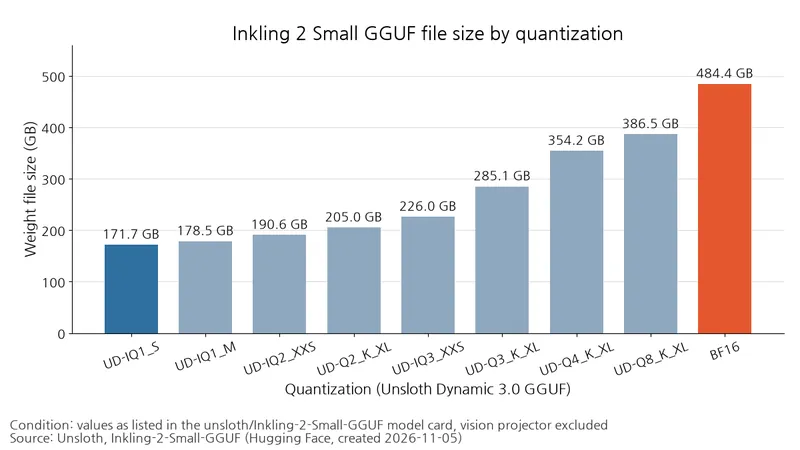
Thinking Machines Labが2026年11月5日に発表したInkling 2 Smallの重みが、11月12日にHugging Faceで公開された。Unslothは重みの容量を減らしたファイルを配布し、開発者が保有メモリに合わせてローカル実行用ファイルを選べるようにした。
概要
Inkling 2 Smallはテキストと画像を受け取り、テキストを出力する。スパースMoE構造で、トークンごとに384個のエキスパートのうち8個を使用する。総パラメータは594Bだが、計算で活性化されるのは17Bだ。一部だけが計算に参加しても重み全体を保存する必要があるため、活性パラメータ数だけでファイル容量を判断することはできない。
量子化の選択肢:171.7GBから484.4GBまで
GGUFはllama.cppとUnsloth Desktopで使われる重みファイル形式だ。Unslothは重みを少ないビット数で表す量子化版8種とBF16基準版を配布した。最上位トークン一致率は各予測位置で基準版と最上位の予測トークンが同じになる割合で、平均KLDは出力確率分布の差を示し、小さいほど基準版に近い。
条件:Unslothによる測定で、wikitext-2の64×4096トークンをBF16 GGUFと比較し、両方ともllama.cpp標準のF16 KVキャッシュを使用。サイズはビジョンプロジェクターを除く。
表:量子化別のサイズとBF16との比較値
単位:ファイルサイズGB、一致率%
| 量子化 | ファイルサイズ | 平均KLD | BF16との最上位トークン一致率 |
|---|---|---|---|
| UD-IQ1_S 1ビット | 171.7 | 0.0922 | 89.7 |
| UD-IQ2_XXS 2ビット | 190.6 | 0.0577 | 91.8 |
| UD-Q3_K_XL | 285.1 | 0.0176 | 95.3 |
| UD-Q4_K_XL | 354.2 | 0.0029 | 98.0 |
| BF16基準 | 484.4 | 基準 | — |
1ビットファイルはUnslothによると、元のNVFP4重みファイル一式394GBより57%小さい。表の代表的な選択肢でUD-Q3_K_XLからUD-Q4_K_XLに変えると、69.1GB多く使う代わりに一致率が2.7%ポイント高まり、平均KLDは0.0176から0.0029に下がる。
UnslothのBF16基準版は、0~39層の元のNVFP4エキスパート重みをそのまま残し、それ以外だけを16ビット浮動小数点形式で保存したロスレス変換版だ。
ファイルサイズは推論に必要なメモリ全体の量ではない。OS以外にも、過去のトークンの計算結果を保持するKVキャッシュ、実行中の一時領域であるランタイムバッファ、画像特徴を処理するビジョンプロジェクターのメモリが必要だ。UnslothはRAMとVRAM、またはユニファイドメモリに合わせて量子化を選ぶよう案内している。
性能:比較モデルと並べると
条件:Thinking Machines Lab発表の評価で、FrontierCode v2.0はstirrup v0.2.1、ほかの三つの評価はmini-swe-agent v2.4.6を使用。Inkling 2 Smallはeffort 0.99(xhigh)、temperature 1.0、エージェントの作業履歴は最大1Mトークンで評価。
表:モデル別のコーディング・作業評価スコア
単位:%
| モデル | DeepSWE v1.1 | SWEBench Pro v2 (Hard) | FrontierCode v2.0 | Terminal Bench Science v0.1 |
|---|---|---|---|---|
| Inkling 2 Small | 72.1 | 86.3 | 25.4 | 5.7 |
| GLM-5.3-Flash | 63.4 | 82.8 | 17.6 | 4.8 |
| DeepSeek-V4.1-Flash-1017 | 77.0 | 89.7 | 28.5 | 12.9 |
| Muse Spark Open | 60.0 | 82.4 | 7.6 | 1.9 |
| Kimi K3 | 68.5 | 88.2 | 17.3 | 8.1 |
Thinking Machinesの発表によると、Inkling 2 Smallはモデル性能を比較するコーディングベンチマークで比較対象の上位に入る。同じ発表でAA Index v5.0は30.6、Vals Index v2.2は56.1%だ。提示された四つの評価すべてでDeepSeek-V4.1-Flash-1017を下回り、Terminal Bench Science v0.1では5.7%で、同モデルの12.9%に及ばない。
llama.cppでローカル実行
llama.cppのビルドが最初の関門だ。Inkling 2 Smallは新しいinkling2アーキテクチャを使うため、Inkling 2対応ビルドが必要で、従来のInklingだけに対応するビルドではモデルを開けない。Unslothの文書は、llama.cpp公式リポジトリのPR 32187を取得してビルドするよう案内している。
hf download unsloth/Inkling-2-Small-GGUF \
    --include "UD-IQ2_XXS/*" "mmproj-F16.gguf" --local-dir Inkling-2-Small-GGUF
ダウンロードしたファイルでllama-serverを実行すると、対話画面がhttp://localhost:8080に表示される。VRAMに収まらなければ-nglを下げるか、-ngl 0でCPU推論を使う。画像入力には--mmprojとビジョンプロジェクターmmproj-F16.gguf 658MBが必要で、テキスト専用なら--mmprojを外す。シャード(分割ファイル)は同じフォルダーに置き、最初のファイルだけを渡せば残りは自動で結合される。
GGUFテンプレートの標準推論強度はhighだ。コンテキストは最大1,048,576トークンだが、Unslothはメモリ使用量を考慮して32Kトークンから始めるよう案内している。
用途
重みはApache 2.0で公開された。元のモデルはSGLang・vLLMなどと統合され、Tinker Playgroundではすぐに試せる。
Thinking Machinesのモデルカードによると、元のNVFP4チェックポイントには、合計で最低500GBのVRAMを持つGPUクラスター、つまり複数のGPUを組み合わせた機器構成が必要だ。例は2×NVIDIA B300と4×NVIDIA H200で、MXFP8チェックポイントは合計で最低800GBを要し、4×B300や8×H200が挙げられる。Thinking MachinesはNVFP4がネイティブ精度で、MXFP8の利点は評価で1~2%ポイントにとどまると述べた。この条件は元のチェックポイントを直接動かす場合のもので、171.7GBのGGUFの条件とは異なる。
限界
量子化表の最上位トークン一致率は、作業ベンチマークの正解率ではなく量子化損失の指標だ。Thinking Machinesは、Inkling 2 Smallの入力はテキストと画像に限られ、チャット体験への最適化は十分ではないと述べた。
ローカル実行での重要な選択は、重みの容量をどれだけ減らし、基準版との予測の差をどこまで許容するかにある。