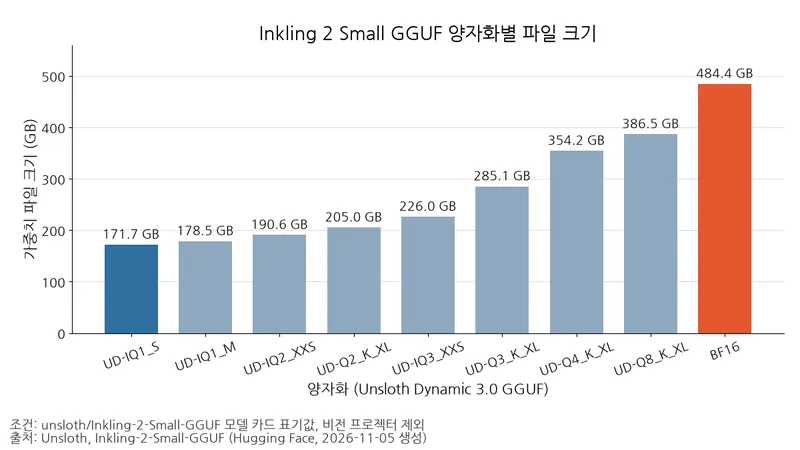
Thinking Machines Lab이 2026년 11월 5일 발표한 Inkling 2 Small의 가중치가 11월 12일 Hugging Face에 공개됐다. Unsloth는 가중치 용량을 줄인 파일을 배포해 개발자가 보유 메모리에 맞춰 로컬 실행용 파일을 고를 수 있게 했다.
한눈에 보기
Inkling 2 Small은 텍스트와 이미지를 받아 텍스트를 출력한다. 희소 MoE 구조로 토큰마다 전문가 384개 중 8개를 사용한다. 총 파라미터는 594B지만 계산에 활성화되는 것은 17B다. 일부만 계산에 참여해도 전체 가중치는 저장해야 하므로, 활성 파라미터 수만으로 파일 용량을 판단할 수는 없다.
양자화 선택지: 171.7GB부터 484.4GB까지
GGUF는 llama.cpp와 Unsloth Desktop에서 쓰는 가중치 파일 포맷이다. Unsloth는 가중치를 적은 비트로 표현하는 양자화 8종과 BF16 기준본을 배포했다. 상위 토큰 일치율은 각 예측 위치에서 기준본과 최상위 예측 토큰이 같은 비율이며, 평균 KLD는 출력 확률분포의 차이로 작을수록 기준본에 가깝다.
조건: Unsloth 측정, wikitext-2 64×4096 토큰을 BF16 GGUF와 비교하고 양쪽 모두 llama.cpp 기본 F16 KV 캐시 사용. 크기는 비전 프로젝터 제외.
표: 양자화별 크기와 BF16 대비 비교값
단위: 파일 크기 GB, 일치율 %
| 양자화 | 파일 크기 | 평균 KLD | BF16 대비 상위 토큰 일치 |
|---|---|---|---|
| UD-IQ1_S 1비트 | 171.7 | 0.0922 | 89.7 |
| UD-IQ2_XXS 2비트 | 190.6 | 0.0577 | 91.8 |
| UD-Q3_K_XL | 285.1 | 0.0176 | 95.3 |
| UD-Q4_K_XL | 354.2 | 0.0029 | 98.0 |
| BF16 기준 | 484.4 | 기준 | — |
1비트 파일은 Unsloth 기준으로 원본 NVFP4 가중치 파일 묶음 394GB보다 57% 작다. 표의 대표 선택지 중 UD-Q3_K_XL에서 UD-Q4_K_XL로 바꾸면 69.1GB를 더 쓰는 대신 일치율이 2.7%포인트 높아지고 평균 KLD는 0.0176에서 0.0029로 줄어든다.
Unsloth의 BF16 기준본은 0~39층의 원본 NVFP4 전문가 가중치를 그대로 두고 나머지만 16비트 부동소수점 형식으로 저장한 무손실 변환본이다.
파일 크기가 전체 추론 메모리 요구량은 아니다. 운영체제 외에 이전 토큰의 계산 결과를 보관하는 KV 캐시, 실행 중 임시 공간인 런타임 버퍼, 이미지 특징을 처리하는 비전 프로젝터의 메모리도 필요하다. Unsloth는 RAM과 VRAM 또는 통합 메모리에 맞춰 양자화를 고르라고 안내한다.
성능: 비교 모델과 나란히 놓으면
조건: Thinking Machines Lab 발표 평가, FrontierCode v2.0은 stirrup v0.2.1, 나머지 세 평가는 mini-swe-agent v2.4.6 사용. Inkling 2 Small은 effort 0.99(xhigh), temperature 1.0, 에이전트 작업 기록 최대 1M 토큰으로 평가.
표: 모델별 코딩·작업 평가 점수
단위: %
| 모델 | DeepSWE v1.1 | SWEBench Pro v2 (Hard) | FrontierCode v2.0 | Terminal Bench Science v0.1 |
|---|---|---|---|---|
| Inkling 2 Small | 72.1 | 86.3 | 25.4 | 5.7 |
| GLM-5.3-Flash | 63.4 | 82.8 | 17.6 | 4.8 |
| DeepSeek-V4.1-Flash-1017 | 77.0 | 89.7 | 28.5 | 12.9 |
| Muse Spark Open | 60.0 | 82.4 | 7.6 | 1.9 |
| Kimi K3 | 68.5 | 88.2 | 17.3 | 8.1 |
Thinking Machines 발표 기준으로 Inkling 2 Small은 코딩 벤치마크, 모델 성능을 비교하는 평가에서 비교군 가운데 상위권이다. 같은 발표의 AA Index v5.0은 30.6, Vals Index v2.2는 56.1%다. 제시한 네 평가 모두에서 DeepSeek-V4.1-Flash-1017보다 낮고, Terminal Bench Science v0.1에서는 5.7%로 그 12.9%에 밀린다.
llama.cpp로 로컬 실행
llama.cpp 빌드가 첫 관문이다. Inkling 2 Small은 새 inkling2 아키텍처를 쓰기 때문에 Inkling 2를 지원하는 빌드가 필요하고, 기존 Inkling만 지원하는 빌드는 모델을 열지 못한다. Unsloth 문서는 llama.cpp 공식 저장소의 PR 32187을 받아 빌드하라고 안내한다.
hf download unsloth/Inkling-2-Small-GGUF \
    --include "UD-IQ2_XXS/*" "mmproj-F16.gguf" --local-dir Inkling-2-Small-GGUF
다운로드한 파일로 llama-server를 실행하면 대화 화면은 http://localhost:8080에 뜬다. VRAM에 들어가지 않으면 -ngl을 낮추거나 -ngl 0으로 CPU 추론을 쓴다. 이미지 입력에는 --mmproj와 비전 프로젝터 mmproj-F16.gguf 658MB가 필요하고, 텍스트 전용이면 --mmproj를 뺀다. 샤드(분할 파일)는 한 폴더에 두고 첫 파일만 넘기면 나머지는 자동으로 붙는다.
GGUF 템플릿의 기본 추론 강도는 high다. 컨텍스트는 최대 1,048,576 토큰이지만 Unsloth는 메모리 사용량을 고려해 32K 토큰으로 시작하도록 안내한다.
어디에 쓰나
가중치는 Apache 2.0으로 공개됐다. 원본 모델은 SGLang·vLLM 등과 통합되며, Tinker Playground에서는 바로 시험해 볼 수 있다.
Thinking Machines 모델 카드 기준으로 원본 NVFP4 체크포인트는 집계 최소 500GB VRAM의 GPU 클러스터, 여러 GPU를 묶어 쓰는 장비 구성이 필요하다. 예시는 2×NVIDIA B300과 4×NVIDIA H200이고, MXFP8 체크포인트는 집계 최소 800GB로 4×B300이나 8×H200이 든다. Thinking Machines는 NVFP4가 네이티브 정밀도이며 MXFP8의 이득은 평가에서 1~2%포인트에 그친다고 밝혔다. 이 조건은 원본 체크포인트를 직접 띄울 때의 것이고 171.7GB짜리 GGUF의 조건과는 다르다.
한계
양자화 표의 상위 토큰 일치율은 작업 벤치마크 정확도가 아니라 양자화 손실 지표다. Thinking Machines는 Inkling 2 Small의 입력이 텍스트와 이미지로 한정되고 채팅 경험에는 덜 최적화돼 있다고 밝혔다.
로컬 실행의 핵심 선택은 가중치 용량을 얼마나 줄이고 기준본과의 예측 차이를 얼마나 허용할지에 있다.