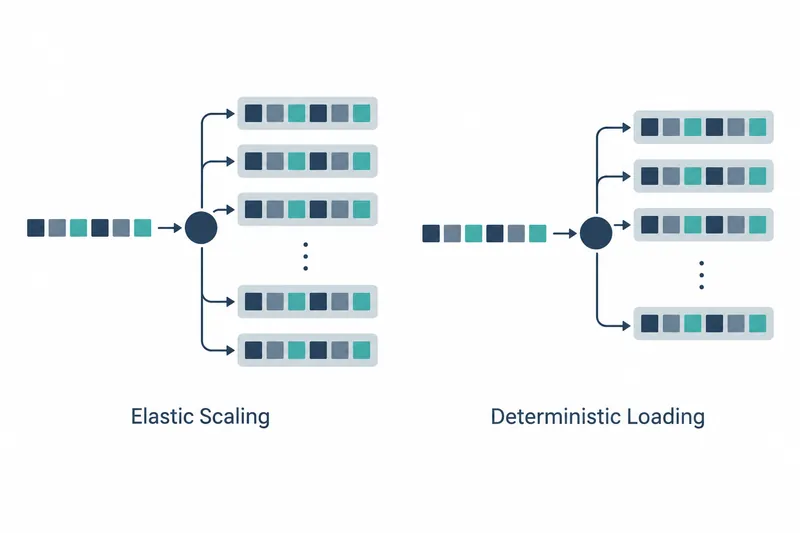
训练大规模模型的开发者如今可以在更改 GPU 数量并恢复任务后,保持相同的数据与顺序。TorchTitan 的 Zephon 集成在训练中处理数据的同时保持这种一致性,减少 GPU 数量对数据改进实验的干扰。
1. 用训练中处理取代预先制作副本
传统方式往往在每次更改数据混合或处理方式时,都要预处理全部数据并在磁盘上生成副本。如果实验未带来改进,这些副本可能只读取一次便不再使用,浪费准备时间和存储空间。
Zephon 在训练过程中将文本切分为模型读取的词元,按指定长度打包并打乱顺序。关键在于,即使 GPU 数量发生变化,也能保持相同的“全局批次”,即所有 GPU 在一个训练步骤中共同接收的数据批次。
2. 恢复实验与评测中观察到的差异
原文使用 16 个 GPU 训练一个 10 亿参数模型,再从第 150 步的检查点,即中途保存点,改用 8·32·64 个 GPU 恢复训练。标准加载器的损失曲线出现分叉,而 Zephon 的曲线几乎重合,各全局批次的 SHA-256 哈希值也与原运行一致。哈希值用于比较批次内容是否相同。
原文还给出了另一项评测:使用 8·16·32·64 个 GPU,从头训练同等规模模型,训练量为 200 亿词元。不同 GPU 数量下,标准加载器的 DCLM Core v1 分数最大差距为 0.82 分,Zephon 为 0.05 分。FineWeb 评测中的差距分别为 0.64 分和 0.011 分。
这一结果并非平均分数提高,而是不同 GPU 数量下的评测差异缩小。原文指出,标准加载器的差距约为这两项评测的作者评估数据筛选方法时所用相关阈值的四倍。这意味着,在不同 GPU 数量下比较数据混合方案,可能将硬件配置的影响误认为数据改进的效果。
3. 分开配置数据计划与处理阶段
用户需要描述数据集、决定混合比例和顺序的计划,以及将样本转换为训练张量(模型计算所用的数值数组)的处理阶段。计划与处理相互分离,因此可以只更改混合比例或处理方式。
混合比例以词元而非样本数量为基准,并通过测量小规模样本的词元与字节比率来校准计划。
以下原样摘录了原文示例中配置数据源后执行的部分。词元化分配了四个工作进程,各处理阶段的并行度可单独设置。
pipeline = (
    Pipeline(source)
    .options(io_options={"cache": {"enabled": True}})
    .tokenize(tokenizer_id="gpt2", field="text", parallelism=4)
    .pack_flat(max_length=2048, algorithm="wrap")
    .shuffle(buffer_size=1024, seed=42)
    .batch(microbatch_size=8)
)
for batch in pipeline:
    train_step(batch.to_training())
4. 保持顺序的结构与接入方式
现有加载器也能在一定条件下,在更改 GPU 数量后复现相同批次。Mosaic Streaming·Google Grain 要求能通过索引预先确定样本顺序,因此不支持训练中打包等处理。Megatron-Energon 则要求所有 GPU 上的数据加载器工作进程总数保持不变。
Zephon 将决定顺序与打包的累加器和并行工作进程分离,即使完成顺序不同,也会重新排列输出。
数据被分配到称为“通道”的固定逻辑流中,GPU 数量改变时会重新分配通道。
检查点不保存缓冲区内容,而是记录正在处理的输入区间;恢复时,从最近一次清空缓冲区的位置重新播放输入,以重建状态。
TorchTitan 集成将默认数据加载器替换为基于数据配置和处理设置构建的 Zephon 流水线,其余训练设置保持不变。数据处理状态与模型一同保存。运行开始时,会检查通道是否均匀分配给数据并行副本(共同训练同一模型的处理单元),以及一个训练步骤的批次是否均匀划分到各通道,以便及早排除错误配置。
5. 节省的准备成本与仍然存在的限制
不再制作预处理副本的代价,是由训练任务中的 CPU 承担数据处理工作。
通道数必须提前设为预期数据并行规模的公倍数;如果预计使用 8·16·32 个 GPU,可以设置 32 个通道。每个 GPU 的通道数增加会延长检查点恢复时间,因此不应一味设得过大。
更改 GPU 数量并恢复训练时,数据、词元化工具、随机种子、混合比例、上下文长度和全局批次大小必须固定。并行度等性能设置则可以调整。
保证一致的是数据,而非全部计算结果。GPU 数量不同会改变浮点运算的归并顺序,因此损失值即使非常接近,也可能并不完全相同。
Zephon 集成的价值,与其说在于训练速度本身的提升,不如说在于为数据实验提供不受硬件配置变化干扰的比较基础。