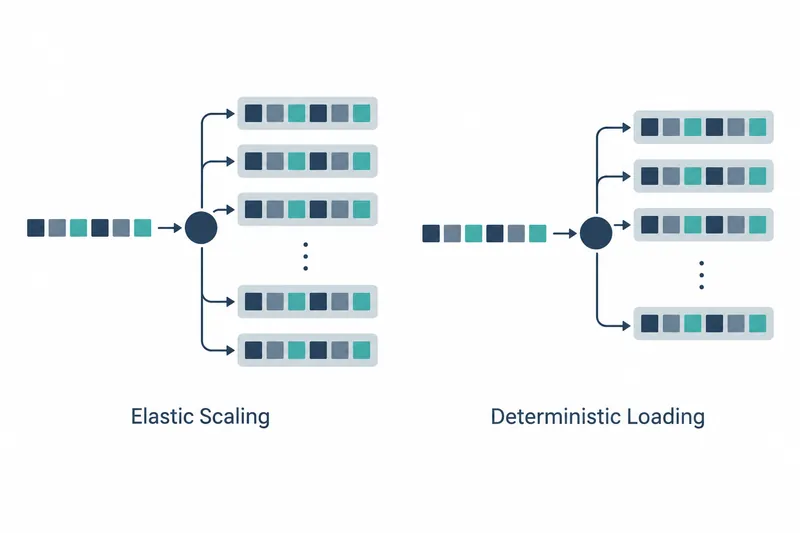
대규모 모델을 학습하는 개발자는 이제 GPU 수를 바꿔 작업을 재개해도 같은 데이터와 순서를 유지할 수 있다. TorchTitan용 Zephon 통합은 학습 중 데이터를 가공하면서도 이 일관성을 지켜, 데이터 개선 실험에 GPU 수의 영향이 끼어드는 문제를 줄인다.
1. 미리 만든 사본 대신 학습 중 가공
기존 방식에서는 데이터 혼합이나 가공 방식을 바꿀 때마다 전체 자료를 전처리하고 디스크에 사본을 만드는 일이 잦았다. 실험이 개선으로 이어지지 않으면 한 번 읽은 사본을 다시 쓰지 않아 준비 시간과 저장 공간이 낭비된다.
Zephon은 텍스트를 모델이 읽는 토큰으로 나누고, 정해진 길이로 묶고, 순서를 섞는 작업을 학습 중 수행한다. 핵심은 GPU 수가 달라져도 전체 GPU가 한 학습 단계에서 함께 받는 데이터 묶음인 ‘글로벌 배치’를 같게 유지한다는 점이다.
2. 재개 실험과 평가에서 확인한 차이
원문은 10억 매개변수 모델을 GPU 16개로 학습하다 150번째 단계의 체크포인트, 즉 중간 저장 지점에서 8·32·64개로 재개했다. 표준 로더는 손실 곡선이 갈라졌지만 Zephon은 거의 겹쳤고, 각 글로벌 배치의 SHA-256 해시도 기존 실행과 일치했다. 해시는 배치 내용이 같은지 확인하는 비교값으로 쓰였다.
별도로 같은 규모 모델을 처음부터 200억 토큰만큼 GPU 8·16·32·64개에서 학습한 평가도 제시했다. DCLM Core v1 점수의 GPU 수별 최대 격차는 표준 로더에서 0.82점, Zephon에서 0.05점이었다. FineWeb 평가의 격차는 각각 0.64점과 0.011점이었다.
이는 평균 점수가 올랐다는 결과가 아니라, GPU 수에 따른 평가 편차가 줄었다는 결과다. 원문은 표준 로더의 격차가 두 평가 저자가 데이터 선별 방법을 평가할 때 쓴 관련 임계치의 약 네 배라고 설명한다. 서로 다른 GPU 수에서 데이터 혼합을 비교하면 장비 구성의 영향을 데이터 개선 효과로 오인할 수 있다는 의미다.
3. 데이터 계획과 처리 단계를 나눠 구성
사용자는 데이터셋, 혼합 비율과 순서를 정하는 계획, 샘플을 학습용 텐서(모델이 계산에 사용하는 숫자 배열)로 바꾸는 처리 단계를 기술한다. 계획과 처리가 분리돼 혼합 비율만 바꾸거나 처리 방식만 바꿀 수 있다.
혼합 비율은 샘플 개수가 아닌 토큰 기준이며, 작은 표본의 토큰·바이트 비율을 측정해 계획을 보정한다.
다음은 원문 예제에서 데이터 원천을 구성한 뒤 실행하는 부분을 그대로 발췌한 것이다. 토큰화에는 작업자 네 개를 배정하며, 각 처리 단계의 병렬도는 따로 정할 수 있다.
pipeline = (
    Pipeline(source)
    .options(io_options={"cache": {"enabled": True}})
    .tokenize(tokenizer_id="gpt2", field="text", parallelism=4)
    .pack_flat(max_length=2048, algorithm="wrap")
    .shuffle(buffer_size=1024, seed=42)
    .batch(microbatch_size=8)
)
for batch in pipeline:
    train_step(batch.to_training())
4. 순서를 유지하는 구조와 연결 방법
기존 로더도 조건부로 GPU 수 변경 후 같은 배치를 재현한다. Mosaic Streaming·Google Grain은 샘플 순서를 인덱스로 미리 정할 수 있어야 하므로 학습 중 묶기 같은 처리는 제외된다. Megatron-Energon은 모든 GPU에 걸친 데이터 로더 작업자 수의 합이 같아야 한다.
Zephon은 순서와 묶음을 정하는 누적기와 병렬 작업자를 분리해 완료 순서가 달라도 출력을 재정렬한다.
데이터는 고정된 논리적 흐름인 ‘레인’에 나눠 GPU 수가 바뀌면 레인을 재배치한다.
체크포인트에는 버퍼 내용 대신 처리 중이던 입력 구간을 기록하고, 복구할 때 최근 버퍼를 비운 지점부터 입력을 재생해 상태를 되살린다.
TorchTitan 통합은 기본 데이터 로더를 데이터 구성과 처리 설정으로 만든 Zephon 파이프라인으로 대체하고 나머지 학습 설정은 유지한다. 데이터 처리 상태는 모델과 함께 저장한다. 실행 시작 시 레인이 데이터 병렬 복제본(같은 모델을 나눠 학습하는 처리 단위)에 균등 배분되는지, 한 학습 단계의 배치가 레인에 균등 분할되는지 검사해 잘못된 설정을 조기에 거른다.
5. 절약되는 준비 비용과 남는 제약
전처리 사본을 만들지 않는 대신, 가공 작업은 학습 작업 안의 CPU가 맡는다.
레인 수는 예상하는 데이터 병렬 크기의 공통 배수로 미리 정해야 하며, GPU 8·16·32개를 예상하면 레인 32개를 쓸 수 있다. GPU당 레인이 늘면 체크포인트 복원 시간이 늘어나는 부담이 있어 무작정 크게 잡는 방식은 피해야 한다.
GPU 수를 바꿔 재개할 때 데이터, 토큰화 도구, 난수 시드, 혼합 비율, 문맥 길이, 글로벌 배치 크기는 고정해야 한다. 병렬도 같은 성능 설정은 조정할 수 있다.
보장 대상은 데이터이지 계산 결과 전체가 아니다. GPU 수에 따라 부동소수점 연산을 합치는 순서가 달라져 손실값은 매우 가까워도 완전히 같지 않을 수 있다.
Zephon 통합의 가치는 학습 속도 향상 자체보다 장비 구성에 흔들리지 않는 데이터 실험의 비교 기반에 있다.