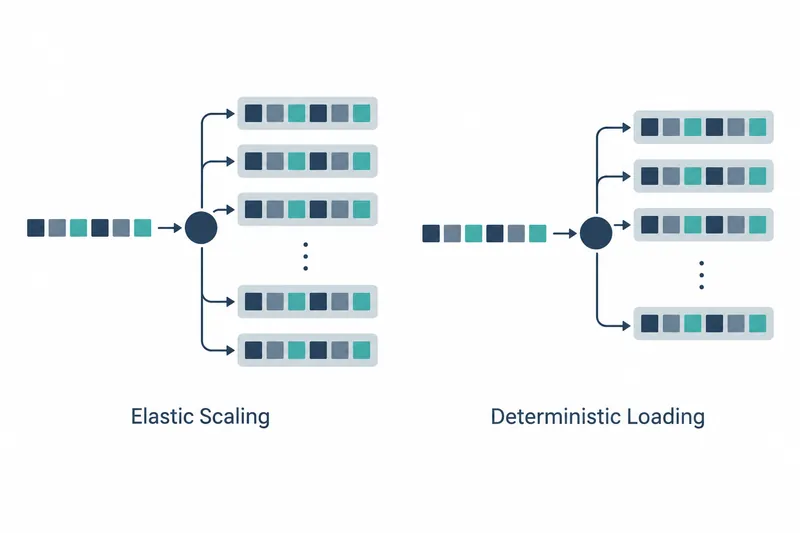
大規模モデルを学習する開発者は、GPU数を変えて処理を再開しても、同じデータと順序を維持できるようになった。TorchTitan向けのZephon統合は、学習中にデータを加工しながらこの一貫性を保ち、データ改善実験にGPU数の影響が入り込む問題を減らす。
1. 事前に作るコピーの代わりに学習中に加工
従来の方式では、データの混合や加工方法を変えるたびに、全データを前処理してディスクにコピーを作ることが多かった。実験が改善につながらなければ、一度読んだコピーを再利用せず、準備時間とストレージを無駄にする。
Zephonは、テキストをモデルが読むトークンに分割し、決まった長さにまとめ、順序をシャッフルする処理を学習中に行う。要点は、GPU数が変わっても、全GPUが1回の学習ステップで受け取るデータのまとまりである「グローバルバッチ」を同じに保つことだ。
2. 再開実験と評価で確認された違い
原文では、10億パラメータのモデルをGPU 16基で学習し、150番目のステップのチェックポイント、つまり途中の保存地点から8・32・64基で再開した。標準ローダーでは損失曲線が分かれたが、Zephonではほぼ重なり、各グローバルバッチのSHA-256ハッシュも元の実行と一致した。ハッシュはバッチ内容の一致を確認する比較値として使われた。
別途、同規模のモデルを最初から200億トークン分、GPU 8・16・32・64基で学習した評価も示した。DCLM Core v1スコアのGPU数別の最大差は、標準ローダーで0.82点、Zephonで0.05点だった。FineWeb評価の差は、それぞれ0.64点と0.011点だった。
これは平均スコアが上がったという結果ではなく、GPU数による評価のばらつきが減ったという結果だ。原文は、標準ローダーの差が、両評価の著者がデータ選別方法の評価に用いた関連する閾値の約4倍だと説明する。異なるGPU数でデータ混合を比較すると、機器構成の影響をデータ改善の効果と誤認しかねないという意味だ。
3. データ計画と処理段階を分けて構成
ユーザーは、データセット、混合比率と順序を決める計画、サンプルを学習用テンソル(モデルが計算に使う数値配列)に変換する処理段階を記述する。計画と処理が分離されているため、混合比率だけ、あるいは処理方法だけを変更できる。
混合比率はサンプル数ではなくトークン基準で、小さな標本のトークン・バイト比率を測定して計画を補正する。
以下は、原文の例からデータソースの構成後に実行する部分をそのまま抜粋したものだ。トークン化には4つのワーカーを割り当て、各処理段階の並列度は個別に設定できる。
pipeline = (
    Pipeline(source)
    .options(io_options={"cache": {"enabled": True}})
    .tokenize(tokenizer_id="gpt2", field="text", parallelism=4)
    .pack_flat(max_length=2048, algorithm="wrap")
    .shuffle(buffer_size=1024, seed=42)
    .batch(microbatch_size=8)
)
for batch in pipeline:
    train_step(batch.to_training())
4. 順序を維持する構造と接続方法
従来のローダーも条件付きで、GPU数の変更後に同じバッチを再現する。Mosaic Streaming・Google Grainは、サンプル順序をインデックスで事前に決められる必要があり、学習中にまとめるような処理は対象外となる。Megatron-Energonは、全GPUにわたるデータローダーのワーカー数の合計が同じでなければならない。
Zephonは、順序とまとまりを決めるアキュムレーターと並列ワーカーを分離し、完了順序が異なっても出力を並べ直す。
データを固定された論理的な流れである「レーン」に分け、GPU数が変わるとレーンを再配置する。
チェックポイントにはバッファーの内容ではなく処理中だった入力区間を記録し、復旧時には直近でバッファーを空にした地点から入力を再生して状態を復元する。
TorchTitan統合は、標準データローダーをデータ構成と処理設定から作るZephonパイプラインに置き換え、ほかの学習設定は維持する。データ処理状態はモデルとともに保存する。実行開始時に、レーンがデータ並列レプリカ(同じモデルの学習を分担する処理単位)に均等配分されるか、1学習ステップのバッチがレーンに均等分割されるかを検査し、誤設定を早期に検出する。
5. 節約できる準備コストと残る制約
前処理済みコピーを作らない代わりに、加工処理は学習ジョブ内のCPUが担う。
レーン数は、想定するデータ並列サイズの公倍数に事前設定する必要があり、GPU 8・16・32基を想定するなら32レーンを使える。GPU当たりのレーンが増えるとチェックポイントの復元時間が長くなる負担があるため、むやみに大きく設定するのは避けるべきだ。
GPU数を変えて再開する際は、データ、トークナイザー、乱数シード、混合比率、文脈長、グローバルバッチサイズを固定する必要がある。並列度などの性能設定は調整できる。
保証対象はデータであり、計算結果全体ではない。GPU数によって浮動小数点演算を合算する順序が変わるため、損失値は非常に近くても完全には一致しない場合がある。
Zephon統合の価値は、学習速度の向上そのものよりも、機器構成に左右されないデータ実験の比較基盤にある。