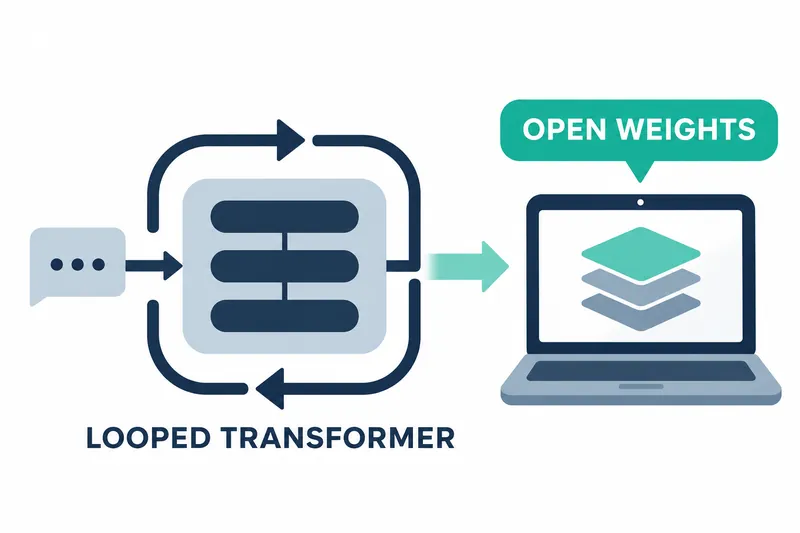
Thinking Machines Lab于2026年11月20日发布了面向笔记本和台式电脑运行的人工智能模型Inkling 2 Mini。开发编程工具的开发者可以下载公开权重,用于解决多步骤问题并进行微调。
1. 重复使用中间层的结构
Inkling 2 Mini使用相同权重三次通过中间层,重复进行计算。这种方式复用同一段计算过程,增加的是计算深度,而非模型大小。
据模型卡介绍,它是一个总参数量为264亿的混合专家模型,每个词元的激活参数量为34亿。计入循环计算后的有效激活规模为54亿。
存储的24层中有12层各通过三次,因此每个词元的层计算次数为48次。据公司公告,在28项评测中的27项中,重复中间层带来的准确率提升大于重复最后12层。
大部分权重以4位NVFP4训练和发布,最后四层使用8位MXFP8。据模型卡介绍,发布的检查点大小约为20GB。
模型接收文本和图像输入,以文本作答,上下文长度最高为100万词元。
2. 公司公布的编程评测结果
据公司公告,在总参数量低于1000亿的开放权重模型中,该模型在DeepSWE v1.1和Vals Index v2.2中领先,后者得分为46.5%。下表汇总了使用相同编程评测与评测工具报告的解决率,各模型的评测环境可能不同。
表:DeepSWE v1.1编程任务解决率
条件:依据公司公告,DeepSWE v1.1,mini-swe-agent v2.4.6
单位:%
| 模型 | 解决率 |
|---|---|
| Inkling 2 Mini | 48.2 |
| Qwen3.8-27B | 42.2 |
| Nemotron 3.5 Super VL | 24.7 |
| Muse Glimmer | 4.4 |
| Gemma 4 31B | 0.3 |
Inkling 2 Mini的解决率为48.2%,比Qwen3.8-27B的42.2%高6.0个百分点。如果重视这项编程任务的解决率,这可作为在本地编程工具中优先试用Inkling 2 Mini的依据。
在使用相同评测工具的其他测试中,据公司公告,SWE-bench Pro v2 (Hard)为77.9%,Terminal Bench v4.0为5.6%。后者与表中竞争模型的最高分持平。
3. 更多计算与本地使用的权衡
循环结构无需输出冗长的中间推理即可进行更多计算,但每个词元的计算量会增加。据公司公告,比较缩减专家数量前的模型时,无循环模型的训练计算量少7.5%,但在51万2千词元的智能体任务记录中,达到相同预测误差所需的推理计算量多140%。
同期发布的研究用可变循环模型支持改变循环次数进行实验。在公司公告的另一项实验中,以不输出推理文本、50%成功率解决部分Think Fast任务时,按人类完成时间衡量的任务长度从通过1次时的16秒增至通过3次时的37秒。
在公司公告介绍的斯坦福研究团队能效评测中,Inkling 2 Mini为0.703,Qwen3.6-35B-A3B为0.430。该指标评估达到一定性能所需的能量,Inkling 2 Mini在DGX Spark 128GB上以MXFP8和低推理强度运行,对比模型使用NVFP4,精度条件不同。
4. 下载与运行方法
权重可从Hugging Face按Apache 2.0许可证下载。Tinker提供推理和微调服务。
模型卡列出了对内存32GB及以上的Apple芯片设备的支持,并建议其他GPU具备32GB及以上显存。在Apple芯片设备上可使用Ollama,运行量化GGUF格式时可使用llama.cpp。
模型仓库的对话模板将推理强度名称映射到数值。定义该映射的原始代码如下。
{%- set effort_map = {"none": 0.0, "minimal": 0.1, "low": 0.2, "medium": 0.7, "high": 0.9, "xhigh": 0.99, "max": 0.99} -%}模型卡说明了模型在多轮对话、复杂指令及非英语语言方面的弱点。针对反复推理以及未经确认的文件删除和覆盖,建议设置输出与操作次数上限,在沙箱中运行,并在破坏性操作前获取确认。
Inkling 2 Mini的核心在于,不是将大型模型整体搬到本地,而是让用户在小型设备上试用以循环计算增强编程推理的开放权重。