本地模型推理引擎 TensorSharp 扩展了让 Muse Spark 816B 在多块 GPU 上协同运行的原生执行器(引擎内置的执行组件)。在约 10 块 GPU 的服务器上部署该模型的团队,可以根据提示词处理或响应生成任务选择并行模式。
一览
层切分将模型的各层分配给不同 GPU,张量并行则由多块 GPU 分担同一层的计算。
表:测量环境与对象
条件:相同模型、机器和请求下的自测。取 3 次重复测量的中位数(中间值),llama.cpp 张量切分为 2 次。GPU 间无法直接访问内存,需经由主机内存,且 llama.cpp 构建时未启用 NCCL。
| 项目 | 内容 |
|---|---|
| GPU | 10 块 A40,每块 46 GB |
| 共同设置 | 上下文 32,768 个词元,KV 缓存(存储对话计算中间结果的内存),flash attention(减少内存搬运的注意力计算方式),专家组件全部位于 GPU 显存 |
性能:层切分擅长提示词处理,张量并行擅长生成
报告于 10 月 22 日发布。预填充是先处理输入的阶段,解码是逐个词元生成响应的阶段。
表:各并行模式的性能对比
条件:对比上述环境中的对应模式。倍数为 TensorSharp÷llama.cpp,1.0 倍表示相同性能。
单位:吞吐量为 tok/s,倍数为倍。
| 场景 | 层切分 TS / llama.cpp | 倍数 | 张量并行 TS / llama.cpp | 倍数 |
|---|---|---|---|---|
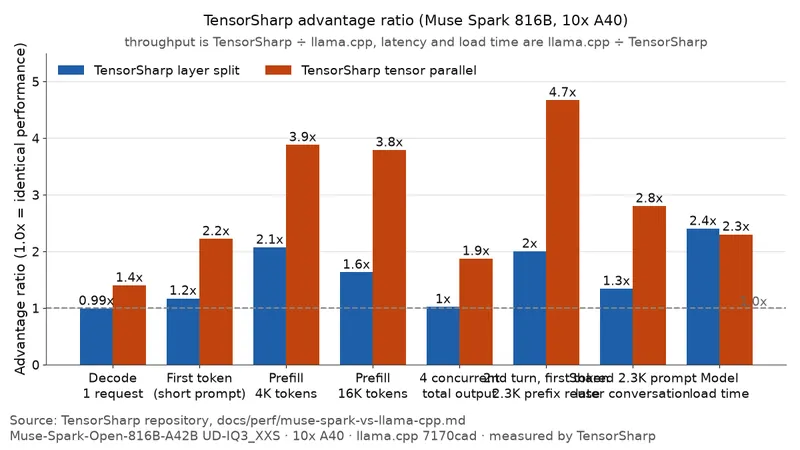
| 单请求解码 | 16.69 / 16.79 | 0.99 | 22.63 / 16.19 | 1.40 |
| 预填充,4K 词元提示词 | 999.7 / 483.2 | 2.07 | 294.4 / 75.9 | 3.88 |
| 4 个并发请求的总输出 | 33.65 / 33.04 | 1.02 | 45.73 / 24.49 | 1.87 |
柱状图展示了各模式的不同优势。据报告,层切分时各 GPU 可重叠处理输入批次,但单请求解码时词元需依次经过 10 块 GPU,因此两个引擎表现相近。
张量并行时,TensorSharp 通过 GPU 间通信库 NCCL 的共享内存进行归约,llama.cpp 则在不使用 NCCL 的情况下复制并归约。据报告,TensorSharp 的归约带宽约为 1.8 GB/s。Muse Spark 将各专家的输出归一化后再合并,传输量为归约结果的 8 倍,因此张量并行的预填充比层切分慢。
答案质量:固定 wikitext-2 正确词元的评估与自有答案检查
固定正确词元后,对比下一个词元的概率分布。采用了衡量分布差异的 KL 散度,以及最高概率词元相同的比例,即首选词元一致率。
表:wikitext-2 下一个词元分布对比
条件:TensorSharp 自测。以相同词元 ID 评估 wikitext-2 的 12,276 个位置,基线为 llama.cpp 使用 512 词元微批次(一次计算的小批输入)的运行结果。
| 指标 | llama.cpp 512 词元 | llama.cpp 2048 词元 | TensorSharp 层切分 | TensorSharp 张量并行 |
|---|---|---|---|---|
| 平均 KL 散度 | 基线 | 0.002818 | 0.002590 | 0.003061 |
| 最大 KL 散度 | 基线 | 0.764 | 0.299 | 1.641 |
| 首选词元一致率 | 基线 | 98.62% | 98.84% | 98.82% |
以 llama.cpp 两次运行间的差异为参照,TensorSharp 层切分的分布差异更小。张量并行的平均 KL 散度高出 9%,最大值也更大,但首选词元一致率更好。报告将这一差异与预填充阶段以 BF16 精度归约各专家部分结果的路径联系起来。
在各运行一次的 14 项自有集成检查中,张量并行全部通过,层切分通过 13 项,llama.cpp 的两种模式均通过 12 项。这不是通用模型质量测试。llama.cpp 的两种模式均未通过缓存复用检查。对于请求到达时间不同的检查,TensorSharp 层切分和 llama.cpp 两种模式均未通过,但报告称,这是因选择最高概率词元而在 512 词元前结束,并非引擎错误。
有哪些变化
通过处理 GPU 连接限制导致的中断,并将执行器上限从 8 块提高到 16 块,解决了这台机器上两种模式均无法运行的问题。
报告称,调整输入批次大小后,16K 调用耗时从 15.3 秒降至 10.2 秒。生成则从每秒 1.9~2.4 个词元的托管路径迁移至原生张量并行。
如何试用
代码位于 main。复现配置为 UD-IQ3_XXS、KV 缓存 F16、启用 flash attention。对比版本为 llama.cpp 7170cad。
MAX_CONTEXT=32768 TS_MUSE_SPARK_PLAN_SLOTS=5 TS_CODE_EXEC=0 \
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model <shard 1> \
  --backend ggml_cuda --layer-split 10 --no-webui --no-skills --no-multi-agent
改为 --tp 10 即为张量并行。llama.cpp 对应的选项分别是 -sm layer 和 -sm tensor。复现脚本为 eng/muse-spark-bench.py。
局限
图像输入、推测解码、将专家组件卸载到 CPU、超过 16K 词元的上下文,以及其他 GPU 配置均不在测量范围内。
提示词较长的任务值得先尝试层切分,交互式响应与并发请求则值得先尝试张量并行。