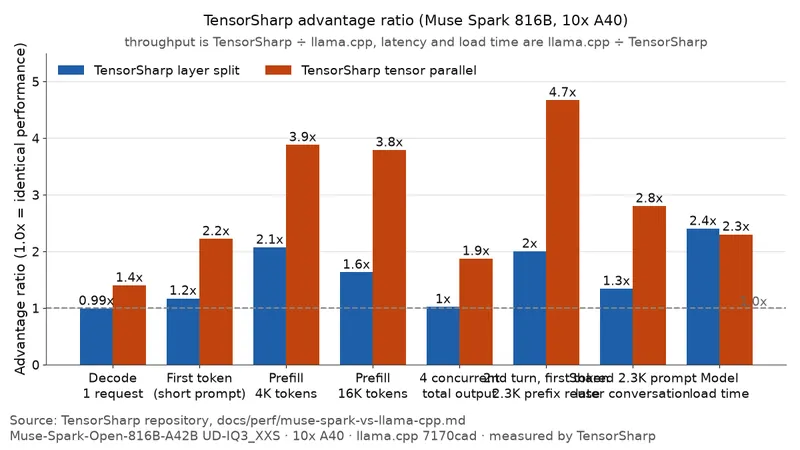
ローカルモデル推論エンジンTensorSharpが、Muse Spark 816Bを複数のGPUで動かすネイティブ実行器(エンジン内蔵の実行コンポーネント)を拡張した。GPU 10枚規模のサーバーにこのモデルを載せるチームは、プロンプト処理と応答生成のうち、作業に適した並列モードを選べる。
概要
レイヤー分割はモデルの層をGPUごとに割り当て、テンソル並列は1つの層の計算をGPU間で分担する。
表:測定環境と対象
条件:同一モデル・マシン・リクエストでの独自測定。3回繰り返した中央値(中央の値)で、llama.cppのテンソル分割は2回。GPU間の直接メモリアクセスができずホストメモリを経由し、llama.cppはNCCLなしでビルドした。
| 項目 | 内容 |
|---|---|
| GPU | 10枚のA40、各46 GB |
| 共通設定 | コンテキスト32,768トークン、KVキャッシュ(会話計算の中間結果を保存するメモリ)、flash attention(メモリ移動を減らすアテンション計算方式)、エキスパート構成要素をすべてGPUメモリに配置 |
性能:レイヤー分割はプロンプト、テンソル並列は生成
10月22日に公開された報告書だ。プリフィルは入力を先に処理する段階、デコードは応答を1トークンずつ生成する段階を指す。
表:並列モード別の性能比較
条件:上記環境で対応するモードを比較。倍率はTensorSharp÷llama.cppで、1.0倍は同等。
単位:スループットはtok/s、倍率は倍。
| シナリオ | レイヤー分割 TS / llama.cpp | 倍率 | テンソル並列 TS / llama.cpp | 倍率 |
|---|---|---|---|---|
| 単一リクエストのデコード | 16.69 / 16.79 | 0.99 | 22.63 / 16.19 | 1.40 |
| プリフィル、4Kトークンのプロンプト | 999.7 / 483.2 | 2.07 | 294.4 / 75.9 | 3.88 |
| 同時4リクエストの総出力 | 33.65 / 33.04 | 1.02 | 45.73 / 24.49 | 1.87 |
棒グラフはモード別の強みを示している。報告書によると、レイヤー分割ではGPUが入力バッチを重ねて処理するが、単一リクエストのデコードではトークンが10枚を順番に通るため、両エンジンは同程度だった。
テンソル並列では、TensorSharpはGPU間通信ライブラリNCCLの共有メモリで集約し、llama.cppはNCCLなしでコピー・集約する。報告書によると、TensorSharpの集約帯域幅は約1.8 GB/sだ。Muse Sparkはエキスパート別の出力を正規化してから結合し、集約結果の8倍を転送するため、テンソル並列のプリフィルはレイヤー分割より遅い。
正解品質:wikitext-2の正解トークン固定評価と独自の正解検査
正解トークンを固定し、次のトークンの確率分布を比較した。分布の差を測るKLダイバージェンスと、最高確率のトークンが一致する割合であるトップトークン一致率を用いた。
表:wikitext-2の次トークン分布比較
条件:TensorSharpの独自測定。wikitext-2の12,276か所を同一トークンIDで評価し、ベースラインはllama.cppの512トークンのマイクロバッチ(一度に計算する小さな入力のまとまり)実行。
| 測定 | llama.cpp 512トークン | llama.cpp 2048トークン | TensorSharp レイヤー分割 | TensorSharp テンソル並列 |
|---|---|---|---|---|
| KLダイバージェンス平均 | ベースライン | 0.002818 | 0.002590 | 0.003061 |
| KLダイバージェンス最大 | ベースライン | 0.764 | 0.299 | 1.641 |
| トップトークン一致率 | ベースライン | 98.62% | 98.84% | 98.82% |
llama.cppの2つの実行間の差を基準にすると、TensorSharpのレイヤー分割の分布差はより小さかった。テンソル並列は平均KLダイバージェンスが9%高く、最大値も大きかったが、トップトークン一致率は良好だった。報告書は、この差をプリフィルのエキスパート別部分結果をBF16精度で集約する経路と関連付けている。
各1回実行した独自の統合検査14件では、テンソル並列が全件合格し、レイヤー分割は13件、llama.cppは両モードとも12件だった。一般的なモデル品質検査ではない。llama.cppは両モードでキャッシュ再利用に失敗した。到着時点の異なるリクエストの検査では、TensorSharpのレイヤー分割とllama.cppの両モードが失敗したが、報告書によると最高確率のトークンを選んで512トークンより前に終了したケースで、エンジンのエラーではなかった。
何が変わったか
GPU接続上限による停止に対処し、実行器の上限を8枚から16枚に増やすことで、このマシンで両モードを実行できなかった問題を解消した。
報告書は、入力バッチサイズの調整により16K呼び出しが15.3秒から10.2秒に短縮されたと述べている。生成は、毎秒1.9~2.4トークンだったマネージド経路からネイティブのテンソル並列に移した。
試すには
コードはmainにある。再現設定はUD-IQ3_XXS、KVキャッシュF16、flash attention有効だ。比較対象はllama.cpp 7170cad。
MAX_CONTEXT=32768 TS_MUSE_SPARK_PLAN_SLOTS=5 TS_CODE_EXEC=0 \
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model <shard 1> \
  --backend ggml_cuda --layer-split 10 --no-webui --no-skills --no-multi-agent
--tp 10に変えるとテンソル並列になる。llama.cppはそれぞれ-sm layer・-sm tensorだ。再現スクリプトはeng/muse-spark-bench.py。
限界
画像入力、投機的デコード、CPUへのエキスパート構成要素のオフロード、16Kトークンを超えるコンテキスト、他のGPU構成は測定範囲に含まれていない。
大きなプロンプトを扱う作業ではレイヤー分割を、対話型の応答や同時リクエストではテンソル並列を先に試す価値がある。