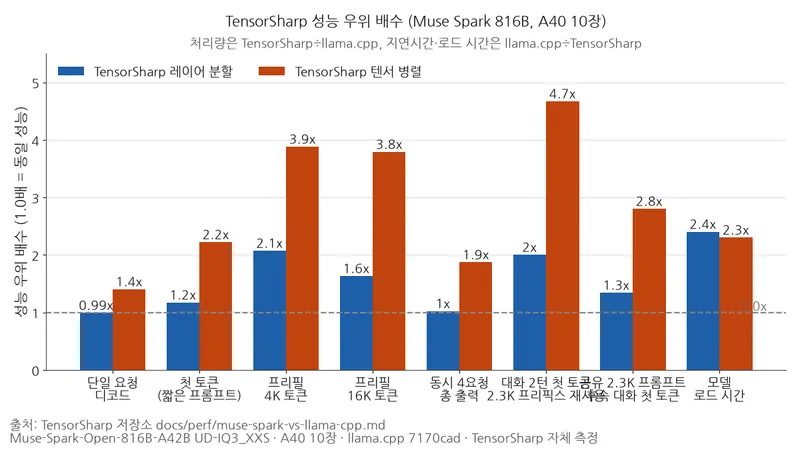
로컬 모델 추론 엔진 TensorSharp가 Muse Spark 816B를 여러 GPU에서 함께 돌리는 네이티브 실행기(엔진에 내장된 실행 구성요소)를 확장했다. 10장급 GPU 서버에 이 모델을 올리는 팀은 프롬프트 처리와 응답 생성 중 작업에 맞는 병렬 모드를 고를 수 있다.
한눈에 보기
레이어 분할은 모델 층을 GPU별로 맡기고, 텐서 병렬은 한 층의 계산을 GPU들이 나눈다.
표: 측정 환경과 대상
조건: 동일 모델·머신·요청의 자체 측정. 3회 반복 중앙값(가운데 값), llama.cpp 텐서 분할은 2회. GPU 간 직접 메모리 접근이 안 돼 호스트 메모리를 경유하며 llama.cpp는 NCCL 없이 빌드했다.
| 항목 | 내용 |
|---|---|
| GPU | 10장 A40, 각 46 GB |
| 공통 설정 | 컨텍스트 32,768 토큰, KV 캐시(대화 계산의 중간 결과를 저장하는 메모리), flash attention(메모리 이동을 줄이는 어텐션 계산 방식), 전문가 구성요소 전부 GPU 메모리 |
성능: 레이어 분할은 프롬프트, 텐서 병렬은 생성
10월 22일 공개된 보고서다. 프리필은 입력을 먼저 처리하는 단계, 디코드는 응답을 한 토큰씩 생성하는 단계다.
표: 병렬 모드별 성능 비교
조건: 위 환경의 대응 모드 비교. 배수는 TensorSharp÷llama.cpp, 1.0배는 동등.
단위: 처리량은 tok/s, 배수는 배.
| 시나리오 | 레이어 분할 TS / llama.cpp | 배수 | 텐서 병렬 TS / llama.cpp | 배수 |
|---|---|---|---|---|
| 단일 요청 디코드 | 16.69 / 16.79 | 0.99 | 22.63 / 16.19 | 1.40 |
| 프리필, 4K 토큰 프롬프트 | 999.7 / 483.2 | 2.07 | 294.4 / 75.9 | 3.88 |
| 동시 4요청 총 출력 | 33.65 / 33.04 | 1.02 | 45.73 / 24.49 | 1.87 |
막대 그래프는 모드별 강점을 갈라 보인다. 보고서에 따르면 레이어 분할은 GPU들이 입력 묶음을 겹쳐 처리하지만, 단일 요청 디코드는 토큰이 10장을 차례로 지나가 두 엔진이 비슷했다.
텐서 병렬에서 TensorSharp는 GPU 간 통신 라이브러리 NCCL의 공유 메모리로 합산하고 llama.cpp는 NCCL 없이 복사·합산한다. 보고서에 따르면 TensorSharp의 합산 대역폭은 약 1.8 GB/s다. Muse Spark는 전문가별 출력을 정규화한 뒤 합쳐 합산 결과의 8배를 전송하므로, 텐서 병렬의 프리필은 레이어 분할보다 느리다.
정답 품질: wikitext-2 정답 토큰 고정 평가와 자체 정답 검사
정답 토큰을 고정해 다음 토큰 확률분포를 비교했다. 분포 차이를 재는 KL 발산과, 가장 높은 확률을 준 토큰이 같은 비율인 최상위 토큰 일치율을 썼다.
표: wikitext-2 다음 토큰 분포 비교
조건: TensorSharp 자체 측정. wikitext-2의 12,276개 위치를 동일 토큰 ID로 평가, 기준선은 llama.cpp의 512토큰 마이크로배치(한 번에 계산하는 작은 입력 묶음) 실행.
| 측정 | llama.cpp 512토큰 | llama.cpp 2048토큰 | TensorSharp 레이어 분할 | TensorSharp 텐서 병렬 |
|---|---|---|---|---|
| KL 발산 평균 | 기준선 | 0.002818 | 0.002590 | 0.003061 |
| KL 발산 최대 | 기준선 | 0.764 | 0.299 | 1.641 |
| 최상위 토큰 일치율 | 기준선 | 98.62% | 98.84% | 98.82% |
llama.cpp의 두 실행 간 차이를 기준으로 TensorSharp 레이어 분할의 분포 차이는 더 작았다. 텐서 병렬은 평균 KL 발산이 9% 높고 최대값도 컸지만 최상위 토큰 일치율은 더 좋았다. 보고서는 이 차이를 프리필의 전문가별 부분 결과를 BF16 정밀도로 합산하는 경로와 연결한다.
각각 한 번 실행한 자체 통합 검사 14개에서는 텐서 병렬이 모두 통과했고, 레이어 분할은 13개, llama.cpp는 두 모드 모두 12개였다. 일반 모델 품질 검사는 아니다. llama.cpp는 두 모드에서 캐시 재사용에 실패했다. 도착 시점이 다른 요청 검사는 TensorSharp 레이어 분할과 llama.cpp 두 모드가 실패했지만, 보고서에 따르면 최상위 확률 토큰을 고르다 512토큰 전에 종료한 경우로 엔진 오류가 아니었다.
무엇이 달라졌나
GPU 연결 한도로 인한 중단을 처리하고 실행기 상한을 8장에서 16장으로 늘려, 이 머신에서 두 모드가 실행되지 않던 문제를 해소했다.
보고서는 입력 묶음 크기 조정으로 16K 호출이 15.3초에서 10.2초로 줄었다고 밝혔다. 생성은 초당 1.9~2.4토큰이던 관리 경로에서 네이티브 텐서 병렬로 옮겼다.
써 보려면
코드는 main에 있다. 재현 설정은 UD-IQ3_XXS, KV 캐시 F16, flash attention 켬이다. 비교본은 llama.cpp 7170cad다.
MAX_CONTEXT=32768 TS_MUSE_SPARK_PLAN_SLOTS=5 TS_CODE_EXEC=0 \
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model <shard 1> \
  --backend ggml_cuda --layer-split 10 --no-webui --no-skills --no-multi-agent
--tp 10으로 바꾸면 텐서 병렬이다. llama.cpp는 각각 -sm layer·-sm tensor다. 재현 스크립트는 eng/muse-spark-bench.py다.
한계
이미지 입력, 추측 디코딩, CPU로의 전문가 구성요소 오프로드, 16K 토큰을 넘는 컨텍스트, 다른 GPU 구성은 측정 범위에 들어 있지 않다.
프롬프트가 큰 작업에는 레이어 분할을, 대화형 응답과 동시 요청에는 텐서 병렬을 먼저 시험할 만하다.