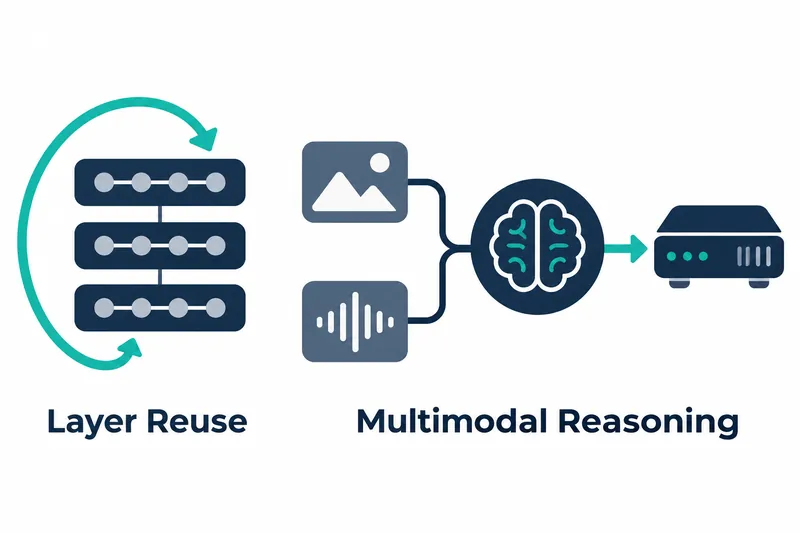
SenseNova于11月17日发布了一款约90亿参数的模型,可接收图像和文本并生成文本。该架构复用中间层的权重,即通过训练确定的模型内部数值,以增加计算深度。开发者可将其用于长上下文、编程和工具使用任务,并通过4位权重配置调节部署内存。
1. 复用相同层以增加计算深度
模型存储32个不同的解码器层,即将输入转化为结果的计算阶段,并将其中的24个中间层执行两次。据公司说明,每处理一次输入会进行56次层计算。这种方式不是堆叠新层,而是再次经过相同的处理区段来加深计算。
输入为文本和图像,输出为文本。模型卡称其支持最长512K token的上下文,训练也包含代码和工具使用过程。因此,其目标不仅是通用对话,也包括编程、智能体和数据分析任务。
2. 公司公布的基准测试与循环次数实验
根据公司公布的结果,正式版的AutomationBench成绩较预览版从14.33升至36.67,Terminal-Bench 2.1从40.45升至59.55。公司将智能体、编程和数据分析任务的改进列为正式版的主要变化。
根据公司公布的结果,GAIA从37.86升至69.90,BIRD从71.38升至72.34。后者提升了0.96个百分点。
根据公司公布的结果,与Qwen3.8-27B相比,两者的AutomationBench成绩均为36.67。
在与同一竞品的比较中,公司公布的AIDABench成绩为正式版65.31、对方65.01,NL2Repo则为41.36对44.60。不同任务中各有领先与落后,因此有必要针对拟采用的任务进行比较。
循环次数实验以计算一次的配置为基准,固定训练数据和其他设置。根据公司公布的结果,重复三次时,AIDABench-QA和Workbuddy-office较基准分别提高6.42%和16.93%。
根据公司公布的结果,重复四次时,LiveCodeBench V6和AIDABench数据可视化较基准分别提高8.10%和8.55%。从两次增加至四次的额外提升分别为1.04和1.35个百分点。各任务的最高点分别出现在三次和四次,重复计算的效果也因任务而异。
3. 节省内存与增加计算的权衡
据公司公布的数据,采用4位量化,即以较少位数低精度存储数值时,权重约为4.9 GB。官方4位量化版也从发布当天起提供。以下是在使用4位权重和8位KV缓存时,不同上下文长度所需的最低GPU内存估算;KV缓存用于存储并复用中间计算值。
表:不同上下文长度的最低GPU内存估算
条件:4位权重、8位KV缓存,公司模型卡估算值
单位:GiB,所有数值均为近似值
| 上下文长度 | 最低GPU内存 |
|---|---|
| 64K | 10 |
| 128K | 12 |
| 256K | 15 |
根据公司公布的数据,将KV缓存降至4位后,按相同上下文长度顺序,所需内存约为9、10、12 GiB。即使缩小权重存储,仍需单独预留处理长输入的内存。
循环架构的收益在于复用需要存储的权重,代价则是重复计算相同的中间层。公司考虑到推理效率,将预览版和正式版的默认循环次数均设为两次。
4. 安装与部署所需条件
模型卡确认的预览版环境使用Transformers 5.18.0和PyTorch 2.11.0。
该环境的CUDA版本为13.0。说明要求先安装与之兼容的训练框架构建版本。
加载模型时,需设置为执行仓库中的自定义实现代码。其余依赖的安装示例如下。
python -m pip install "transformers==5.18.0" accelerate safetensorsLightLLM提供了使用四块GPU的部署示例。SGLang则指向包含该实现的第47281号变更提案版本。
vLLM指向第64832号变更提案版本。模型卡说明,这些部署命令取自预览版示例,应替换为正式版路径使用,正式版引擎版本和配置将另行更新。
下载权重需登录并同意使用条款。项目许可证为Apache 2.0。
5. 按任务判断适用性
公司表示,模型可能遗漏复杂工具定义或包含多项约束的指令中的要求,在编程和通用智能体任务上的表现也可能不稳定。制作包含复杂三维场景和动画的网页时,有时需要多轮修改。
选择该模型的标准不只是参数量少,还在于能否同时承担重复计算带来的任务表现与长上下文的内存成本。