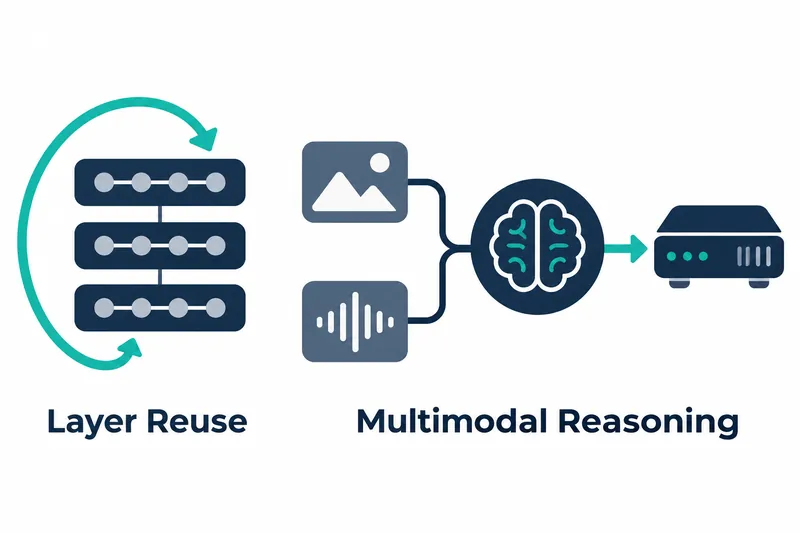
SenseNova가 11월 17일 이미지와 텍스트를 입력받아 글을 생성하는 약 90억 파라미터 모델을 공개했다. 가운데 층의 가중치, 학습으로 정해지는 모델 내부 수치를 재사용해 계산 깊이를 늘린 구조로, 개발자는 긴 문맥·코딩·도구 사용 과제에 활용할 수 있고 4비트 가중치 구성으로 배포 메모리도 조절할 수 있다.
1. 같은 층을 재사용해 계산 깊이 확장
모델은 서로 다른 디코더 층, 입력을 결과로 바꾸는 계산 단계 32개를 저장하고, 그중 가운데 24개 층을 두 차례 실행한다. 회사 설명에 따르면 입력을 한 번 처리할 때 층 계산은 56회 이뤄진다. 새 층을 더 쌓는 대신 같은 작업 구간을 다시 통과해 계산을 깊게 하는 방식이다.
입력은 텍스트와 이미지이고 출력은 텍스트다. 모델 카드는 최대 512K 토큰 문맥을 지원한다고 설명하며, 학습에는 코드와 도구 사용 과정도 포함됐다고 밝힌다. 따라서 범용 대화뿐 아니라 코딩, 에이전트, 데이터 분석 과제도 겨냥한다.
2. 회사 발표 벤치마크, 성능을 같은 기준으로 재는 시험과 순환 횟수 실험
회사 발표 기준, 정식판은 사전판보다 AutomationBench가 14.33에서 36.67로, Terminal-Bench 2.1이 40.45에서 59.55로 올랐다. 회사는 에이전트·코딩·데이터 분석 과제의 개선을 정식판의 주요 변화로 제시했다.
회사 발표 기준 GAIA는 37.86에서 69.90으로, BIRD는 71.38에서 72.34로 올랐다. 후자의 상승 폭은 0.96%포인트다.
회사 발표 기준 Qwen3.8-27B와 비교하면 AutomationBench는 양쪽 모두 36.67이다.
같은 경쟁 모델과 비교한 회사 발표 기준 AIDABench는 정식판 65.31 대 상대 65.01, NL2Repo는 41.36 대 44.60이다. 과제에 따라 앞서거나 뒤지는 결과여서, 도입하려는 작업에 맞춰 비교할 이유가 있다.
순환 횟수 실험은 한 번 계산하는 구성을 기준으로 학습 데이터와 다른 설정을 고정했다. 회사 발표 기준 AIDABench-QA와 Workbuddy-office는 세 번 반복할 때 각각 기준 대비 6.42%, 16.93% 높았다.
회사 발표 기준 LiveCodeBench V6와 AIDABench 데이터 시각화는 네 번 반복할 때 기준 대비 각각 8.10%, 8.55% 높았다. 두 번에서 네 번으로 늘릴 때의 추가 상승은 각각 1.04%포인트와 1.35%포인트였다. 과제별 최고점이 세 번과 네 번으로 달라, 반복 계산의 효과도 작업에 따라 달랐다.
3. 메모리 절감과 추가 계산의 맞교환
회사 발표 기준 가중치를 낮은 정밀도로 저장하는 4비트 양자화, 수치를 적은 비트로 저장하는 방식 시 가중치는 약 4.9 GB다. 공식 4비트 양자화판도 공개 당일부터 제공한다. 아래는 4비트 가중치와 8비트 KV 캐시, 중간 계산값을 저장해 재사용하는 메모리를 사용하는 경우의 문맥 길이별 최소 GPU 메모리 추정치다.
표: 문맥 길이에 따른 최소 GPU 메모리 추정
조건: 4비트 가중치, 8비트 KV 캐시, 회사 모델 카드 추정치
단위: GiB, 모든 값은 근삿값
| 문맥 길이 | 최소 GPU 메모리 |
|---|---|
| 64K | 10 |
| 128K | 12 |
| 256K | 15 |
회사 발표 기준 KV 캐시를 4비트로 낮추면 같은 문맥 길이 순서로 약 9, 10, 12 GiB가 필요하다. 가중치를 작게 저장해도 긴 입력을 처리하는 메모리는 별도로 확보해야 한다.
순환 구조의 이익은 저장할 가중치를 재사용한다는 데 있고, 대가는 같은 중간 층을 반복 계산한다는 데 있다. 회사는 추론 효율을 고려해 사전판과 정식판의 기본 순환 횟수를 두 번으로 설정했다.
4. 설치와 배포에 필요한 조건
모델 카드가 확인한 사전판 환경은 Transformers 5.18.0과 PyTorch 2.11.0을 사용한다.
이 환경의 CUDA 버전은 13.0이다. 먼저 이에 호환되는 학습 프레임워크 빌드를 설치하도록 안내한다.
모델을 불러올 때는 저장소의 맞춤 구현 코드를 실행하도록 설정한다. 나머지 의존성 설치 예시는 다음과 같다.
python -m pip install "transformers==5.18.0" accelerate safetensorsLightLLM은 GPU 네 개를 쓰는 배포 예제가 있다. SGLang은 구현이 포함된 변경 제안 47281번의 버전을 안내한다.
vLLM은 변경 제안 64832번의 버전을 안내한다. 이 배포 명령들은 사전판 예제에서 가져왔으며, 정식판 경로로 바꾸어 사용하고 정식판 엔진 버전과 설정은 추가 갱신할 예정이라고 모델 카드는 설명한다.
가중치를 받으려면 로그인과 이용 조건 동의가 필요하다. 프로젝트 라이선스는 Apache 2.0이다.
5. 과제에 따른 활용 판단
회사는 복잡한 도구 정의나 여러 제약이 있는 지시에서 요구사항을 놓칠 수 있고, 코딩과 범용 에이전트 과제의 성능이 일정하지 않을 수 있다고 밝혔다. 복잡한 3차원 장면과 애니메이션을 포함한 웹 제작은 여러 차례 수정이 필요한 경우도 있다.
이 모델의 선택 기준은 적은 파라미터 수만이 아니라, 반복 계산으로 얻는 과제별 성능과 긴 문맥의 메모리 비용을 함께 감당할 수 있는지다.