Alpha-Innovator 发布了支持并行分工和内部验证的科学智能体 Sage-A1.5。开发者可自行部署 Apache-2.0 权重,执行搜索与编程任务,并按需开启辅助智能体和自我审查功能。
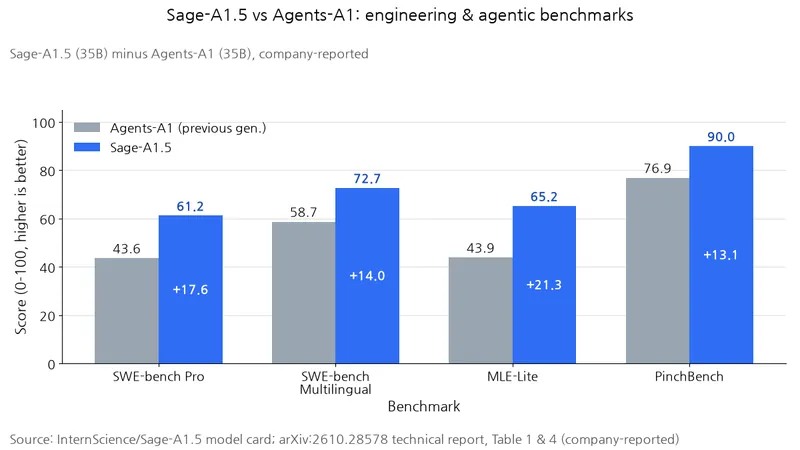
据公司公布的数据,相比上一代 Agents-A1,代码修改评测 SWE-bench Pro 从 43.6 升至 61.2,机器学习任务评测 MLE-Lite 从 43.9 升至 65.2。技术报告于 2026年10月20日上传至 arXiv。
据研究团队介绍,模型会拆解任务,并行启动辅助智能体,并自行重新核查受阻环节的依据。
测量方法
搜索评测使用搜索、访问和代码工具。BrowseComp 中,工具调用超过 300 次或达到上下文上限时,会从头重跑,最多允许 5 轮。SWE 系列在 mini-SWE-agent 中开启自动上下文压缩,并屏蔽可能泄露答案的 Git 历史和网络访问。MLE-Bench-Lite 在 22 场 Kaggle 竞赛中,每项任务使用一张 H200 GPU,耗时 12 小时。达到铜牌及以上的比例取不同随机条件下 3 次运行的平均值。
结果
表:主要智能体与工程基准对比
条件:从公司模型卡 Table 1 中选取与上一代的代表性对比。
单位:分
| 基准 | Sage-A1.5 | Agents-A1 |
|---|---|---|
| MLE-Lite | 65.2 | 43.9 |
| SWE-bench Pro | 61.2 | 43.6 |
SWE-bench Pro 评估复杂代码仓库的修改任务。两项指标的提升表明,代码修改以及模型训练与提交任务有所改善。
科学研究结果
表:科学研究与科学智能体基准对比
条件:从公司模型卡 Table 1 中选取科学研究指标及部分对比模型。
单位:分
| 基准 | Sage-A1.5 | Agents-A1 | Ornith-1.5 | Kimi-K3 |
|---|---|---|---|---|
| FrontierScience-Research | 48.3 | 40.0 | 6.7 | 21.7 |
| CMT | 80.0 | 72.0 | 26.0 | 34.0 |
| CritPt | 20.0 | 4.3 | 2.9 | 23.4 |
FrontierScience-Research 涵盖博士级研究子任务,CMT 涵盖凝聚态理论问题。虽然在这两项指标上领先,但在通过计算验证答案的物理研究评测 CritPt 中落后于大型对比模型。研究辅助工作也应根据领域和验证方式选择评测。
为何出现这些差异
Sage-A1.5 是基于 Qwen3.6 和上海 AI 实验室 Agents-A1 的 35B 混合专家模型。公司将改进方向描述为“能力组合”。编排将问题分配给拥有独立上下文的辅助智能体,再汇总证据。验证则在没有外部裁判的情况下,通过内部推理复查依据和失败之处。
据报告第 2.6 节介绍,在示例学习后,训练结合基于结果的强化学习与领域教师的 token 级过程指导。下述模式切换实验,应与证明相较上一代整体提升的全部原因的实验区分开来。
表:不同编排模式的评测结果
条件:技术报告 Table 4。在同一 Sage-A1.5 模型上,仅改变是否配备工具所得的数值。
单位:分
| 配置 | BrowseComp | DeepResearch-Bench2 |
|---|---|---|
| 关闭编排 | 81.7 | 43.7 |
| 开启编排 | 82.8 | 47.5 |
在公司评测中,搜索难寻答案的 BrowseComp 提高了 1.1 个百分点,报告生成评测 DeepResearch-Bench2 提高了 3.8 分。研究团队认为,这符合将探索结果整合为报告的作用。
表:不同验证模式的评测结果
条件:技术报告 Table 5 中的教师模型评测。输出 token 和对话轮数以两种模式均给出答案的配对尝试为准。
单位:分、token、轮
| 配置 | BrowseComp | 输出 token | 对话轮数 |
|---|---|---|---|
| 普通模式 | 81.0 | 23,245 | 84.81 |
| 验证模式 | 85.5 | 21,962 | 82.14 |
验证实验中,准确率上升的同时,输出 token 和轮数有所减少。研究团队认为,这符合减少无效探索的设计目标。
选择依据
两种模式默认均关闭。并行执行需要注册 spawn_subagent 工具,并配备管理执行过程的运行框架。辅助智能体无法查看主对话,因此必须传入问题、背景和所需输出格式。
验证按请求开启。模型卡示例的部分请求体如下。系统消息为空时,请求会以 HTTP 400 被拒绝。
{
  "messages": [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Find the population of Shanghai and cross-check it."}
  ],
  "chat_template_kwargs": {"verification": true}
}
最终模型通过并行化提高了搜索与报告得分,而验证带来的准确率提升和生成成本下降则在教师模型中得到确认。