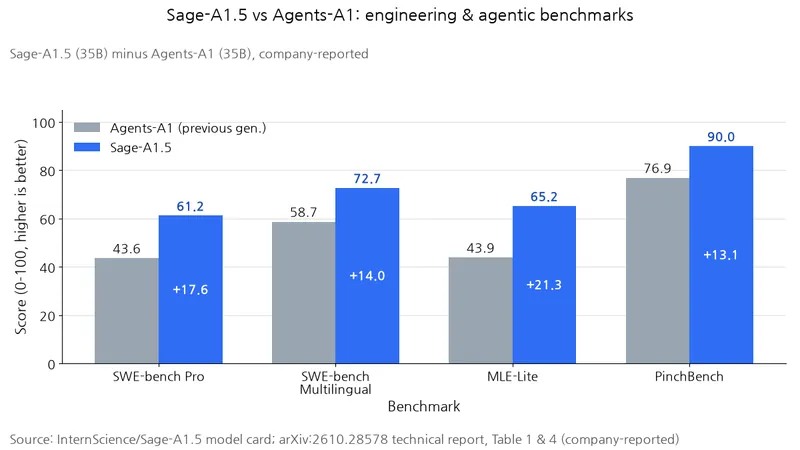
Alpha-Innovatorが並列の作業分担と内部検証を支援する科学エージェントSage-A1.5を公開した。開発者はApache-2.0の重みを自ら稼働させて検索・コーディング作業を任せ、必要に応じて補助エージェントと自己レビュー機能を有効にできる。
同社の発表では、前世代のAgents-A1と比べ、コード修正評価のSWE-bench Proは43.6から61.2に、機械学習タスク評価のMLE-Liteは43.9から65.2に上がった。技術報告書は2026年10月20日にarXivで公開された。
研究チームの説明によると、モデルは作業を分解して補助エージェントを並列に起動し、行き詰まった箇所の根拠を自ら再確認する。
測定方法
検索評価には検索・閲覧・コードのツールを使う。BrowseCompではツール呼び出しが300回を超えるかコンテキスト上限に達すると最初からやり直し、最大5ラウンドを認める。SWE系はmini-SWE-agentでコンテキストの自動圧縮を有効にし、正解が漏れ得るGit履歴とネットワークへのアクセスを遮断する。MLE-Bench-Liteは22のKaggleコンペでH200 GPUを1台使い、タスクごとに12時間をかける。銅メダル以上の割合を、乱数条件を変えた3回の実行の平均で示す。
結果
表:主要なエージェント・エンジニアリングベンチマークの比較
条件:同社モデルカードのTable 1から前世代との代表的な比較を抜粋。
単位:スコア
| ベンチマーク | Sage-A1.5 | Agents-A1 |
|---|---|---|
| MLE-Lite | 65.2 | 43.9 |
| SWE-bench Pro | 61.2 | 43.6 |
SWE-bench Proは複雑なリポジトリの修正タスクを評価する。両指標の上昇は、コード修正とモデルの学習・提出作業の改善を示す。
科学研究の結果
表:科学研究・科学エージェントベンチマークの比較
条件:同社モデルカードのTable 1から科学研究の指標と比較対象の一部を抜粋。
単位:スコア
| ベンチマーク | Sage-A1.5 | Agents-A1 | Ornith-1.5 | Kimi-K3 |
|---|---|---|---|---|
| FrontierScience-Research | 48.3 | 40.0 | 6.7 | 21.7 |
| CMT | 80.0 | 72.0 | 26.0 | 34.0 |
| CritPt | 20.0 | 4.3 | 2.9 | 23.4 |
FrontierScience-Researchは博士レベルの研究のサブタスク、CMTは凝縮系物質理論の問題を扱う。この2指標では上回るが、計算で答えを検証する物理研究評価のCritPtでは大規模な比較対象モデルに劣る。研究補助の業務も分野と検証方法に合わせて評価を選ぶ必要がある。
なぜ差が生じるのか
Sage-A1.5はQwen3.6と上海AIラボのAgents-A1を基盤とする35Bの混合エキスパートモデルだ。同社は改善の方向性を「能力の組み合わせ」と説明する。オーケストレーションは独立したコンテキストの補助エージェントに質問を振り分け、証拠を統合する。検証は外部の判定役を使わず、内部の推論で根拠と失敗を振り返る。
報告書の2.6節によると、例を使った学習の後、結果に基づく強化学習と分野別の教師によるトークン単位の過程指導を組み合わせる。以下のモード切り替え実験は、前世代からの全体的な向上の原因をすべて立証する実験とは区別する必要がある。
表:オーケストレーションのモード別評価結果
条件:技術報告書のTable 4。同一のSage-A1.5モデルでツールの有無だけを変えた値。
単位:スコア
| 構成 | BrowseComp | DeepResearch-Bench2 |
|---|---|---|
| オーケストレーション無効 | 81.7 | 43.7 |
| オーケストレーション有効 | 82.8 | 47.5 |
同社の評価では、見つけにくい答えを検索するBrowseCompは1.1%ポイント、レポート生成評価のDeepResearch-Bench2は3.8ポイント上がった。研究チームは、探索結果をレポートに統合する役割に合致すると解釈している。
表:検証のモード別評価結果
条件:技術報告書のTable 5にある教師モデルの評価。出力トークンと対話ターンは、両モードとも回答を出した対応する試行に基づく。
単位:スコア、トークン、ターン
| 構成 | BrowseComp | 出力トークン | 対話ターン |
|---|---|---|---|
| 通常モード | 81.0 | 23,245 | 84.81 |
| 検証モード | 85.5 | 21,962 | 82.14 |
検証実験では精度が上がる一方、出力トークンとターンが減った。研究チームは、非生産的な探索を減らす設計目標に合致すると解釈している。
選ぶ際の基準
両モードはデフォルトでは無効だ。並列実行にはspawn_subagentツールの登録と実行を管理するハーネスが必要になる。補助エージェントはメインの対話を見られないため、質問・背景・希望する出力形式をすべて渡す必要がある。
検証はリクエストごとに有効にする。モデルカードの例にあるリクエスト本文の一部は次のとおりだ。システムメッセージが空の場合、HTTP 400で拒否される。
{
  "messages": [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Find the population of Shanghai and cross-check it."}
  ],
  "chat_template_kwargs": {"verification": true}
}
最終モデルでは並列化で検索・レポートのスコアが上がり、検証による精度向上と生成コスト削減は教師モデルで確認された。