Alpha-Innovator가 병렬 작업 분담과 내부 검증을 지원하는 과학 에이전트 Sage-A1.5를 공개했다. 개발자는 Apache-2.0 가중치를 직접 띄워 검색·코딩 작업을 맡기고, 필요할 때 보조 에이전트와 자기 검토 기능을 켤 수 있다.
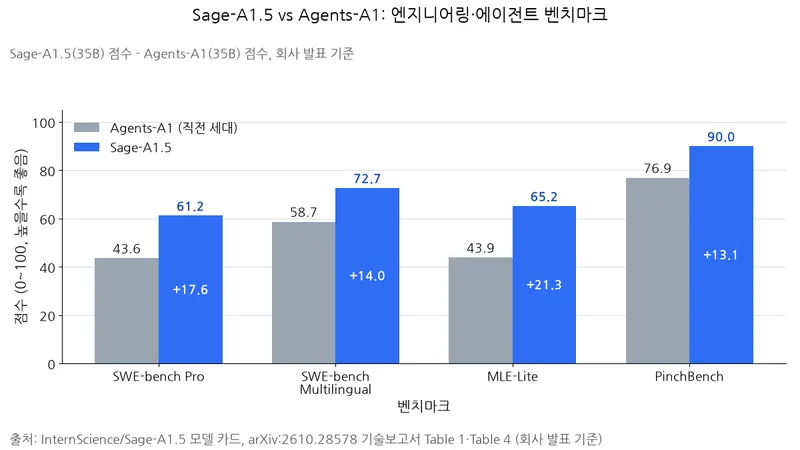
회사 발표 기준 직전 세대 Agents-A1 대비 코드 수정 평가 SWE-bench Pro는 43.6에서 61.2로, 머신러닝 과제 평가 MLE-Lite는 43.9에서 65.2로 올랐다. 기술보고서는 2026년 10월 20일 arXiv에 올라왔다.
연구팀 설명으로는 모델이 일을 분해해 보조 에이전트를 병렬로 띄우고, 막힌 지점의 근거를 스스로 다시 확인한다.
측정 방법
검색 평가는 검색·방문·코드 도구를 쓴다. BrowseComp에서는 도구 호출이 300회를 넘거나 컨텍스트 한도에 닿으면 처음부터 다시 돌리며 최대 5라운드를 허용한다. SWE 계열은 mini-SWE-agent에서 자동 컨텍스트 압축을 켜고, 정답이 드러날 수 있는 Git 이력과 네트워크 접근을 막는다. MLE-Bench-Lite는 22개 Kaggle 대회에서 H200 GPU 한 대로 과제당 12시간을 쓴다. 브론즈메달 이상 비율을 무작위 조건을 달리한 3회 실행의 평균으로 낸다.
결과
표: 주요 에이전트·엔지니어링 벤치마크 비교
조건: 회사 모델 카드 Table 1에서 직전 세대와의 대표 비교를 추림.
단위: 점수
| 벤치마크 | Sage-A1.5 | Agents-A1 |
|---|---|---|
| MLE-Lite | 65.2 | 43.9 |
| SWE-bench Pro | 61.2 | 43.6 |
SWE-bench Pro는 복잡한 저장소의 수정 과제를 평가한다. 두 지표의 상승은 코드 수정과 모델 학습·제출 작업의 개선을 보여준다.
과학 리서치 결과
표: 과학 리서치·과학 에이전트 벤치마크 비교
조건: 회사 모델 카드 Table 1에서 과학 연구 지표와 비교군 일부를 추림.
단위: 점수
| 벤치마크 | Sage-A1.5 | Agents-A1 | Ornith-1.5 | Kimi-K3 |
|---|---|---|---|---|
| FrontierScience-Research | 48.3 | 40.0 | 6.7 | 21.7 |
| CMT | 80.0 | 72.0 | 26.0 | 34.0 |
| CritPt | 20.0 | 4.3 | 2.9 | 23.4 |
FrontierScience-Research는 박사급 연구 하위 과제, CMT는 응집물질 이론 문제를 다룬다. 두 지표에서는 앞서지만 계산으로 답을 검증하는 물리 연구 평가 CritPt에서는 대규모 비교 모델에 뒤진다. 연구 보조 업무도 분야와 검증 방식에 맞춰 평가를 골라야 한다.
왜 이런 차이가 나나
Sage-A1.5는 Qwen3.6과 상하이 AI 랩의 Agents-A1 기반 35B 혼합 전문가 모델이다. 회사는 개선 방향을 ‘역량 조합’으로 설명한다. 오케스트레이션은 독립된 컨텍스트의 보조 에이전트에게 질문을 나누고 증거를 합친다. 검증은 외부 심판 없이 내부 추론에서 근거와 실패를 되짚는다.
보고서 2.6절에 따르면 예시 학습 뒤 결과 기반 강화학습과 분야별 교사의 토큰 단위 과정 지도를 결합한다. 아래 모드 전환 실험은 전 세대 대비 전체 향상의 원인을 모두 입증하는 실험과는 구분해야 한다.
표: 오케스트레이션 모드별 평가 결과
조건: 기술보고서 Table 4. Sage-A1.5 동일 모델에서 도구 유무만 바꾼 값.
단위: 점수
| 구성 | BrowseComp | DeepResearch-Bench2 |
|---|---|---|
| 오케스트레이션 끔 | 81.7 | 43.7 |
| 오케스트레이션 켬 | 82.8 | 47.5 |
회사 평가에서 찾기 어려운 답을 검색하는 BrowseComp는 1.1%포인트, 리포트 생성 평가 DeepResearch-Bench2는 3.8포인트 올랐다. 연구팀은 이를 탐사 결과를 리포트로 통합하는 역할에 부합한다고 해석한다.
표: 검증 모드별 평가 결과
조건: 기술보고서 Table 5의 교사 모델 평가. 출력 토큰과 대화 턴은 양쪽 모드 모두 답을 낸 짝지은 시도 기준.
단위: 점수, 토큰, 턴
| 구성 | BrowseComp | 출력 토큰 | 대화 턴 |
|---|---|---|---|
| 일반 모드 | 81.0 | 23,245 | 84.81 |
| 검증 모드 | 85.5 | 21,962 | 82.14 |
검증 실험에서는 정확도가 오르면서 출력 토큰과 턴이 줄었다. 연구팀은 비생산적 탐색을 줄이려는 설계 목표에 부합한다고 해석한다.
고를 때 기준
두 모드는 기본값이 꺼져 있다. 병렬 실행에는 spawn_subagent 도구 등록과 실행을 관리할 하네스가 필요하다. 보조 에이전트는 메인 대화를 볼 수 없어 질문·배경·원하는 출력 형태를 모두 넘겨야 한다.
검증은 요청별로 켠다. 모델 카드 예제의 요청 본문 일부는 다음과 같다. 시스템 메시지가 비어 있으면 HTTP 400으로 거절된다.
{
  "messages": [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Find the population of Shanghai and cross-check it."}
  ],
  "chat_template_kwargs": {"verification": true}
}
최종 모델에서는 병렬화로 검색·리포트 점수가 올랐고, 검증의 정확도 상승과 생성 비용 감소는 교사 모델에서 확인됐다.