Reflection 于 10 月 5 日发布了首个开放权重模型 Beam。这是一个总参数 501B、激活参数 23B 的稀疏混合专家(MoE)模型,面向编码、推理和智能体任务。
文档说明开发者平台处于测试阶段,正通过候补名单逐步开放访问,行为和限制都可能变化。
公告表示将在本月以 Apache 2.0 许可证公开权重、技术报告和模型卡。在此之前无法自行托管。
100 万 token 与 262,144 token 各指什么
公告称,中期训练(midtraining)把 Beam 的有效上下文长度扩展到 100 万 token。
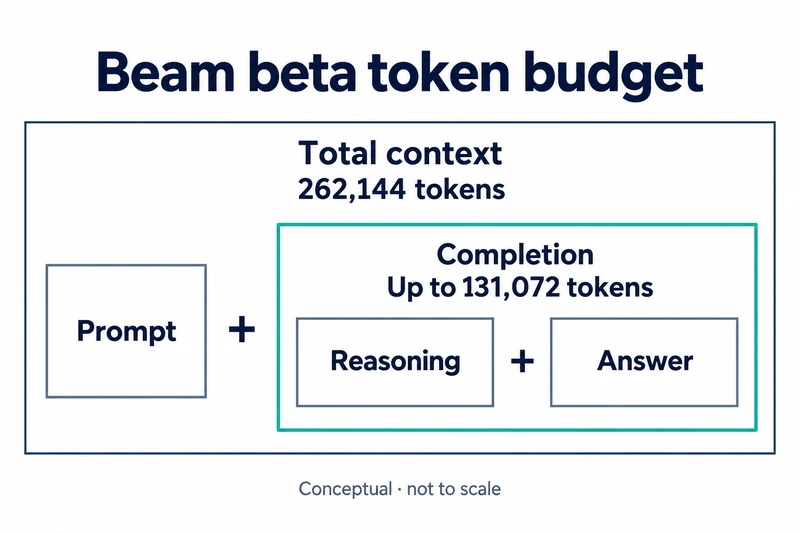
而 Models 文档列出的 Beam-501B-A23B 的 context_length 为 262,144 token,max_output_tokens 为 131,072。脚注说明上下文窗口在测试期间可能变化。
context_length 是提示与生成输出的合计。超出的请求会被拒绝,而不是被截断。
包含推理在内的输出预算
max_completion_tokens 是同时涵盖可见输出和推理 token 的生成上限。提示加上这个值应当落在 context_length 之内。
如果请求没有设定上限,就会使用组织的默认值(default_parameters.max_tokens),而这个值不会根据提示长度缩减。因此 API 参考建议长提示自行发送上限。
兼容范围与只接受不生效的参数
OpenAI 兼容端点只实现 Chat Completions 和 Models。不支持 Responses、Embeddings、Files、Batch 等其他端点,消息输入也只接受文本。
stop 接受 1 到 4 个非空字符串,但不会在这些位置停止生成。文档建议,如需在某个序列处结束输出,就在自己的代码中截断文本。
seed 同样不起作用,重复请求可能返回不同结果。n、logprobs 等参数只接受固定值,其他值会返回 400 错误(unsupported_value)。
始终开启的推理与空回答
Beam 始终进行推理,可用 reasoning_effort 在 low、medium、high、xhigh、max 中选择。没有 none 这类关闭推理的值。
请求省略推理强度时,会应用各组织可能不同的默认值。实际默认值可从 Models 端点的 reasoning.default_effort 查看。
如果 max_completion_tokens 太小,模型可能在推理中耗尽 token,返回 finish_reason 为 length、content 可能为 null 的响应。
在多轮请求中,每条 assistant 消息都必须原样附上收到的 reasoning_content。缺少时会返回 400 错误(missing_required_parameter)。
注意事项:计算量估算不等于部署成本
Reflection 称,在高级推理基准上 Beam 的推理计算量比 GLM-5.2 少 3~4 倍。公告自己说明,这一估算没有计入提示预填充、随上下文变化的注意力计算和服务开销。
因此不能用这个数字预测实际部署成本。本文的 API 内容来自阅读文档,而不是实际调用 Beam 的结果。
首次集成测试应包含的请求
首次测试时,可以把长对话记录、依赖分隔字符串的回答、紧张的生成预算以及带工具调用的多轮请求放进一个有代表性的小任务里。
与其看请求是否成功,不如看应用收到了什么、如何恢复,这样能在更大范围测试前发现需要修正的假设。
迁移到 Beam 测试版 API 时,真正起决定作用的不是模型性能,而是 262,144 token 上限、被忽略的 stop 和必需的 reasoning_content 这些服务约定。