Reflectionは10月5日、初のオープンウェイトモデルBeamを発表した。総パラメーター501B、アクティブ23Bの疎な混合エキスパート(MoE)モデルで、コーディング、推論、エージェント作業を狙っている。
文書によると、開発者プラットフォームはベータ段階で、ウェイトリストを通じて段階的にアクセスを開いており、動作や上限は変わりうる。
発表は、今月中にApache 2.0ライセンスで重み、技術レポート、モデルカードを公開するとしている。それまではセルフホストできない。
100万トークンと262,144トークンが指す範囲
発表は、中間学習(midtraining)でBeamの実効コンテキスト長を100万トークンまで伸ばしたと説明している。
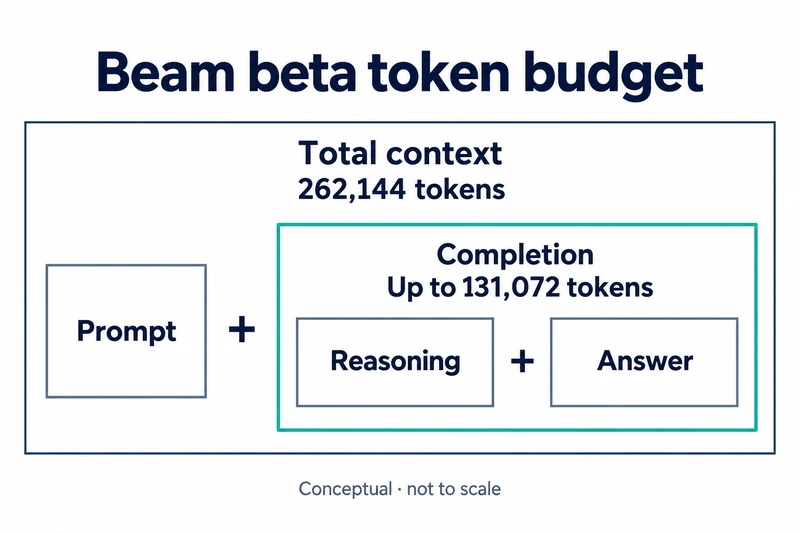
一方、Models文書はBeam-501B-A23Bのcontext_lengthを262,144トークン、max_output_tokensを131,072トークンと記す。コンテキストウィンドウはベータ中に変わりうるという注記も付いている。
context_lengthはプロンプトと生成出力の合計だ。これより長いリクエストは切り詰められず、拒否される。
推論まで含む出力予算
max_completion_tokensは、見える出力と推論トークンの両方を含む生成の上限だ。プロンプトとこの値の合計がcontext_lengthに収まる必要がある。
リクエストが上限を指定しないと組織ごとの既定値(default_parameters.max_tokens)が使われ、この値はプロンプトの長さに合わせて減らされない。そのためAPIリファレンスは、長いプロンプトでは上限を自分で送るよう案内している。
互換の範囲と受け付けるだけのパラメーター
OpenAI互換エンドポイントはChat CompletionsとModelsだけを実装する。Responses、Embeddings、Files、Batchなど他のエンドポイントには対応せず、メッセージの入力はテキストのみだ。
stopは空でない文字列を1〜4個受け付けるが、そこで生成を止めない。文書は、特定の文字列で出力を終えたいならコード側でテキストを切り取るよう案内している。
seedも効果がなく、同じリクエストが別の結果を返しうる。nやlogprobsなどのパラメーターは決まった値だけを受け付け、それ以外は400エラー(unsupported_value)になる。
常に有効な推論と空の回答
Beamは常に推論し、reasoning_effortでlow、medium、high、xhigh、maxのいずれかを選ぶ。推論を切るnoneのような値はない。
リクエストが推論の強さを省くと、組織ごとに異なりうる既定値が適用される。実際の既定値はModelsエンドポイントのreasoning.default_effortで確かめる。
max_completion_tokensが小さすぎると、推論の途中でトークンが尽き、finish_reasonがlengthでcontentがnullの応答が返ることがある。
マルチターンのリクエストでは、すべてのassistantメッセージに受け取ったreasoning_contentをそのまま入れて送る必要がある。欠けていると400エラー(missing_required_parameter)になる。
注意点:計算量の見積もりは配備コストではない
Reflectionは、高度な推論ベンチマークでBeamの推論計算量がGLM-5.2より3〜4倍少ないと主張している。発表自身が、この見積もりはプロンプトのプリフィル、コンテキストに応じたアテンション計算、サービングのオーバーヘッドを除いて計算したと明記している。
そのため、この数値から実際の配備コストを予測することはできない。この記事のAPIの内容は文書を読んだ結果で、Beamを実際に呼び出した結果ではない。
最初の連携テストに入れるリクエスト
最初のテストでは、長い会話履歴、区切り文字列に頼る応答、厳しい生成予算、ツール呼び出しを含むマルチターンのリクエストを、小さな代表的作業に入れてみることができる。
リクエストが成功したかよりも、アプリケーションが何を受け取りどう回復したかを見れば、広く試す前に直すべき前提が見えてくる。
BeamのベータAPIへ移るときに実際に分かれ目になるのは、モデル性能よりも、262,144トークンの上限、無視されるstop、必須のreasoning_contentといったサービスの約束事だ。