Reflection이 10월 5일 첫 오픈 웨이트 모델 Beam을 발표했다. 전체 501B, 활성 23B 파라미터의 희소 전문가 혼합(MoE) 모델로, 코딩·추론·에이전트 작업을 겨냥했다.
개발자 플랫폼은 베타 단계로, 대기 명단을 통해 접근을 점차 열고 있으며 동작과 한도가 바뀔 수 있다고 문서는 밝힌다.
발표문은 이달 안에 Apache 2.0 라이선스로 가중치와 기술 보고서, 모델 카드를 공개하겠다고 했다. 그 전까지 자가 호스팅은 할 수 없다.
100만 토큰과 262,144토큰이 가리키는 범위
발표문은 중간 학습(midtraining)으로 유효 컨텍스트 길이를 100만 토큰까지 늘렸다고 설명한다.
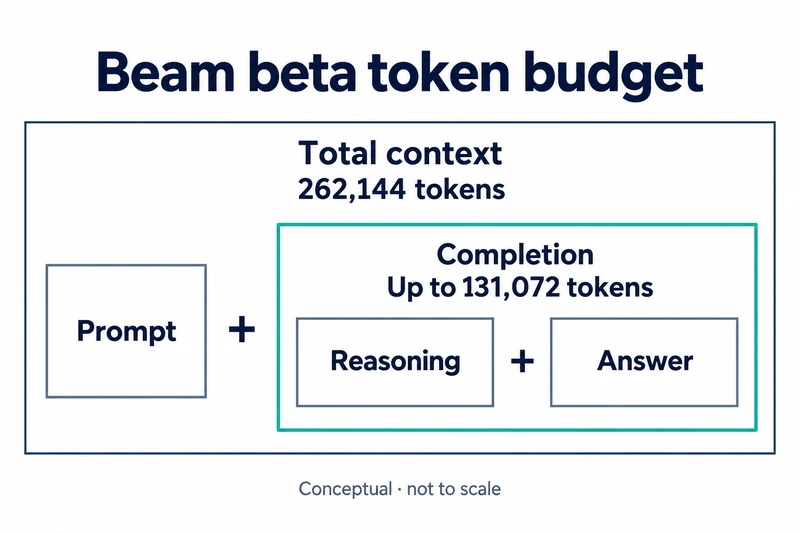
반면 Models 문서는 Beam-501B-A23B의 context_length를 262,144토큰, max_output_tokens를 131,072토큰으로 적는다. 컨텍스트 창은 베타 중 바뀔 수 있다는 각주도 붙어 있다.
context_length는 프롬프트와 생성 출력을 합한 값이다. 이보다 긴 요청은 잘리지 않고 거부된다.
추론까지 포함하는 출력 예산
max_completion_tokens는 사용자에게 보이는 출력과 추론 토큰을 모두 포함한 생성 상한이다. 프롬프트와 이 값의 합이 context_length 안에 들어가야 한다.
요청이 상한을 정하지 않으면 조직별 기본값(default_parameters.max_tokens)이 쓰이는데, 이 값은 프롬프트 길이에 맞춰 줄어들지 않는다. 그래서 API 레퍼런스는 긴 프롬프트에서는 상한을 직접 보내라고 안내한다.
호환 범위와 받아들이기만 하는 매개변수
OpenAI 호환 엔드포인트는 Chat Completions와 Models만 구현한다. Responses, Embeddings, Files, Batch 같은 다른 엔드포인트는 지원하지 않고, 메시지 입력은 텍스트만 받는다.
stop은 비어 있지 않은 문자열 1~4개를 받아들이지만 그 지점에서 생성을 멈추지 않는다. 문서는 특정 문자열에서 출력을 끊으려면 코드에서 직접 잘라 내라고 안내한다.
seed도 효과가 없어 같은 요청이 다른 결과를 낼 수 있다. n, logprobs 같은 매개변수는 정해진 값만 받고, 그 밖의 값은 400 오류(unsupported_value)를 낸다.
항상 켜지는 추론과 빈 답변
Beam은 항상 추론하며, reasoning_effort로 low, medium, high, xhigh, max 중 하나를 고른다. 추론을 끄는 none 같은 값은 없다.
요청이 추론 강도를 생략하면 조직마다 다를 수 있는 기본값이 적용된다. 실제 기본값은 Models 엔드포인트의 reasoning.default_effort로 확인한다.
max_completion_tokens가 너무 작으면 추론 중에 토큰이 바닥나, finish_reason이 length이고 content가 null인 응답이 올 수 있다.
멀티턴 요청에서는 모든 assistant 메시지에 받은 reasoning_content를 그대로 넣어 보내야 한다. 빠지면 400 오류(missing_required_parameter)가 난다.
주의할 점: 연산량 추정은 배포 비용이 아니다
Reflection은 Beam이 비슷한 추론 벤치마크에서 GLM-5.2보다 3~4배 적은 추론 연산을 쓴다고 주장한다. 이 추정은 프롬프트 프리필, 컨텍스트에 따른 어텐션 연산, 서빙 오버헤드를 빼고 계산했다고 발표문이 직접 밝힌다.
그래서 이 수치로 실제 배포 비용을 예측할 수는 없다. 이 기사의 API 내용은 문서를 읽은 결과이며 Beam을 직접 호출해 본 결과가 아니다.
첫 연동 시험에 넣을 요청
처음 시험할 때는 긴 대화 기록, 구분 문자열에 기대는 응답, 빠듯한 생성 예산, 도구 호출이 섞인 멀티턴 요청을 작은 대표 작업에 넣어 볼 수 있다.
요청이 성공했는지보다 애플리케이션이 무엇을 받았고 어떻게 복구했는지를 보면, 넓게 시험하기 전에 고칠 가정이 드러난다.
Beam 베타 API로 옮길 때 실제로 갈리는 지점은 모델 성능보다 262,144토큰 한도, 무시되는 stop, 필수 reasoning_content 같은 서비스 계약이다.