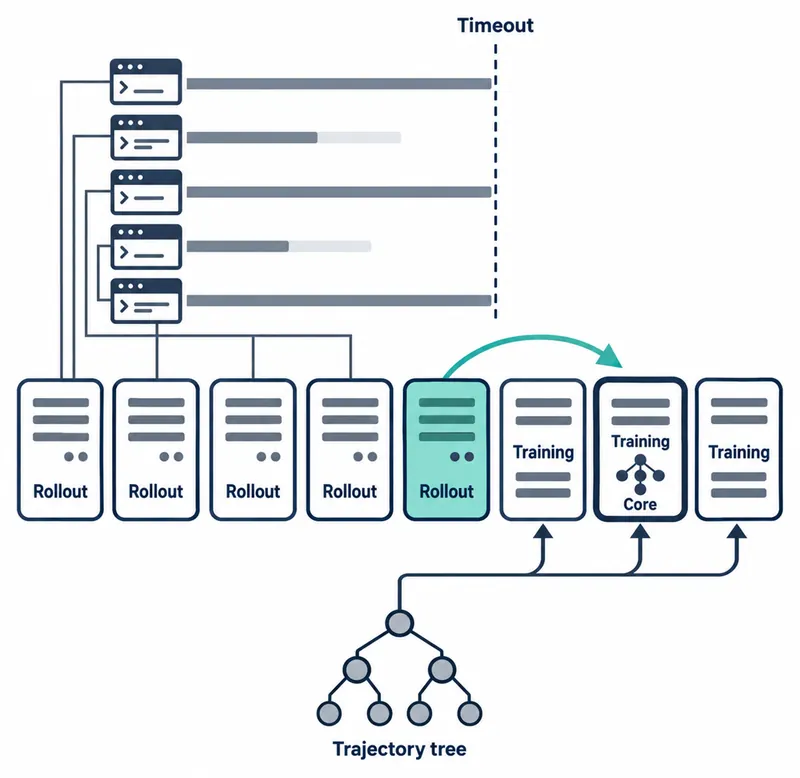
Alibaba Token Hub 等机构的研究人员于 2026 年 9 月 27 日(UTC)向 arXiv 提交了 QwenGyre。这是一个面向持续数小时的智能体执行的在线强化学习(RL)框架。
目标任务可能持续数小时,包含数百次模型与环境交互,每条运行轨迹接近 100 万 Token。报告中的工作负载都在容器内使用 Claude Code 2.1.220 执行 Shell 和文件操作。
harness 通过 RL 框架提供的代理调用模型,框架在不修改 harness 逻辑的情况下记录调用。作者给出的理由是,Claude Code 或 Codex 等 harness 是封闭的,且变化迅速。在 RL 中重新实现它们,会导致训练时使用的 harness 与部署时不同。
固定分区与整体切换造成的 GPU 等待
Colocate 将整组 GPU 在智能体运行与训练之间切换,少数慢任务会让其余资源等待。Async 则固定划分两组 GPU,但训练资源可能在等待下一批数据时闲置。
另一项开销来自分支式执行记录。重试和子任务会共享长前缀,将每条路径拆开训练就会重复计算这些 Token。
数据侧也存在瓶颈。上下文压缩、子智能体委派和重试,使一次执行成为分支图,而非线性轨迹。将所有路径展开为训练样本,会因共享 prefix 重复而使训练成本激增。
在推理与训练之间切换 GPU 单元
QwenGyre 使用 Megatron 进行训练,使用 SGLang 进行 rollout,并将 GPU 划分为单元。每个单元提供 rollout 服务,或承载一个训练 actor 副本。核心单元持有权威权重和唯一的优化器状态。
满足两个条件时,单元逐个转入训练。剩余 rollout 容量必须能够处理未完成的执行。就绪训练组必须在一定时间内持续达到批次的规定比例以上。卫星单元通过 Mooncake Transfer Engine 和 RDMA 拉取核心权重,加入正在进行的批次。
角色切换期间,代理将请求转发至其他引擎,并通过 RDMA 迁移 KV 缓存块,以减少 prefix 重算。122B 模型 NL2RepoBench 实验中的平均切换时间为 rollout→训练 8.52 秒、训练→rollout 3.46 秒。相对于持续数小时的执行,这些时间可以忽略。
这也有代价。流式训练按顺序将就绪组分配给更新,因此每个 burst 执行多个步骤(μ>1)时,无法在 burst 开始前对整个小批次进行全局打乱。作者写明,未单独测量样本顺序对训练质量的影响。
轨迹处理器以 token-in/token-out(TITO) 记录模型调用,构建共享 prefix 树。它通过掩码使多条路径共享的输出 token 仅计入损失一次。对于超时执行,也会对可评估的部分工作评分。评估失败与有效的 0 分区分,并从训练中排除。不过,论文没有单独隔离部分评分的 ablation。
每次执行的轨迹上限 J_max 默认值为 5。在 122B 模型 NL2RepoBench 第 1–42 步的 ablation 中,上限 5 获得了与无限制设置相近的训练分数,同时将每步平均 forward–backward 时间减少了 25.2%。这是训练计算阶段的效果,而非端到端时间的效果。
2.4T 测试为何只有 1.21 倍优势
比较使用相同的 GPU 预算,以及相同的平均策略版本滞后(staleness)目标 E[d]=1 或 1.5。2.4T 实验在 4 个各含 48 节点的单元上(共 192 节点),对 NL2RepoBench 进行了 48 步训练。GPU 型号未公开。
该实验中,QwenGyre 耗时 75.42 小时,Async 耗时 134.55 小时,Colocate 耗时 91.47 小时。论文标注的提升为 1.78 倍和 1.21 倍。换算成时间,QwenGyre 比 Async 提前 59.13 小时(43.9%)完成,比更快的基线 Colocate 提前 16.05 小时(17.5%)完成。
论文报告值。在 4 个各含 48 节点的单元(共 192 节点)上以 NL2RepoBench 训练 48 步所用的时间,倍数为论文标注。
| 调度器 | 端到端时间(小时) | QwenGyre 加速倍数 |
|---|---|---|
| QwenGyre | 75.42 | — |
| Async | 134.55 | 1.78 倍 |
| Colocate | 91.47 | 1.21 倍 |
摘要中的“最高 1.85 倍”来自其他条件。在 122B 模型的 TerminalBench 24 步、E[d]=1.5 比较中,相较 Colocate 的提升为 1.849 倍。同一条件下,相较 Async 的提升为 1.430 倍。也就是说,相对哪个基线收益更大,会随工作负载发生逆转。
2.4T 中相较 Colocate 的差距缩小,与执行分布有关。在持续时间记录完整的查询中,61.1% 持续 4 小时以上(122B 为 9.51%)。论文写明,这些查询中有 38.2% 的最长执行因整体超时而结束。查询持续时间是每个查询中最长 rollout 执行的时间。
作者的解释是,结束时间集中在超时上限附近,会减少提前回收单元并逐步扩大训练的空间。相较 Async 的较大收益,可由将固定分区中为训练锁定的 GPU 转用于 rollout 来解释。结果未给出重复运行的方差,因此无法得知该差异的波动范围。
同一 2.4T 实验的评估通过率从 52.48% 升至 58.54%(摘要标注为 6.0 个百分点)。但论文自身写明,三个调度器的训练分数曲线相近。因此,这一提升更适合解读为 48 步策略训练的结果,而非调度器占优。
也没有合适的外部参照。在包含 104 个任务的 NL2Repo-Bench 原论文中,最高分为 Claude-Sonnet-4.5(Claude Code) 的 40.2%。但测量时间、模型和 harness 不同,无法将其与 58.54% 放在同一排行榜上,也未找到单独的实时排行榜。
借助 verl 有限地检查 GPU 空闲
122B 模型的 12 步消融中,仅为 Async 加入流式处理就缩短了 11.6% 的时间。细粒度单元分配又比流式 Colocate 变体快 1.19 倍,因此不能把全部收益归因于 GPU 重新分配。
QwenGyre 的代码不可用,但同一个问题可以通过开源软件进行部分测量。这个问题是:将训练 GPU 等待下一批次时的空闲时间借给 rollout,能缩短多少时间。verl V1 Async Trainer 的 separate_async 在独立的 rollout GPU 上持续生成。实验性功能 step switching 则在等待下一步样本时,让训练副本加入 rollout 负载均衡器。
trainer.use_v1=True \
trainer.v1.trainer_mode=separate_async \
trainer.v1.separate_async.hybrid_rollout.enable_switch=True
观察指标包括各查询最长执行时间的分布、超时上限附近的集中程度,以及训练 GPU 空闲时间。如果分布集中在超时附近,资源重新分配的贡献可能较小,类似于 2.4T 案例。
不过,verl 在步骤之间借出 GPU,而 QwenGyre 让单元逐步加入正在进行的批次。无法用 verl 的结果验证 QwenGyre 的加速效果。
异步 RL 和 partial rollout 本身已经很常见。slime v0.4.0 不等待所有 worker,而是用已完成的组汇集训练批次。AReaL 在分离的 GPU 上重叠执行 rollout 和训练。在这一比较范围内,QwenGyre 的区别似乎在于结合了单元级逐步加入、不中断 harness 的请求迁移,以及分支轨迹处理。
没有实现代码时的证据边界
每个单元都必须容纳模型内存和训练并行配置,因此在很小的 GPU 预算下,这种配置难以实现。作者也表示,未评估总 GPU 预算小得多时的效率。将 192 节点的数字应用于数十 GPU 规模的集群,似乎较为困难。
所核查的 arXiv v1 没有实现仓库链接,MarkTechPost 也指出了这一点。这只是确认缺少链接,并非独立验证。
接下来要观察的是代码是否公开,以及在分布较少集中于超时附近或预算较小时,相较 Colocate 的差距如何变化。
2.4T 测试中比 Colocate 快 16.05 小时,很大程度取决于长任务何时结束;在缺少代码和小规模测试的情况下,这不是可直接迁移的提速保证。