Alibaba Token Hub 등의 연구진이 2026년 9월 27일(UTC) arXiv에 QwenGyre를 올렸다. 수 시간짜리 에이전트 실행을 대상으로 한 온라인 강화학습(RL) 프레임워크다.
대상은 한 번에 수 시간 걸리고, 모델과 환경의 상호작용이 수백 번 이어지며, 실행당 토큰이 100만 개에 가까워질 수 있는 에이전트 작업이다. 보고된 실험은 모두 컨테이너 안에서 Claude Code 2.1.220으로 셸 명령과 파일 작업을 수행했다.
하네스는 RL 프레임워크가 제공하는 프록시로 모델을 호출하고, 프레임워크는 하네스 로직을 건드리지 않고 호출을 기록한다. Claude Code나 Codex 같은 하네스는 닫혀 있고 빠르게 바뀌어 RL 안에서 재구현하면 배포와 다른 하네스로 학습하게 된다는 것이 저자들의 이유다.
고정 분할과 전체 전환에서 생기는 GPU 대기
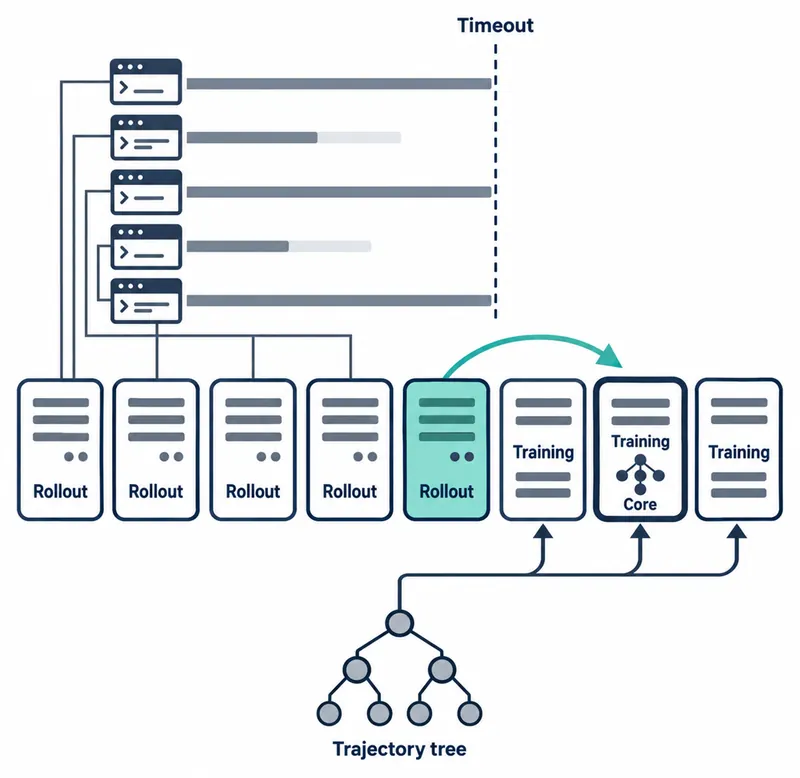
Colocate는 GPU 전체를 에이전트 실행과 학습에 번갈아 쓴다. 일부 작업이 오래 걸리면 나머지 GPU가 기다린다. Async는 두 용도에 GPU를 고정 배분하는데, 다음 배치가 준비될 때까지 학습 GPU가 쉬는 문제가 있다.
실행 기록도 단순한 한 줄이 아니다. 재시도와 하위 작업으로 기록이 갈라져, 모든 경로를 따로 학습하면 공통으로 지나온 토큰까지 반복 처리하게 된다.
데이터 쪽 병목도 있다. 컨텍스트 압축, 서브에이전트 위임, 재시도 때문에 한 실행이 선형 궤적이 아니라 분기 그래프가 되고, 모든 경로를 학습 샘플로 펼치면 공유 prefix 중복으로 학습 비용이 폭증한다.
GPU 셀을 학습과 실행 사이에서 옮기는 방식
QwenGyre는 학습에 Megatron, 롤아웃에 SGLang을 쓰고 GPU를 셀로 나눈다. 각 셀은 롤아웃을 서비스하거나 학습 액터 복제본 하나를 맡고, 권위 있는 가중치와 유일한 옵티마이저 상태는 코어 셀이 가진다.
셀은 두 조건이 맞을 때 하나씩 학습으로 넘어간다. 남은 롤아웃 용량이 미완료 실행을 감당해야 하고, 준비된 학습 그룹이 배치의 일정 비율 이상으로 일정 시간 유지돼야 한다. 위성 셀은 Mooncake Transfer Engine과 RDMA로 코어 가중치를 당겨 진행 중인 배치에 합류한다.
역할 전환 중에는 프록시가 요청을 다른 엔진으로 돌리고, KV 캐시 블록을 RDMA로 옮겨 prefix 재계산을 줄인다. 122B·NL2RepoBench 실험의 평균 전환 시간은 롤아웃→학습 8.52초, 학습→롤아웃 3.46초로 수 시간짜리 실행에 비하면 무시할 만한 수준이다.
대가도 있다. 스트리밍 학습은 준비된 그룹을 순서대로 업데이트에 배정하므로, 버스트당 여러 스텝(μ>1)을 돌리면 버스트 시작 전에 전체 미니배치를 전역 셔플할 수 없다. 저자들은 샘플 순서가 학습 품질에 주는 영향을 따로 측정하지 않았다고 적었다.
궤적 처리기는 모델 호출을 token-in/token-out(TITO)으로 기록해 공유 prefix 트리를 만들고, 여러 경로가 공유하는 출력 토큰은 손실에 한 번만 들어가게 마스킹한다. 타임아웃된 실행도 평가 가능한 부분 작업은 채점하고, 평가 실패는 유효한 0점과 구분해 학습에서 뺀다. 다만 부분 채점만 떼어 낸 ablation은 논문에 없다.
실행당 궤적 상한 J_max의 기본값은 5다. 122B·NL2RepoBench 1–42스텝 ablation에서 상한 5는 무제한과 비슷한 학습 점수를 내면서 스텝당 평균 forward–backward 시간을 25.2% 줄였다. 종단 시간이 아니라 학습 연산 구간의 효과다.
2.4T에서 이득이 1.21배로 줄어든 이유
비교는 같은 GPU 예산, 같은 평균 정책 버전 지연(staleness) 목표 E[d]=1 또는 1.5에서 이뤄졌다. 2.4T 실험은 48노드 셀 4개(총 192노드)에서 NL2RepoBench를 48스텝 학습했고, GPU 모델은 공개되지 않았다.
이 실험에서 QwenGyre는 75.42시간, Async는 134.55시간, Colocate는 91.47시간이 걸렸다. 논문 표기로는 1.78배와 1.21배이고, 시간으로 환산하면 Async보다 59.13시간(43.9%), 더 빠른 베이스라인인 Colocate보다 16.05시간(17.5%) 일찍 끝난 셈이다.
논문 보고값이다. 48노드 셀 4개(총 192노드)에서 NL2RepoBench로 48스텝을 학습하는 데 걸린 시간이며, 배율은 논문 표기다.
| 스케줄러 | 종단 시간(시간) | QwenGyre의 단축 배율 |
|---|---|---|
| QwenGyre | 75.42 | — |
| Async | 134.55 | 1.78배 |
| Colocate | 91.47 | 1.21배 |
초록의 "최대 1.85배"는 다른 조건에서 나왔다. 122B 모델의 TerminalBench 24스텝, E[d]=1.5 비교에서 Colocate 대비 1.849배였고 같은 조건의 Async 대비는 1.430배였다. 즉 어느 베이스라인 대비 이득이 큰지는 워크로드마다 뒤집힌다.
2.4T에서 Colocate 대비 격차가 좁아진 이유는 실행 분포에 있다. 지속시간 기록이 온전한 쿼리 중 61.1%가 4시간 이상이었고(122B는 9.51%), 논문은 이 쿼리들 중 38.2%에서 가장 긴 실행이 전체 타임아웃으로 끝났다고 적었다. 쿼리 지속시간은 쿼리별 가장 긴 롤아웃 실행 시간이다.
종료가 타임아웃 한도 부근에 몰리면 셀을 일찍 회수해 학습을 조금씩 키울 여지가 줄어든다는 것이 저자들의 해석이다. Async 대비 큰 이득은 고정 분할에서 학습용으로 묶인 GPU를 롤아웃에 돌린 효과로 설명된다. 결과는 반복 실행 분산 없이 제시돼 이 차이의 변동 폭은 알 수 없다.
같은 2.4T 실험의 평가 통과율은 52.48%에서 58.54%로 올랐다(초록 표기 6.0%p). 하지만 세 스케줄러의 학습 점수 곡선은 비슷했다고 논문 스스로 적었으므로, 이 상승은 스케줄러 우위가 아니라 48스텝 정책 학습의 결과로 읽는 편이 맞다.
외부 기준점도 마땅치 않다. 104개 작업의 NL2Repo-Bench 원 논문에서 최고치는 Claude-Sonnet-4.5(Claude Code) 40.2%였지만, 측정 시점·모델·하네스가 달라 58.54%와 같은 리더보드에 놓을 수 없고 별도의 실시간 리더보드도 찾지 못했다.
verl로 비교할 수 있는 GPU 대기 시간
122B 모델의 12스텝 분석에서 Async에 스트리밍만 추가해도 시간이 11.6% 줄었다. 셀 단위 할당은 스트리밍 Colocate 변형보다 1.19배 빨랐다. 전체 개선을 GPU 재배치 하나의 효과로 볼 수 없는 이유다.
QwenGyre 코드는 쓸 수 없지만 같은 질문, 즉 "학습 GPU가 다음 배치를 기다리며 노는 시간을 롤아웃에 빌려주면 얼마나 줄어드는가"는 오픈소스로 일부 재 볼 수 있다. verl V1 Async Trainer의 separate_async는 독립 롤아웃 GPU에서 생성을 계속하고, 실험적 기능인 step switching은 다음 스텝 샘플을 기다리는 동안 학습 복제본을 롤아웃 로드밸런서에 합류시킨다.
trainer.use_v1=True \
trainer.v1.trainer_mode=separate_async \
trainer.v1.separate_async.hybrid_rollout.enable_switch=True
볼 지표는 쿼리별 가장 긴 실행 시간의 분포, 타임아웃 한도 부근의 몰림, 학습 GPU 유휴 시간이다. 분포가 타임아웃 쪽에 몰려 있다면 2.4T 사례처럼 자원 재배치의 몫이 작게 나올 가능성이 커 보인다.
다만 verl은 스텝 사이에 GPU를 빌려주는 방식이고, QwenGyre는 셀이 진행 중인 배치에 점진적으로 합류하는 방식이다. verl 결과로 QwenGyre의 속도 향상을 검증할 수는 없다.
비동기 RL과 partial rollout 자체는 이미 흔하다. slime v0.4.0은 모든 워커를 기다리지 않고 완료된 그룹으로 학습 배치를 모으며, AReaL은 분리된 GPU에서 롤아웃과 학습을 겹친다. 이 비교 범위에서 QwenGyre의 차별점은 셀 단위 점진 합류, 하네스를 끊지 않는 요청 이전, 분기 궤적 처리의 결합으로 보인다.
구현 코드 없이 남는 검증 범위
셀마다 모델 메모리와 학습 병렬화를 담아야 해서 아주 작은 GPU 예산에서는 이 구성이 어렵고, 저자들도 훨씬 작은 총 GPU 예산의 효율은 평가하지 않았다고 밝혔다. 192노드 수치를 수십 GPU 규모 클러스터에 옮기기는 어려워 보인다.
확인한 arXiv v1에는 구현 저장소 링크가 없고, MarkTechPost도 같은 점을 지적했다. 이는 링크 부재의 확인일 뿐 독립 검증은 아니다.
다음으로 볼 것은 코드 공개 여부, 그리고 타임아웃에 덜 몰린 분포나 작은 예산에서 Colocate 대비 격차가 어떻게 바뀌는지다.
2.4T 실험의 Colocate 대비 16.05시간 차이는 긴 에이전트 실행의 종료 분포에 크게 좌우됐으며, 코드와 소규모 결과가 없어 다른 환경의 속도 향상으로 단정하기는 이르다.