Alibaba Token Hub などの研究者が、2026 年 9 月 27 日(UTC)に QwenGyre を arXiv に投稿した。数時間に及ぶエージェント実行を対象とするオンライン強化学習(RL)フレームワークである。
対象は数時間続き、モデルと環境の対話が数百回に及び、1回の実行で約100万トークンに達することもあるエージェント作業だ。報告されたワークロードはすべてコンテナ内のClaude Code 2.1.220でシェルやファイルを操作した。
ハーネスは RL フレームワークが提供するプロキシを通じてモデルを呼び出し、フレームワークはハーネスのロジックを変更せずに呼び出しを記録する。著者らの理由は、Claude Code や Codex のようなハーネスが閉じており、急速に変化することにある。RL 内で再実装すると、デプロイ時とは異なるハーネスで学習することになる。
固定分割と一括切り替えで生じるGPUの待ち時間
ColocateはGPU全体をエージェント実行と学習に交互に使い、遅い作業が残るとほかのGPUも待つ。Asyncは両方にGPUを固定配分するため、次のデータを待つ間に学習側が遊休する場合がある。
実行履歴が分岐する点も負担になる。再試行や子作業は長い共通部分を持ち、各経路を別々の学習例にすると同じトークンを繰り返し処理する。
データ側にもボトルネックがある。コンテキスト圧縮、サブエージェントへの委譲、再試行によって、1 回の実行が線形軌跡ではなく分岐グラフになる。全経路を学習サンプルに展開すると、共有 prefix の重複で学習コストが急増する。
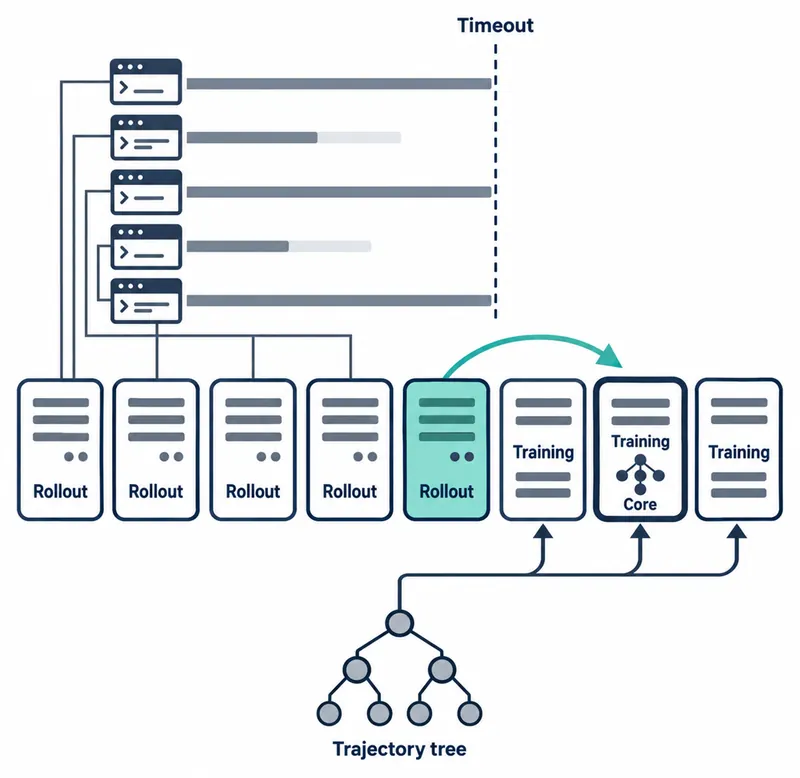
生成と学習を行き来するGPUセル
QwenGyre は学習に Megatron、ロールアウトに SGLang を使い、GPU をセルに分割する。各セルはロールアウトを提供するか、学習アクターのレプリカを 1 つ担う。コアセルが正本の重みと唯一のオプティマイザ状態を保持する。
セルは 2 つの条件を満たすと、1 つずつ学習に移る。残るロールアウト容量が未完了の実行を処理できる必要がある。準備済みの学習グループが、バッチの一定割合以上の状態を一定時間維持する必要もある。衛星セルは Mooncake Transfer Engine と RDMA でコアの重みを取得し、進行中のバッチに加わる。
役割切り替え中は、プロキシがリクエストを別のエンジンに転送し、KV キャッシュブロックを RDMA で移動して prefix の再計算を減らす。122B モデルの NL2RepoBench 実験の平均切り替え時間は、ロールアウト→学習が 8.52 秒、学習→ロールアウトが 3.46 秒である。数時間の実行と比べれば無視できる水準である。
代償もある。ストリーミング学習は準備済みグループを順番に更新へ割り当てるため、バーストあたり複数ステップ(μ>1)を実行すると、開始前にミニバッチ全体をグローバルにシャッフルできない。著者らは、サンプル順序が学習品質に与える影響を個別に測定していないと記した。
軌跡処理器はモデル呼び出しを token-in/token-out(TITO) で記録し、共有 prefix ツリーを作る。複数経路が共有する出力トークンは、損失に 1 回だけ入るようマスクする。タイムアウトした実行も、評価可能な部分作業は採点する。評価失敗は有効な 0 点と区別し、学習から除外する。ただし、部分採点だけを切り出した ablation は論文にない。
実行あたりの軌跡上限 J_max のデフォルト値は 5 である。122B モデルの NL2RepoBench の 1–42 ステップの ablation では、上限 5 は無制限と似た学習スコアを出しつつ、ステップあたりの平均 forward–backward 時間を 25.2% 減らした。エンドツーエンド時間ではなく、学習計算区間の効果である。
2.4T実験で優位が1.21倍に縮んだ理由
比較は同じ GPU 予算、同じ平均ポリシーバージョン遅延(staleness)の目標 E[d]=1 または 1.5 で行われた。2.4T 実験は、48 ノードのセル 4 つ(計 192 ノード)で NL2RepoBench を 48 ステップ学習した。GPU モデルは公開されていない。
この実験では、QwenGyre が 75.42 時間、Async が 134.55 時間、Colocate が 91.47 時間を要した。論文の表記では 1.78 倍と 1.21 倍である。時間に換算すると、Async より 59.13 時間(43.9%)、より速いベースラインの Colocate より 16.05 時間(17.5%)早く完了したことになる。
論文の報告値である。48 ノードのセル 4 つ(計 192 ノード)で NL2RepoBench を 48 ステップ学習するのにかかった時間で、倍率は論文の表記だ。
| スケジューラ | エンドツーエンド時間(時間) | QwenGyre の短縮倍率 |
|---|---|---|
| QwenGyre | 75.42 | — |
| Async | 134.55 | 1.78 倍 |
| Colocate | 91.47 | 1.21 倍 |
要旨の「最大 1.85 倍」は別の条件で得られた。122B モデルの TerminalBench 24 ステップ、E[d]=1.5 の比較では、Colocate 比で 1.849 倍だった。同じ条件での Async 比は 1.430 倍だった。つまり、どのベースラインに対する利得が大きいかは、ワークロードによって逆転する。
2.4T で Colocate との差が小さくなった理由は、実行分布にある。継続時間の記録が完全なクエリのうち、61.1% が 4 時間以上だった(122B は 9.51%)。論文は、これらのクエリの 38.2% で最長の実行が全体のタイムアウトによって終了したと記した。クエリ継続時間は、クエリごとの最長ロールアウト実行時間である。
終了がタイムアウト上限付近に集中すると、セルを早期に回収して学習を徐々に拡大する余地が減る、というのが著者らの解釈である。Async に対する大きな利得は、固定分割で学習用に確保された GPU をロールアウトに回す効果で説明される。結果には反復実行の分散が示されておらず、この差の変動幅は不明である。
同じ 2.4T 実験の評価通過率は、52.48% から 58.54% に上昇した(要旨の表記は 6.0 ポイント)。ただし、3 つのスケジューラの学習スコア曲線は似ていたと論文自体が記している。そのため、この上昇はスケジューラの優位性ではなく、48 ステップのポリシー学習の結果と読むのが妥当である。
適切な外部の基準もない。104 タスクを扱う NL2Repo-Bench の原論文では、最高値は Claude-Sonnet-4.5(Claude Code) の 40.2% だった。しかし、測定時点、モデル、ハーネスが異なるため、58.54% と同じリーダーボードには置けない。別のリアルタイムリーダーボードも見つからなかった。
verlで一部を確かめられるGPUの遊休時間
122Bモデルの12ステップ分析では、Asyncにストリーミングを追加するだけで所要時間が11.6%減った。セル単位の割り当てはストリーミング対応Colocateの変種より1.19倍速かった。改善のすべてをGPU再配分の効果とは言えない。
QwenGyre のコードは使えないが、同じ問いはオープンソースで部分的に測定できる。問いは、学習 GPU が次のバッチを待って遊休状態になる時間をロールアウトに貸すと、どれだけ短縮できるかである。verl V1 Async Trainer の separate_async は、独立したロールアウト GPU で生成を続ける。実験的機能の step switching は、次のステップのサンプルを待つ間、学習レプリカをロールアウトのロードバランサに参加させる。
trainer.use_v1=True \
trainer.v1.trainer_mode=separate_async \
trainer.v1.separate_async.hybrid_rollout.enable_switch=True
見る指標は、クエリごとの最長実行時間の分布、タイムアウト上限付近への集中、学習 GPU の遊休時間である。分布がタイムアウト側に集中していれば、2.4T の事例のように、資源再配置の寄与が小さくなる可能性が高そうだ。
ただし、verl はステップ間で GPU を貸す方式であり、QwenGyre はセルが進行中のバッチに段階的に加わる方式である。verl の結果で QwenGyre の高速化を検証することはできない。
非同期 RL と partial rollout 自体はすでに一般的である。slime v0.4.0 は全ワーカーを待たず、完了したグループから学習バッチを集める。AReaL は分離した GPU でロールアウトと学習を重ねる。この比較範囲では、QwenGyre の特徴は、セル単位の段階的参加、ハーネスを中断しないリクエスト移送、分岐軌跡処理の組み合わせにあるようだ。
実装コードがない段階での評価範囲
各セルにモデルメモリと学習の並列化を収める必要があるため、非常に小さな GPU 予算ではこの構成は難しい。著者らも、総 GPU 予算がはるかに小さい場合の効率は評価していないと述べた。192 ノードの数値を数十 GPU 規模のクラスタに適用するのは難しそうだ。
確認した arXiv v1 には実装リポジトリへのリンクがなく、MarkTechPost も同じ点を指摘した。これはリンクがないことの確認にすぎず、独立した検証ではない。
次に見る点は、コードが公開されるか、そしてタイムアウトへの集中が少ない分布や小さな予算で、Colocate との差がどう変わるかである。
2.4T実験でColocateより16.05時間早かった結果は長時間の実行がいつ終わるかに大きく左右され、コードや小規模実験がない段階でほかの環境への高速化を保証できない。