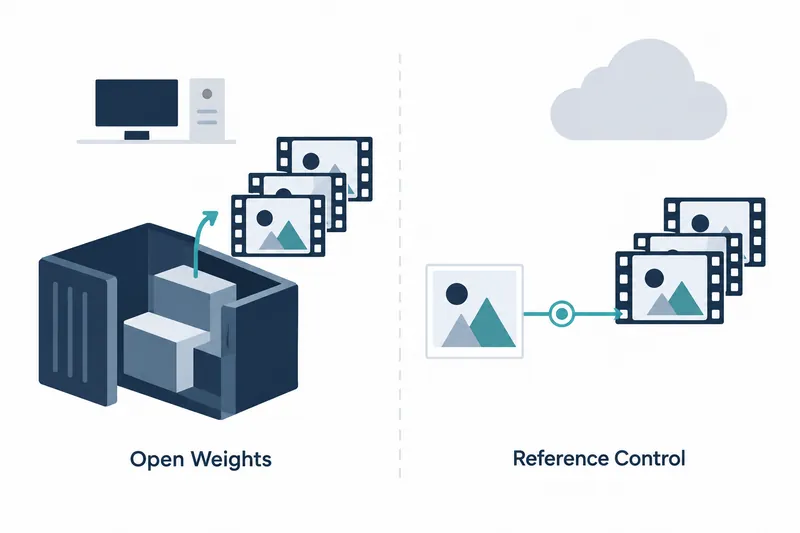
Pika于10月29日公开了可同时生成视频与声音的生成模型H3 Flex的权重和推理代码,即用训练好的模型生成结果的程序。开发者可下载后在自有硬件上运行,并输入图像、视频和声音作为参考素材来调整场景。高分辨率放大和音频成分分离仍属于Pika运营的API功能,本地运行与通过外部服务器提供功能的托管服务各有分工。
1. 将视频与声音生成缩减至六步
H3 Flex是基于MiniMax H3进行后续训练的模型。它同时生成视频和立体声音频,将逐步去除噪声以生成结果的迭代次数从原模型的50次缩减至6次。据公司公布,在以相同标准比较性能的受控基准测试中,生成15秒768p视频及同步音频的Transformer运算,即学习上下文关系的神经网络结构的计算,最少耗时7秒。
据公司公布,发布时它在DesignArena的文本生成视频榜单中位居开放权重模型第1名、总榜第7名。公司表示,将从11月2日起在自家视频制作产品中提供该模型。
2. 按参考素材分别指定人物、背景与动作
用户一次最多可输入12个参考素材,分别指定人物、背景和动作。介绍模型用法与限制的模型卡及代码仓库列出了多参考模式,即同时参考多个素材的方式下,各类文件的数量上限,如下所示。
表:多参考生成中各类输入的数量上限
条件:Pika H3 Flex多参考模式,参考文件总数最多12个
单位:个
| 项目 | 最大文件数 |
|---|---|
| 图像 | 9 |
| 视频 | 3 |
| 独立音频 | 3 |
各类上限与总数上限同时适用,因此组合素材时需包含图像或视频中的至少一种。视频和独立音频文件的时长各为2~15秒,视频总时长和独立音频总时长也各自不得超过15秒。
提示词,即输入模型的指令,可以说明各素材的作用及场景发展。例如,可将一张图像中的人物与另一张图像中的背景结合,并让模型参考视频中的动作或镜头运动。官方还介绍了基于参考的编辑方式,即依据参考素材修改内容:当某个部分不满意时,可以在保留原有表演和时序的同时,更换服装、道具或背景。
3. 本地生成,托管完成后期
公开的软件包支持文本输入、指定首尾帧及多参考方式生成。本地生成的视频为480p或768p,并包含混合立体声音频。借助附加在基础模型上的额外权重,即适配器,以及运行代码,可在自有硬件上运行模型,处理提示词和输入素材,生成MP4成品。
Pika API提供将初稿放大至1080p、2K、4K以提高视频分辨率的功能,以及五类音轨分离和可选的提示词增强,即自动优化输入指令的功能。可分离的音轨包括对白、音乐、音效、动作声和环境声。需要提高最终视频分辨率或在剪辑阶段单独处理声音的制作者,将额外使用这些托管功能。
4. 自行运行的收益是控制权,代价是基础设施
本地运行扩大了开发者直接运行模型和打造新工具的空间,但也需要自行准备硬件与存储空间。从仓库下载两种任务的全部权重后,基础文件约为210GB,适配器为5.5GB。实际生成时会加载与所选任务对应的模型部分。
仓库说明,典型的480p、768p请求已在单张H100 80GB上测试。为减轻显存负担,可选择将部分模型放在CPU上,但这会增加系统内存用量和数据传输时间。
前述7秒并非完整的API响应时间,实际完成时间会随参考输入、高分辨率后期处理、音频分离,以及硬件与服务处理开销而变化。本地软件包使用单张GPU处理一个请求,不支持将任务分配到多张GPU的多GPU分布式运行,因此较长的视频或较大的参考素材组合可能超出GPU显存容量。
安装需在具备Python 3.12、NVIDIA GPU及兼容驱动的环境中克隆仓库后进行。以下是README中的依赖安装和补丁应用命令,之后依次安装软件包并执行生成命令。
python -m pip install -r requirements.txt
python tools/apply_diffusers_patches.py
推理与加载器代码以Apache-2.0提供,适配器遵循MiniMax H3社区许可协议。
H3 Flex是一款可按需选用的制作工具,将迭代生成和场景控制带到自有硬件上运行,同时将高分辨率后期处理和音频分离留在托管服务中。