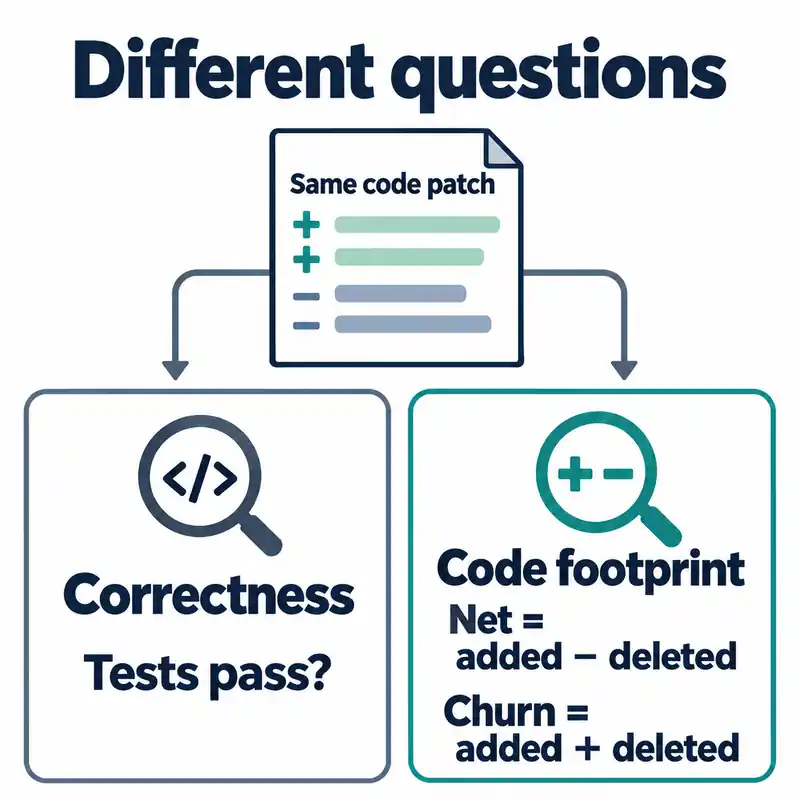
即使智能体修好了 bug,维护者面前也可能留下一份需要阅读的大补丁。Parsimony 解析 DeepSWE、SWE-bench Verified 和 SWE-bench Live 公开补丁应用前后的代码,统计新增和删除的“代码单元”。
它不重新运行测试,而是直接使用各基准公开的成功和失败结果。仓库说明任何人都能用公开数据重新计算每个数字。
代码单元统计的是语法元素而非格式
代码单元是一个语法元素,例如语句、调用、比较、名称或字面量。每个语句块末尾还有一个 EndBlock 单元,因此嵌套以及把代码移入或移出代码块也会被计入。
注释、格式、标点、括号和名称长度不计入。方法文档的例子中,`if x.count(y) > 0: foo(a, b)` 是 12 个单元。
Python 只统计 .py 实现文件,测试、文档、示例目录和生成文件等被排除。每条记录都会列出涉及的文件和被排除的文件。
净增单元(net_units)是新增量减去删除量,churn 是二者之和。净增很小也可能掩盖一次大规模重写。
需要超过 500 次编辑的重写使用按行锚定的近似算法并加以标记。只要应用前后任一侧无法解析,该文件就记为未知值(null),而不是 0。
先看测量了什么,再看排名
网站按解决了任务的尝试的平均净增代码单元从小到大为模型排名。旁边还显示包含失败在内的全部已测量尝试的同一平均值、基准解决率以及可测量的尝试数。
两个平均值列回答的是不同的问题。大量删除代码的失败补丁不会影响按成功尝试计算的排名。
因缺少原始文件或解析错误而无法测量的尝试会被排除,Measured 列显示已测量的数量。即使覆盖范围相同,各模型解决的任务集合也可能不同。
注意事项:命令行排行榜与网站排名的区别
命令行的 leaderboard 命令按中位数而不是平均值排序。--shared 选项把比较范围缩小到所选智能体都解决且都能分析的任务交集。
方法文档写道,--shared 能避免任务构成带来的混淆,但可能偏向简单任务。没有依据认为网站默认排名只比较共同任务。
README 的局限部分指出,写更多代码的模型往往也解决更多任务。在有 26 个以上模型的榜单上,斯皮尔曼相关系数为 0.33~0.60。
每个基准和语言都有单独的榜单,单元数不能跨榜单比较。各榜单的分析器版本也不同,从 0.5.2-beta 到 0.8.0-beta。
影响结果的不只是模型,还有智能体。DeepSWE 和 Verified 除 Verified 上的 GLM-5.1 外都使用 mini-SWE-agent,Live 的每个配置则使用各自的智能体。
方法文档提醒,测量结果取决于解释器的分词器,因此要比较的结果应使用同一个固定的 Python 版本。
把代码变化量变成审查问题
对维护者来说,代码变化量是提出问题的起点,而不是结论。可以同时看净增和 churn,询问可比的成功尝试新增和删除了什么。
然后在实际补丁中检查所需的验证、可读性以及基准未覆盖的行为。小补丁也许更容易审查,但这是读过补丁后才能做出的判断。
代码规模与技术债的界线
README 说明,单元衡量的是规模,而不是可读性或设计。公开榜单使用 beta 版分析器,成功与失败的依据来自原始基准。
Parsimony 的净增代码单元是与正确性和人工审查并列的辅助指标,单元更少并不意味着补丁更好。