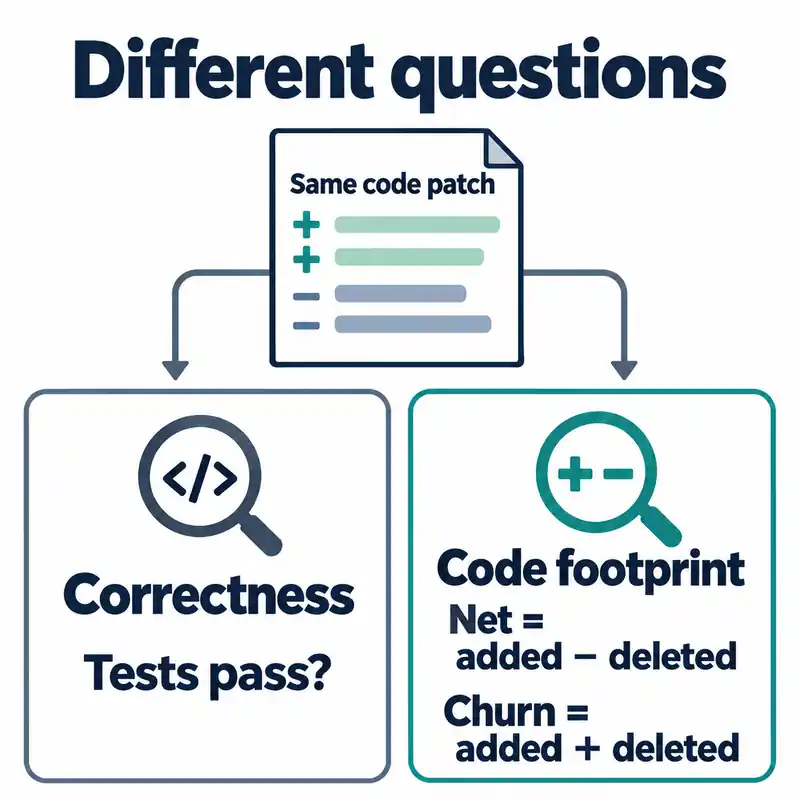
エージェントがバグを直しても、メンテナーには読むべき大きなパッチが残ることがある。ParsimonyはDeepSWE、SWE-bench Verified、SWE-bench Liveで公開されたパッチの適用前後のコードを解析し、追加・削除された「コード単位」を数える。
テストは再実行せず、各ベンチマークが公開した成功・失敗の結果をそのまま使う。公開データだけで誰でもすべての数値を再計算できる、というのがリポジトリの説明だ。
書式ではなく構文要素を数えるコード単位
コード単位は、文、呼び出し、比較、名前、リテラルといった構文要素1つだ。各文ブロックの末尾にはEndBlock単位が1つ付くため、ネストやブロックへのコードの出し入れも数に入る。
コメント、書式、句読点、括弧、名前の長さは数えない。方法文書の例では、`if x.count(y) > 0: foo(a, b)`は12単位だ。
Pythonでは.pyの実装ファイルだけを数え、テスト・ドキュメント・サンプルのディレクトリや生成ファイルなどは除外する。各記録には対象ファイルと除外ファイルの一覧が残る。
純増単位(net_units)は追加量から削除量を引いた値で、churnは両者の和だ。純増が小さくても大きな書き換えが起きていることがある。
500回を超える編集が必要な書き換えは行単位の近似で計算し、その旨を記録する。適用前後のどちらかでパースできないファイルは、0ではなく不明な値(null)として扱う。
順位より先に見る測定対象
ウェブサイトは、タスクを解決した試行の平均純増コード単位が小さい順にモデルを並べる。隣には、失敗を含む全測定試行の同じ平均、ベンチマークの解決率、測定できた試行数が並ぶ。
2つの平均列は別々の問いに答える。コードを大量に削除した失敗パッチは、成功試行に基づく順位に影響しない。
元ファイルの欠落やパースエラーで測定できない試行は除外され、Measured列が測定できた数を示す。測定範囲が同じでも、モデルごとに解いたタスクの集合は異なりうる。
注意点:コマンドラインのリーダーボードとウェブサイト順位の違い
コマンドラインのleaderboardコマンドは、平均ではなく中央値で並べる。--sharedオプションは、選んだエージェントがすべて解決し、かつ解析もできたタスクの共通部分に比較対象を絞る。
方法文書は、--sharedがタスク構成の違いによる交絡を避ける一方、易しいタスクに有利になりうると書いている。ウェブサイトの既定の順位が共通タスクだけを比較していると考える根拠はない。
READMEの限界の項目は、コードを多く書くモデルほどタスクも多く解く傾向を示している。モデルが26以上あるボードで、スピアマンの相関係数は0.33〜0.60だった。
ベンチマークと言語ごとに別のボードがあり、単位数はボード間で比較できない。アナライザーのバージョンもボードごとに0.5.2-betaから0.8.0-betaまで異なる。
結果に影響するのはモデルだけでなくエージェントもだ。DeepSWEとVerifiedは、VerifiedのGLM-5.1を除いてすべてmini-SWE-agentを使い、Liveは構成ごとに独自のエージェントを使った。
方法文書は、測定がインタープリターのトークナイザーに左右されうるため、比較する結果には固定したPythonのバージョン1つを使うよう案内している。
コード変化量をレビューの問いに変える方法
メンテナーにとってコード変化量は判定ではなく、問いの出発点だ。純増とchurnを併せて見ながら、比較可能な成功試行が何を追加し何を消したかを問う。
次に、実際のパッチで必要な検証、読みやすさ、ベンチマークが扱わなかった動作を確認する。小さなパッチはレビューしやすいかもしれないが、それはパッチを読んで下す判断だ。
コードの大きさと技術的負債の境界
READMEは、単位が測るのは大きさであり、読みやすさや設計ではないと記している。公開ボードはベータ版のアナライザーを使い、成功・失敗の根拠は元のベンチマークにある。
Parsimonyの純増コード単位は正確性と人のレビューの横に置く補助指標であり、単位が少ないからといってよいパッチになるわけではない。