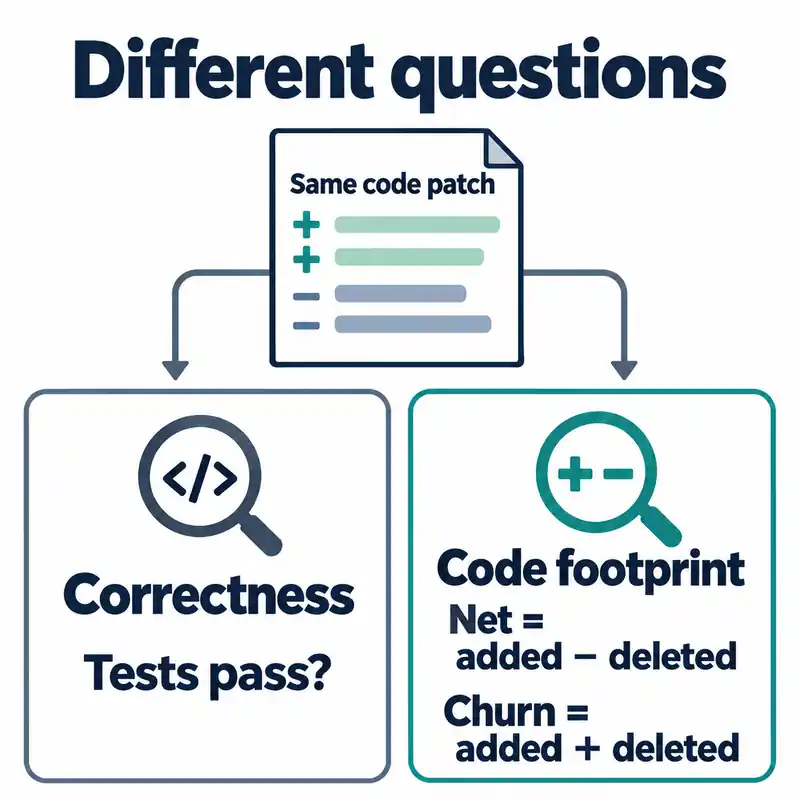
에이전트가 버그를 고쳐도 유지보수자에게는 읽어야 할 큰 패치가 남을 수 있다. Parsimony는 DeepSWE, SWE-bench Verified, SWE-bench Live에 공개된 패치의 적용 전후 코드를 파싱해 추가·삭제된 ‘코드 단위’를 센다.
테스트는 다시 실행하지 않고 각 벤치마크가 공개한 성공·실패 결과를 그대로 쓴다. 공개 데이터만으로 누구나 모든 수치를 다시 계산할 수 있다는 것이 저장소의 설명이다.
서식이 아닌 문법 요소를 세는 코드 단위
코드 단위는 문장, 호출, 비교, 이름, 리터럴 같은 문법 요소 하나다. 각 문장 블록 끝에는 EndBlock 단위가 하나 붙어 중첩이나 블록 안팎으로의 코드 이동도 셈에 들어간다.
주석, 서식, 구두점, 괄호, 이름 길이는 세지 않는다. 방법 문서의 예에서 `if x.count(y) > 0: foo(a, b)`는 12단위다.
Python에서는 .py 구현 파일만 세고 테스트·문서·예제 디렉터리와 생성 파일 등은 뺀다. 각 기록에는 포함된 파일과 제외된 파일 목록이 남는다.
순증 단위(net_units)는 추가량에서 삭제량을 뺀 값이고, churn은 두 값을 더한 값이다. 순증이 작아도 큰 재작성이 있었을 수 있다.
500회를 넘는 편집이 필요한 재작성은 줄 단위 근사로 계산하고 표시를 남긴다. 적용 전후 어느 쪽이든 파싱되지 않는 파일은 0이 아니라 알 수 없는 값(null)으로 처리한다.
순위보다 먼저 볼 측정 대상
웹사이트는 과제를 해결한 시도의 평균 순증 코드 단위가 작은 순서로 모델 순위를 매긴다. 옆에는 실패를 포함한 전체 측정 시도의 같은 평균, 벤치마크 해결률, 측정 가능했던 시도 수가 함께 표시된다.
두 평균 열은 서로 다른 질문에 답한다. 코드를 대량 삭제한 실패 패치는 성공 시도 기준 순위에 영향을 주지 않는다.
원본 파일 누락이나 파싱 오류로 측정할 수 없는 시도는 제외되고, Measured 열이 측정된 수를 보여 준다. 측정 범위가 같아도 모델마다 해결한 과제 집합은 다를 수 있다.
주의할 점: 명령줄 순위표와 웹사이트 순위의 차이
명령줄 leaderboard 명령은 평균이 아니라 중앙값으로 정렬한다. --shared 옵션은 비교 대상을 선택한 에이전트가 모두 해결했고 분석도 가능한 과제의 교집합으로 좁힌다.
방법 문서는 --shared가 과제 구성 차이를 줄이지만 쉬운 과제에 유리할 수 있다고 적는다. 웹사이트 기본 순위가 공통 과제만 비교한다고 볼 근거는 없다.
README의 한계 항목은 코드를 더 많이 쓰는 모델이 과제도 더 많이 푸는 경향을 밝힌다. 모델이 26개 이상인 보드에서 스피어먼 상관계수가 0.33~0.60이었다.
벤치마크와 언어마다 별도 보드가 있고, 단위 수는 보드 사이에서 비교할 수 없다. 보드별로 분석기 버전도 0.5.2-beta부터 0.8.0-beta까지 다르다.
모델만이 아니라 에이전트도 결과에 영향을 준다. DeepSWE와 Verified는 Verified의 GLM-5.1을 빼면 모두 mini-SWE-agent를 썼고, Live는 구성마다 각자의 에이전트를 썼다.
방법 문서는 단위 측정이 인터프리터의 토크나이저에 따라 달라질 수 있어, 비교할 결과에는 고정된 Python 버전 하나를 쓰라고 안내한다.
코드 변화량을 검토 질문으로 바꾸는 방법
유지보수자에게 코드 변화량은 판정이 아니라 질문의 출발점이다. 비교할 만한 성공 시도에서 무엇을 추가하고 무엇을 지웠는지 순증과 churn을 함께 보며 묻는 식이다.
그다음 실제 패치에서 필요한 검증, 읽기 쉬움, 벤치마크가 다루지 않은 동작을 확인한다. 작은 패치가 검토하기 쉬울 수는 있지만, 그것은 패치를 읽고 내릴 판단이다.
코드 크기와 기술 부채의 경계
README는 단위가 크기를 잴 뿐 읽기 쉬움이나 설계를 재지 않는다고 밝힌다. 공개 보드는 베타 분석기 버전을 쓰며, 성공·실패의 근거는 원래 벤치마크에 있다.
Parsimony의 순증 코드 단위는 정확성과 사람의 검토 옆에 두는 보조 지표이며, 단위가 적다고 더 나은 패치가 되는 것은 아니다.