NVIDIA 发布了开放模型 RFD4-Proteina 的教程,该模型可一次性设计蛋白质序列和全原子(all-atom,即所有原子坐标)结构。它可接入奖励引导的推理时搜索,在生成过程中使用评分函数(预言机)打分,仅保留有潜力的候选,而非先大量生成再筛选,让分子设计团队和 ML 工程师通过代码反复筛选待实验验证的候选。GitHub 开放模型与 NIM 微服务(NVIDIA 以容器提供的推理服务器)共用同一条件规范,即运行所需输入条件的说明。
准备事项
条件:Linux x86_64 主机、Python 3.12、配备 CUDA 13 兼容驱动的 NVIDIA GPU;使用 CUDA 12 驱动的主机需采用第 2 步的手动安装分支。
表:模型与安装要求
分步操作
1. 确定目标与条件。输入为带注释的 CIF(包含结构与注释的分子文件格式),或条件规范及其原始结构文件。本教程以 PDB 5O45 的裁剪结构为目标,指定 Tyr56·Met115·Tyr123 热点(结合位点),设计长度为 100~150 个残基(氨基酸单位)的新结合蛋白,即与目标结合的蛋白质。
git clone https://github.com/RosettaCommons/RFD4-Proteina.git
cd RFD4-Proteina
cat > pdl1.json <<'JSON'
{
"pdl1_binder": {
"input": "docs/examples/inputs/5o45_cropped.cif",
"contig": "100-150, /0, A17-131",
"conditions": {
"C_CRD": {"true": [{"select": "sel('A') and is_protein_backbone"}]},
"C_SEQ": {"true": [{"select": "sel('A')"}]},
"C_HOT": {"true": [
{"select": "sel('A/*/56/[CG,OH]')"},
{"select": "sel('A/*/115/[CG,SD]')"},
{"select": "sel('A/*/123/[CD2,OH]')"}
]}
}
}
}
JSON
2. 准备环境。开放模型的仓库脚本会按 CUDA 13 配置下载环境和 Hugging Face 权重包。uv 已在 0.12.24 版本上验证;若已安装,需更新以识别 CUDA 13.2。
bash setup.sh --native
source .venv/bin/activate
使用 CUDA 12 驱动的主机需在第 1 步克隆的仓库中,改用手动安装而非脚本来获取 CUDA 12 配置。
# 한 환경에 CUDA extra는 하나만 설치한다, 선택형 BioIR 백엔드는 CUDA 13 전용
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install "uv>=0.13.4"
uv pip install --no-sources --torch-backend cu126 -e '.[all-cuda12]'
export DATA_PATH="${DATA_PATH:-$PWD/data_path}"
./scripts/download_assets.sh "$DATA_PATH" --skip-of3
bash scripts/setup_search_envs.sh
使用 NIM 时,以 NGC API key 登录,并在 8000 端口启动容器。
read -rsp 'NGC API key: ' NGC_API_KEY; echo
export NGC_API_KEY
printf '%s' "$NGC_API_KEY" | docker login nvcr.io \
-u '$oauthtoken' --password-stdin
image=nvcr.io/nim/ipd/rfd4-proteina:latest
docker pull "$image"
export RFD4_NIM_IMAGE="$(docker image inspect \
--format '{{index .RepoDigests 0}}' "$image")"
printf '%s\n' "$RFD4_NIM_IMAGE" > nim-image.txt
export LOCAL_NIM_CACHE="$HOME/.cache/nim"
mkdir -p "$LOCAL_NIM_CACHE"
docker run -d --rm --name rfd4-proteina \
--runtime=nvidia --gpus 'device=0' -p 8000:8000 \
-e NGC_API_KEY -v "$LOCAL_NIM_CACHE":/opt/nim/.cache \
--shm-size=16g "$RFD4_NIM_IMAGE"
3. 生成候选。输出保存在 runs/pdl1-open/inference_samples/ 下;若需生成多个候选,可添加 num_replicates=10。将以下脚本保存为仓库根目录下的 design.py。
# design.py
import hydra
from rfd4_proteina import Proteina
from rfproteina.generate import run_generation

@hydra.main(config_path="configs", config_name="inference", version_base="1.3")
def main(cfg):
    model = Proteina.from_pretrained("nvidia/RFD4-Proteina")
    run_generation(cfg, model=model)

if __name__ == "__main__":
    main()
python design.py inputs=pdl1.json out_dir=runs/pdl1-open seed=42 compile_lengths=null4. 利用奖励搜索。搜索预设使用 2 个分支、束宽 3(同时保留的候选数),在 20·40·50·60 步评分。奖励为 OpenFold3 的 pLDDT(预测结构置信度分数),下限为 50,并保存奖励不低于 80 的 rollout,即一次生成与评估过程。
python design.py inference_experiment=inference_beam_example \
metrics/refolding_oracles=of3 inputs=pdl1.json subset_to_examples=null \
num_replicates=1 out_dir=runs/pdl1-open-search seed=42 compile_lengths=null
NIM 路径将同一条件规范与目标 CIF 一起发送,调用生成端点。将以下脚本保存为仓库根目录下的 nim_client.py。
# nim_client.py
import json
from pathlib import Path
import requests

spec = json.loads(Path("pdl1.json").read_text())["pdl1_binder"]
target = Path(spec["input"])
spec["input"] = target.name
payload = {
    "task": "motif_scaffolding",
    "input": {"format": "condition_spec", "example_id": "pdl1_binder",
              "spec": spec,
              "files": [{"filename": target.name, "content": target.read_text()}]},
    "sampling": {"num_replicates": 1, "seed": 42},
    "metrics": {"tags": ["design", "hotspot_conditioning"]},
}

def submit(payload, out):
    out.mkdir(parents=True, exist_ok=True)
    response = requests.post(
        "http://localhost:8000/biology/ipd/rfd4-proteina/generative",
        json=payload, timeout=1800)
    response.raise_for_status()
    result = response.json()
    (out / "response.json").write_text(json.dumps(result, indent=2))
    for i, design in enumerate(result["designs"]):
        dest = out / f"design-{i}.cif"
        dest.write_text(design["structure"]["content"])
        print(design["design_id"], dest)

if __name__ == "__main__":
    submit(payload, Path("runs/pdl1-nim"))
python -m pip install requests
python nim_client.py速度如何
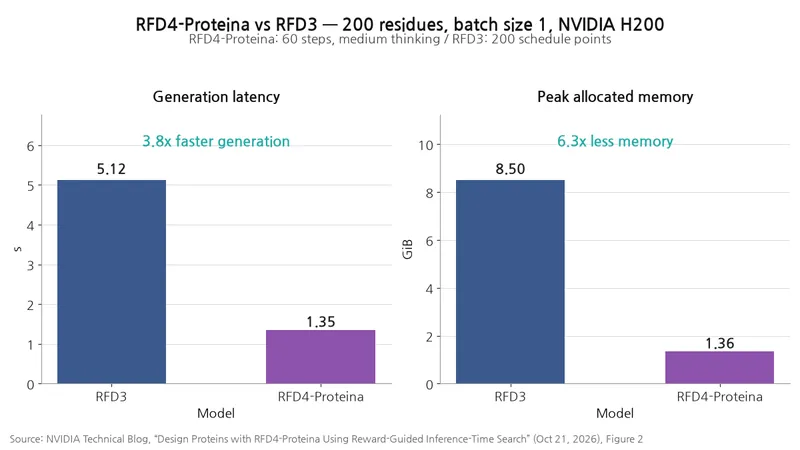
条件:200 个残基、批量 1、NVIDIA H200;RFD4-Proteina 为 60 步 medium thinking,RFD3 为 200 个调度点,来源为 NVIDIA 技术博客 Figure 2。
表:RFD4-Proteina 与 RFD3 生成性能对比
据 NVIDIA 公布的数据,延迟与内存占用均有降低。这源于残基级潜在表示(latent representation,即压缩结构的向量)以及扩散过程(从噪声恢复结构的生成流程)的改进,使采样步数,即更新候选的迭代次数,从 Proteina-Complexa 的约 400 步降至 60 步。
条件:测试了 6 种 Hopper GPU 配置,批量 1;对 15 种序列长度(128~1,024 个 token)预热后,汇总端到端耗时;对比基准为默认编译后端,来源为 NVIDIA 技术博客 Figure 4。
表:各 Hopper GPU 的 BioIR 加速倍数
单位:倍
BioIR 是与 BioNeMo Inference Runtime(BIR)团队共同开发的加速后端。NVIDIA 表示,在 H100 PCIe 上,测试套件(将多项测试合并运行的任务)的执行时间从 161 秒降至 111 秒。
验证进展
条件:项目预印本论文(同行评审前公开的论文)所报告的实验结果,各设计组条件不同。
表:实验验证结果
预印本报告称,在计算基准中,高性能 thinking 单次生成的蛋白质结合簇通过率为 10.6%,高于 BindCraft 的 5.9%,吞吐量则高出 42 倍。簇通过率是将设计序列用 AlphaFold3 重新折叠后,仅统计通过各任务计算标准的不同结构的计算指标,区别于表中的实验验证结果。
常见问题
1. 权重访问。若 Hugging Face 仓库访问受限,传入 HF_TOKEN 或通过 hf auth login 认证。2. 预言机环境。OpenFold3 运行时与权重为可选安装,GPU 主机须具备 Apptainer。NIM 中需挂载 reward.py 回调,设置 NIM_ALLOW_ORACLE_PLUGIN=true 和 OF3_NIM_API_KEY,再重启服务。3. 搜索结果数量因运行而异。应直接查看生成的 CIF 与保留的指标筛选候选,不要只看单一分数,还要查看 ipTM·ipSAE 等界面指标,即评估结合面结构与接触的数值。
局限
pLDDT 奖励是预测置信度指标,并非结合证据。Hugging Face 模型卡中的每 GPU 小时通过设计数,来自 2026 年 10 月 9 日固定基准对先前版本组合的测量,不应视为当前版本的性能。
在满足 NIM 要求的 Linux 主机上准备 NVIDIA 驱动、NVIDIA Container Toolkit、Docker、NGC API key、1 张 GPU 和目标结构文件,运行 PD-L1 条件规范;代码开发选用 GitHub 开放模型,服务选用 NIM,候选追踪选用将候选、输入与指标整合至同一台账的 rfd4-proteina-campaign 技能。