NVIDIAは、タンパク質配列と全原子(all-atom、すべての原子座標)構造を一度に設計する公開モデルRFD4-Proteinaのチュートリアルを公開した。多数の候補を生成してから選別する代わりに、生成中に採点関数(オラクル)で評価し、有望な候補だけを残す報酬ベースの推論時探索を追加できる。分子設計チームやMLエンジニアは、実験検証に回す候補を絞る工程をコードで反復できる。GitHubのオープンモデルとNIMマイクロサービス(NVIDIAがコンテナで提供する推論サーバー)は、実行に必要な入力条件の明細である同じ条件仕様を共有する。
準備するもの
条件:Linux x86_64ホスト、Python 3.12、CUDA 13対応ドライバーのNVIDIA GPU、CUDA 12ドライバーのホストは手順2の手動インストール分岐を使用
表:モデル・インストール要件
手順
1. ターゲットと条件を決める。入力には注釈付きCIF(構造・注釈を格納する分子ファイル形式)、または条件仕様とその元の構造ファイルを指定する。このチュートリアルではPDB 5O45の切り出し構造をターゲットにし、Tyr56・Met115・Tyr123のホットスポット(結合部位)を指定して、標的に結合する新しいタンパク質であるバインダーを100~150残基(アミノ酸単位)で設計する。
git clone https://github.com/RosettaCommons/RFD4-Proteina.git
cd RFD4-Proteina
cat > pdl1.json <<'JSON'
{
"pdl1_binder": {
"input": "docs/examples/inputs/5o45_cropped.cif",
"contig": "100-150, /0, A17-131",
"conditions": {
"C_CRD": {"true": [{"select": "sel('A') and is_protein_backbone"}]},
"C_SEQ": {"true": [{"select": "sel('A')"}]},
"C_HOT": {"true": [
{"select": "sel('A/*/56/[CG,OH]')"},
{"select": "sel('A/*/115/[CG,SD]')"},
{"select": "sel('A/*/123/[CD2,OH]')"}
]}
}
}
}
JSON
2. 環境を準備する。オープンモデルでは、リポジトリのスクリプトがCUDA 13プロファイルで環境とHugging Faceの重みバンドルを取得する。uvは0.12.24で検証済みで、インストール済みの場合はCUDA 13.2を認識するように更新する。
bash setup.sh --native
source .venv/bin/activate
CUDA 12ドライバーのホストでは、手順1で複製したリポジトリでスクリプトの代わりに手動インストールを行い、CUDA 12プロファイルを取得する。
# 한 환경에 CUDA extra는 하나만 설치한다, 선택형 BioIR 백엔드는 CUDA 13 전용
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install "uv>=0.13.4"
uv pip install --no-sources --torch-backend cu126 -e '.[all-cuda12]'
export DATA_PATH="${DATA_PATH:-$PWD/data_path}"
./scripts/download_assets.sh "$DATA_PATH" --skip-of3
bash scripts/setup_search_envs.sh
NIMを使う場合はNGC API keyでログインし、ポート8000でコンテナを起動する。
read -rsp 'NGC API key: ' NGC_API_KEY; echo
export NGC_API_KEY
printf '%s' "$NGC_API_KEY" | docker login nvcr.io \
-u '$oauthtoken' --password-stdin
image=nvcr.io/nim/ipd/rfd4-proteina:latest
docker pull "$image"
export RFD4_NIM_IMAGE="$(docker image inspect \
--format '{{index .RepoDigests 0}}' "$image")"
printf '%s\n' "$RFD4_NIM_IMAGE" > nim-image.txt
export LOCAL_NIM_CACHE="$HOME/.cache/nim"
mkdir -p "$LOCAL_NIM_CACHE"
docker run -d --rm --name rfd4-proteina \
--runtime=nvidia --gpus 'device=0' -p 8000:8000 \
-e NGC_API_KEY -v "$LOCAL_NIM_CACHE":/opt/nim/.cache \
--shm-size=16g "$RFD4_NIM_IMAGE"
3. 候補を生成する。出力はruns/pdl1-open/inference_samples/の下に蓄積され、複数の候補を生成するにはnum_replicates=10を追加する。以下のスクリプトをリポジトリのルートにdesign.pyとして保存する。
# design.py
import hydra
from rfd4_proteina import Proteina
from rfproteina.generate import run_generation

@hydra.main(config_path="configs", config_name="inference", version_base="1.3")
def main(cfg):
    model = Proteina.from_pretrained("nvidia/RFD4-Proteina")
    run_generation(cfg, model=model)

if __name__ == "__main__":
    main()
python design.py inputs=pdl1.json out_dir=runs/pdl1-open seed=42 compile_lengths=null4. 報酬で探索する。探索プリセットは分岐2個、ビーム幅3(同時に保持する候補数)で、20・40・50・60ステップ時に採点する。報酬はOpenFold3のpLDDT(予測構造の信頼度スコア)で、下限値は50とし、報酬80以上のロールアウト(1回の生成・評価過程)を保存する。
python design.py inference_experiment=inference_beam_example \
metrics/refolding_oracles=of3 inputs=pdl1.json subset_to_examples=null \
num_replicates=1 out_dir=runs/pdl1-open-search seed=42 compile_lengths=null
NIM経路では、同じ条件仕様とターゲットCIFを一緒に送り、生成エンドポイントを呼び出す。以下のスクリプトをリポジトリのルートにnim_client.pyとして保存する。
# nim_client.py
import json
from pathlib import Path
import requests

spec = json.loads(Path("pdl1.json").read_text())["pdl1_binder"]
target = Path(spec["input"])
spec["input"] = target.name
payload = {
    "task": "motif_scaffolding",
    "input": {"format": "condition_spec", "example_id": "pdl1_binder",
              "spec": spec,
              "files": [{"filename": target.name, "content": target.read_text()}]},
    "sampling": {"num_replicates": 1, "seed": 42},
    "metrics": {"tags": ["design", "hotspot_conditioning"]},
}

def submit(payload, out):
    out.mkdir(parents=True, exist_ok=True)
    response = requests.post(
        "http://localhost:8000/biology/ipd/rfd4-proteina/generative",
        json=payload, timeout=1800)
    response.raise_for_status()
    result = response.json()
    (out / "response.json").write_text(json.dumps(result, indent=2))
    for i, design in enumerate(result["designs"]):
        dest = out / f"design-{i}.cif"
        dest.write_text(design["structure"]["content"])
        print(design["design_id"], dest)

if __name__ == "__main__":
    submit(payload, Path("runs/pdl1-nim"))
python -m pip install requests
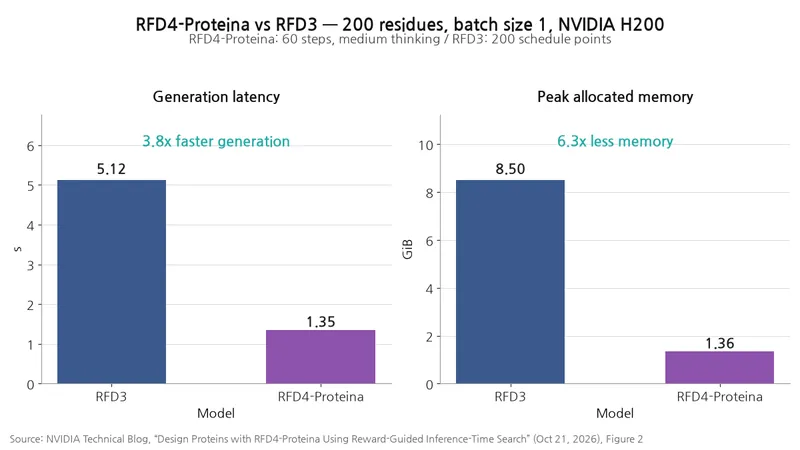
python nim_client.pyどれほど速いのか
条件:200残基、バッチ1、NVIDIA H200、RFD4-Proteinaは60ステップのmedium thinking / RFD3は200スケジュールポイント、出典はNVIDIA技術ブログFigure 2
表:RFD4-ProteinaとRFD3の生成性能比較
NVIDIAの発表によると、遅延とメモリ使用量がともに減った。残基単位の潜在表現(latent representation、構造を圧縮したベクトル)と、ノイズから構造を復元する生成手順である拡散プロセスの刷新により、候補を更新する反復回数であるサンプリングステップがProteina-Complexaの約400ステップから60に減ったためだ。
条件:テストしたHopper GPUの6構成、バッチ1、15種類の配列長128~1,024トークンでウォームアップ後にエンドツーエンド時間を合算、比較基準はデフォルトのコンパイルバックエンド、出典はNVIDIA技術ブログFigure 4
表:Hopper GPU別のBioIR高速化倍率
単位:倍
BioIRはBioNeMo Inference Runtime(BIR)チームと共同開発した高速化バックエンドだ。NVIDIAによると、H100 PCIeでは複数のテストをまとめて実行するスイートの実行時間が161秒から111秒に短縮された。
検証はどこまで進んだか
条件:プロジェクト論文のプレプリント(査読前の公開論文)に報告された実験結果、設計群ごとに条件が異なる
表:実験検証の結果
論文のプレプリントによると、計算ベンチマークでは高性能thinkingによる単一生成のタンパク質結合クラスター合格率が10.6%で、BindCraftの5.9%より高く、スループットは42倍高い。クラスター合格率は、設計配列をAlphaFold3で再フォールディングし、課題ごとの計算基準を満たした異なる構造だけを数える計算指標で、表の実験検証結果とは区別される。
よくつまずく点
1. 重みへのアクセス。Hugging Faceリポジトリへのアクセスが制限される場合は、HF_TOKENを渡すかhf auth loginで認証する。2. オラクル環境。OpenFold3のランタイムと重みは任意インストールで、GPUホストにApptainerが必要だ。NIMではreward.pyコールバックをマウントし、NIM_ALLOW_ORACLE_PLUGIN=trueとOF3_NIM_API_KEYを設定してサービスを再起動する。3. 探索結果の数は実行ごとに異なる。生成されたCIFと保持された指標を直接見て候補を選び、単一のスコアだけでなく、結合面の構造や接触を評価するipTM・ipSAEなどの界面指標も確認する。
限界
pLDDT報酬は結合の証拠ではなく、予測信頼度の指標だ。Hugging FaceのモデルカードにあるGPU時間当たりの合格設計数は、2026年10月9日の固定ベンチマークで以前のリリースの組み合わせを測定した値で、現行リリースの性能と解釈してはいけない。
NIM要件を満たすLinuxホストでPD-L1条件仕様を実行し、開発にはGitHubのオープンモデル、サービスにはNIMを選び、rfd4-proteina-campaignで候補・入力・指標を一元管理する。