NVIDIA가 단백질 시퀀스와 전체 원자(all-atom, 모든 원자 좌표) 구조를 한 번에 설계하는 공개 모델 RFD4-Proteina의 튜토리얼을 공개했다. 후보를 많이 뽑은 뒤 골라내는 대신 생성 도중에 채점 함수(오라클)로 점수를 매겨 유망한 후보만 남기는 보상 기반 추론 시점 탐색을 붙일 수 있어, 분자 설계팀과 ML 엔지니어가 실험 검증에 올릴 후보를 좁히는 과정을 코드로 반복할 수 있다. GitHub 오픈 모델과 NIM 마이크로서비스(NVIDIA가 컨테이너로 제공하는 추론 서버)는 같은 조건 스펙, 실행에 필요한 입력 조건의 명세를 공유한다.
준비물
조건: Linux x86_64 호스트, Python 3.12, CUDA 13 호환 드라이버의 NVIDIA GPU, CUDA 12 드라이버 호스트는 2단계 수동 설치 분기 사용
표: 모델·설치 요구 사항
단계별로
1. 타깃과 조건을 정한다. 입력은 주석이 달린 CIF(구조·주석을 담은 분자 파일 형식)나 조건 스펙과 그 원본 구조 파일로 준다. 이 튜토리얼은 PDB 5O45 크롭 구조를 타깃으로 잡고 Tyr56·Met115·Tyr123 핫스팟(결합 부위)을 지정해 새 바인더, 표적에 결합하는 단백질을 100~150잔기(아미노산 단위)로 설계한다.
git clone https://github.com/RosettaCommons/RFD4-Proteina.git
cd RFD4-Proteina
cat > pdl1.json <<'JSON'
{
"pdl1_binder": {
"input": "docs/examples/inputs/5o45_cropped.cif",
"contig": "100-150, /0, A17-131",
"conditions": {
"C_CRD": {"true": [{"select": "sel('A') and is_protein_backbone"}]},
"C_SEQ": {"true": [{"select": "sel('A')"}]},
"C_HOT": {"true": [
{"select": "sel('A/*/56/[CG,OH]')"},
{"select": "sel('A/*/115/[CG,SD]')"},
{"select": "sel('A/*/123/[CD2,OH]')"}
]}
}
}
}
JSON
2. 환경을 준비한다. 오픈 모델은 저장소 스크립트가 CUDA 13 프로필로 환경과 Hugging Face 가중치 번들을 함께 받는다. uv는 0.12.24로 검증됐고, 이미 설치돼 있으면 CUDA 13.2를 인식하도록 갱신한다.
bash setup.sh --native
source .venv/bin/activate
CUDA 12 드라이버 호스트는 1단계에서 복제한 저장소에서 스크립트 대신 수동 설치로 CUDA 12 프로필을 받는다.
# 한 환경에 CUDA extra는 하나만 설치한다, 선택형 BioIR 백엔드는 CUDA 13 전용
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install "uv>=0.13.4"
uv pip install --no-sources --torch-backend cu126 -e '.[all-cuda12]'
export DATA_PATH="${DATA_PATH:-$PWD/data_path}"
./scripts/download_assets.sh "$DATA_PATH" --skip-of3
bash scripts/setup_search_envs.sh
NIM을 쓸 경우 NGC API key로 로그인해 컨테이너를 8000 포트에 띄운다.
read -rsp 'NGC API key: ' NGC_API_KEY; echo
export NGC_API_KEY
printf '%s' "$NGC_API_KEY" | docker login nvcr.io \
-u '$oauthtoken' --password-stdin
image=nvcr.io/nim/ipd/rfd4-proteina:latest
docker pull "$image"
export RFD4_NIM_IMAGE="$(docker image inspect \
--format '{{index .RepoDigests 0}}' "$image")"
printf '%s\n' "$RFD4_NIM_IMAGE" > nim-image.txt
export LOCAL_NIM_CACHE="$HOME/.cache/nim"
mkdir -p "$LOCAL_NIM_CACHE"
docker run -d --rm --name rfd4-proteina \
--runtime=nvidia --gpus 'device=0' -p 8000:8000 \
-e NGC_API_KEY -v "$LOCAL_NIM_CACHE":/opt/nim/.cache \
--shm-size=16g "$RFD4_NIM_IMAGE"
3. 후보를 생성한다. 출력은 runs/pdl1-open/inference_samples/ 아래에 쌓이고, 후보를 여러 개 뽑으려면 num_replicates=10을 더한다. 아래 스크립트를 저장소 루트의 design.py로 저장한다.
# design.py
import hydra
from rfd4_proteina import Proteina
from rfproteina.generate import run_generation

@hydra.main(config_path="configs", config_name="inference", version_base="1.3")
def main(cfg):
    model = Proteina.from_pretrained("nvidia/RFD4-Proteina")
    run_generation(cfg, model=model)

if __name__ == "__main__":
    main()
python design.py inputs=pdl1.json out_dir=runs/pdl1-open seed=42 compile_lengths=null4. 보상으로 탐색한다. 검색 프리셋은 분기 2개와 빔 폭 3(동시에 유지하는 후보 수)으로 20·40·50·60스텝에서 채점한다. 보상은 OpenFold3의 pLDDT(예측 구조 신뢰도 점수)이며 바닥값 50, 보상 80 이상 롤아웃, 한 번의 생성·평가 과정 저장이다.
python design.py inference_experiment=inference_beam_example \
metrics/refolding_oracles=of3 inputs=pdl1.json subset_to_examples=null \
num_replicates=1 out_dir=runs/pdl1-open-search seed=42 compile_lengths=null
NIM 경로는 같은 조건 스펙과 타깃 CIF를 함께 보내 생성 엔드포인트를 호출한다. 아래 스크립트를 저장소 루트의 nim_client.py로 저장한다.
# nim_client.py
import json
from pathlib import Path
import requests

spec = json.loads(Path("pdl1.json").read_text())["pdl1_binder"]
target = Path(spec["input"])
spec["input"] = target.name
payload = {
    "task": "motif_scaffolding",
    "input": {"format": "condition_spec", "example_id": "pdl1_binder",
              "spec": spec,
              "files": [{"filename": target.name, "content": target.read_text()}]},
    "sampling": {"num_replicates": 1, "seed": 42},
    "metrics": {"tags": ["design", "hotspot_conditioning"]},
}

def submit(payload, out):
    out.mkdir(parents=True, exist_ok=True)
    response = requests.post(
        "http://localhost:8000/biology/ipd/rfd4-proteina/generative",
        json=payload, timeout=1800)
    response.raise_for_status()
    result = response.json()
    (out / "response.json").write_text(json.dumps(result, indent=2))
    for i, design in enumerate(result["designs"]):
        dest = out / f"design-{i}.cif"
        dest.write_text(design["structure"]["content"])
        print(design["design_id"], dest)

if __name__ == "__main__":
    submit(payload, Path("runs/pdl1-nim"))
python -m pip install requests
python nim_client.py얼마나 빠른가
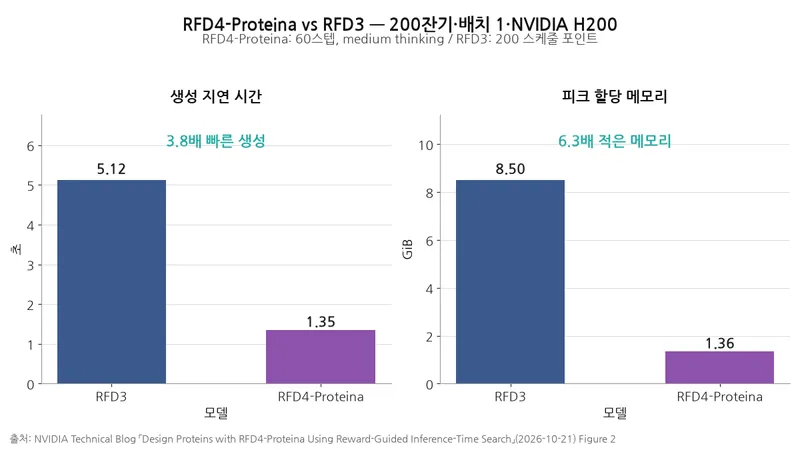
조건: 200잔기, 배치 1, NVIDIA H200, RFD4-Proteina는 60스텝 medium thinking / RFD3는 200 스케줄 포인트, 출처는 NVIDIA 기술 블로그 Figure 2
표: RFD4-Proteina와 RFD3 생성 성능 비교
NVIDIA 발표 기준으로 지연과 메모리가 함께 줄었다. 이유는 잔기 단위 잠재 표현(latent representation, 구조를 압축한 벡터)과 디퓨전 공정, 잡음에서 구조를 복원하는 생성 절차 개편으로, 샘플링 스텝, 후보를 갱신하는 반복 횟수가 Proteina-Complexa의 약 400스텝에서 60으로 줄었다.
조건: 테스트한 Hopper GPU 6종 구성, 배치 1, 15개 시퀀스 길이 128~1,024 토큰 워밍업 후 엔드투엔드 시간 합산, 비교 기준은 기본 컴파일 백엔드, 출처는 NVIDIA 기술 블로그 Figure 4
표: Hopper GPU별 BioIR 가속 배수
단위: 배
BioIR는 BioNeMo Inference Runtime(BIR) 팀이 함께 만든 가속 백엔드로, H100 PCIe에서는 스위트, 여러 시험을 묶어 실행하는 작업 실행 시간이 161초에서 111초로 줄었다고 NVIDIA가 밝혔다.
검증은 어디까지 왔나
조건: 프로젝트 논문 프리프린트, 심사 전 공개 논문에 보고된 실험 결과, 설계군별 조건 상이
표: 실험 검증 결과
논문 프리프린트는 계산상 벤치마크에서 고성능 thinking 단일 생성의 단백질 결합 클러스터 통과율이 10.6%로, BindCraft의 5.9%보다 높고 처리량은 42배 높다고 보고한다. 클러스터 통과율은 설계 시퀀스를 AlphaFold3로 재접힌 뒤 과제별 계산 기준을 통과한 서로 다른 구조만 세는 계산 지표로, 표의 실험 검증 결과와는 구분된다.
자주 막히는 곳
1. 가중치 접근. Hugging Face 저장소 접근이 제한되면 HF_TOKEN을 넘기거나 hf auth login으로 인증한다. 2. 오라클 환경. OpenFold3 런타임과 가중치는 선택 설치고 GPU 호스트에 Apptainer가 있어야 한다. NIM에서는 reward.py 콜백을 마운트하고 NIM_ALLOW_ORACLE_PLUGIN=true와 OF3_NIM_API_KEY를 설정해 서비스를 다시 띄운다. 3. 검색 결과 개수는 실행마다 다르다. 생성된 CIF와 유지된 지표를 직접 보고 후보를 선별하며, 점수 하나만 보지 말고 ipTM·ipSAE 같은 인터페이스 지표, 결합면의 구조와 접촉을 평가하는 수치도 함께 본다.
한계
pLDDT 보상은 결합의 증거가 아니라 예측 신뢰도 지표다. Hugging Face 모델 카드에 적힌 GPU시간당 통과 설계 수는 2026년 10월 9일 고정 벤치마크에서 이전 릴리스 쌍을 측정한 값이라 현재 릴리스 성능으로 읽으면 안 된다.
NIM 요구 조건을 충족한 Linux 호스트에 NVIDIA 드라이버와 NVIDIA Container Toolkit, Docker, NGC API key, GPU 한 장과 타깃 구조 파일을 준비해 PD-L1 조건 스펙을 실행하고, 코드 개발에는 GitHub 오픈 모델을, 서비스에는 NIM을, 후보 추적에는 후보·입력·지표를 한 원장에 묶는 rfd4-proteina-campaign 스킬을 선택한다.