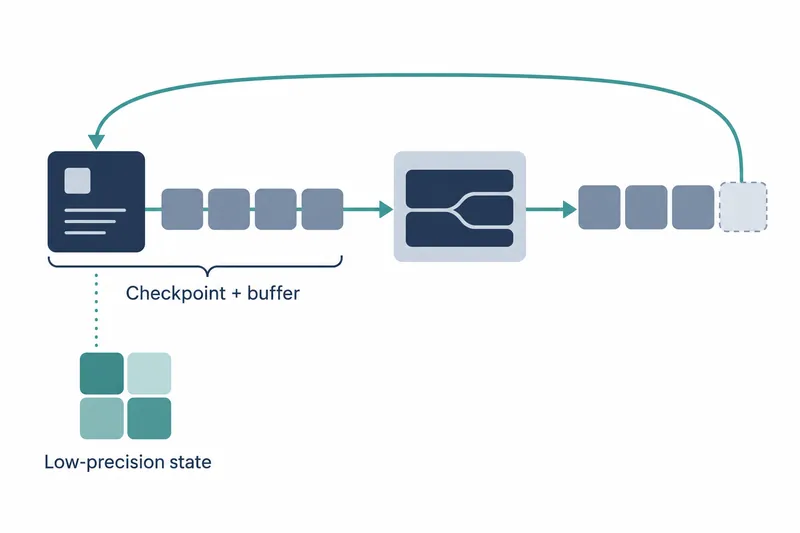
语言模型服务器开发者可以通过收集最近的输入,而非每次覆盖庞大的状态,降低词元生成成本。英伟达与普林斯顿大学研究团队的新方法可在同时处理多个请求时提速,也让回退错误预测的词元或降低存储精度变得更容易。
1. 存储最近的输入,而非完整状态
混合模型将把上下文概括为固定大小状态的状态空间模型,与引用先前词元的注意力层结合起来。状态空间模型每处理一个词元都要读写完整状态,但计算量较小,因此内存传输速度可能成为瓶颈。
ReplaySSM 用区间起始时保存的检查点和最近的输入缓冲区来表示状态。这就像分别保留基准余额与最近的交易,而非每次修改整本账簿。为计算输出,每个词元仍需读取检查点,但仅在缓冲区满时,每个区间写入一次。与每个词元都读写的方式相比,它消除了大部分写入,使占主导的状态传输量大约减半。与原有方式的输出差异在浮点计算误差范围内。
2. 在大批量下减少状态传输
评估对象是两个系列的小型和大型模型,共四个模型。小型模型采用 16 位浮点权重,大型模型采用 4 位浮点权重。
两个小型模型在单张 H100 上运行,两个大型模型在单张 B300 上运行。性能实验使用 32 位浮点状态,输入区间为 16 个词元。
在批量大小为 256 时,状态空间模型内核(执行特定运算的代码单元)的速度提升至 1.46~1.80 倍,完整词元生成阶段提升至 1.20~1.47 倍。比较对象是优化过运行配置的 vLLM 内核,内核数据也包含检查点更新成本。批量大小为 1 时,其他延迟因素占主导,因此没有速度收益。性能结果原文
3. 通过缓冲区位置回退错误预测
推测解码由目标模型一次性验证预先预测的草稿词元。原有实现为回退而保留每个词元的状态副本。ReplaySSM 将草稿输入放入缓冲区,仅将截至接受位置的部分视为有效,因此无需恢复被拒绝词元的状态。验证时也不生成中间状态,只计算输出。
实验让前述两个大型模型解答数学问题,在草稿为 4 个词元、输入区间为 16 个词元、状态为 32 位的条件下进行比较。在批量大小为 512 时,吞吐量为原有框架 vLLM 推测解码的 1.85~2.10 倍,且接受的词元长度保持一致。推测解码结果原文
4. 防止低精度误差持续累积
低精度状态可减少读取的数据量,但若舍入误差传入下一次更新,就会累积。ReplaySSM 将用于更新的高精度检查点与用于输出的低精度副本分离。输出副本不参与下一次更新,因此其误差不会传播到后续更新。
在 GPQA-Diamond 的标准解码实验中,输入区间为 16 个词元,输出副本采用 4 位浮点格式。更新采用 16 位或 8 位浮点格式,并使用随机舍入(按概率舍入到相邻可表示值)。四个模型中有三个与 32 位状态基准的准确率差距在约 2 个百分点以内。准确率结果原文
准确率并未完全保持不变。Nemotron-3-Nano-4B 在两种更新精度下分别下降了 6.7 个百分点和 5.6 个百分点。虽然小于读取与更新共用低精度存储副本时的 31.3 个百分点降幅,但结果表明仍需针对各模型验证。各模型损失原文
5. 同时查看公开实现与成本
公开代码位于 vLLM 的分叉仓库中,提供标准解码、推测解码内核,以及单独的精度实验代码。虽然部分路径已合入基础框架,但部分内核与精度实验实现仅存在于该仓库。
复现核查:评估模型为 Nemotron 3 和 Qwen3.5 系列的 4B 级与 120B 级模型。推测解码实验使用两个 120B 级模型解答 GSM8K 问题,每个模型在单张 B300 上运行。
以下是原文的复现命令。前两条命令比较标准解码速度,最后一条比较推测解码吞吐量。
python benchmarks/replayssm/e2e_decode_speedup.py --model-id nvidia/NVIDIA-Nemotron-3-Nano-4B-BF16
python benchmarks/replayssm/e2e_decode_speedup.py --model-id Qwen/Qwen3.5-4B
python benchmarks/replayssm/e2e_spec_decode_throughput.py --batch-size 512 \
    --model-id nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4
减少状态写入和每个草稿词元的副本,代价是需要维护输入缓冲区。分离精度后,更新时还要额外写入低精度副本。也就是说,它并非消除了存储成本,而是将每次执行的状态写入转移为按区间更新和缓冲区管理。
ReplaySSM 的核心是分离输出计算与状态更新,这一设计将减少状态传输、优化推测验证与抑制低精度误差累积联系起来。