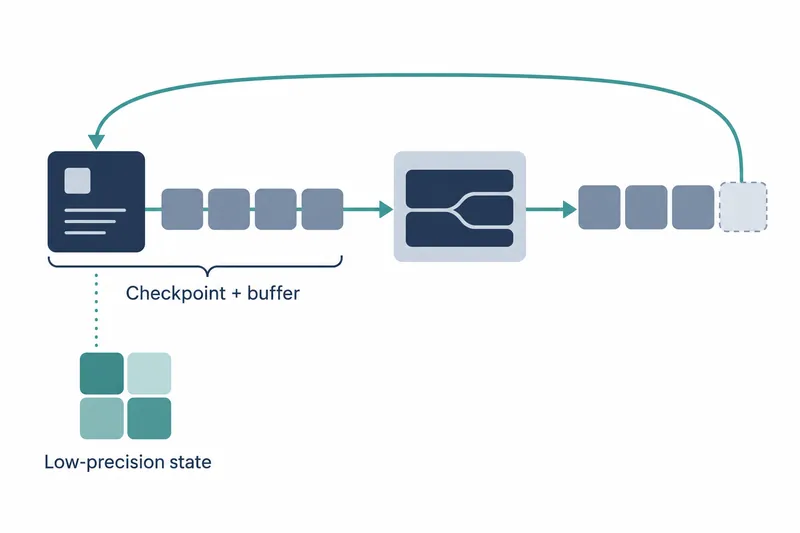
言語モデルサーバーの開発者は、大きな状態を毎回上書きする代わりに、直近の入力を蓄える方式でトークン生成の費用を減らせる。NVIDIAとプリンストン大学の研究チームによる新手法は、複数のリクエストをまとめて処理する際に高速化し、誤予測したトークンの取り消しや保存精度の引き下げも容易にする。
1. 状態全体ではなく直近の入力を保存する
ハイブリッドモデルは、文脈を固定サイズの状態に要約する状態空間モデルと、以前のトークンを参照するアテンション層を組み合わせる。状態空間モデルはトークンごとに状態全体を読み書きするが、計算量は少ないため、メモリ転送速度がボトルネックになり得る。
ReplaySSMは、区間の開始時に保存した状態であるチェックポイントと、直近の入力バッファで状態を表現する。帳簿全体を毎回修正せず、基準残高と直近の取引を分けて置くようなものだ。出力計算のためにチェックポイントはトークンごとに読むが、書き込みはバッファが満杯になるときに区間ごとに1回だけ行う。トークンごとに読み書きしていた方式から書き込みの大半を省くため、支配的な状態転送量はおよそ半分になる。従来方式との出力の差は浮動小数点の計算誤差の範囲内だ。
2. 大きなバッチで状態転送を減らす
評価対象は2系統の小型・大型モデルで、計4モデルだ。小型モデルには16ビット、大型モデルには4ビットの浮動小数点重みを用いた。
小型の2モデルはH100を1枚、大型の2モデルはB300を1枚使って実行した。性能実験の状態は32ビット浮動小数点で、入力区間は16トークンだった。
バッチサイズ256では、状態空間モデルのカーネル(特定の演算を行う実行コードの単位)が1.46~1.80倍、トークン生成工程全体が1.20~1.47倍に高速化した。比較対象は実行設定を最適化したvLLMカーネルで、カーネルの数値にはチェックポイントの更新費用も含む。バッチサイズ1では他の遅延要因が支配的で、速度向上はなかった。性能結果の原文
3. 誤った予測はバッファ位置で巻き戻す
投機的デコーディングは、あらかじめ予測したドラフトトークンを対象モデルがまとめて検証する方式だ。従来の実装は、巻き戻しのためにトークンごとの状態コピーを残していた。ReplaySSMはドラフト入力をバッファに入れ、受理した位置までを有効として扱うため、拒否されたトークンの状態を復元する必要がない。検証時も中間状態を作らず、出力だけを計算する。
先に評価した大型モデル2つに数学問題を解かせ、ドラフト4トークン、入力区間16トークン、32ビット状態の条件で比較した。バッチサイズ512では、スループットは既存フレームワークvLLMの投機的デコーディングの1.85~2.10倍で、受理されたトークン長はそろえた。投機的デコーディング結果の原文
4. 低精度の誤差を再び蓄積させない
低精度の状態は読み込むデータ量を減らすが、丸め誤差が次の更新に引き継がれると蓄積する。ReplaySSMは更新用の高精度チェックポイントと出力用の低精度コピーを分離する。出力用コピーを次の更新に使わないため、そのコピーの誤差は以降の更新に伝播しない。
GPQA-Diamondでの標準デコーディング、入力区間16トークンの実験では、4ビット浮動小数点の出力用コピーを使った。更新には16ビットまたは8ビット浮動小数点と、確率的丸め(隣接する表現値へ確率に応じて丸める方式)を適用した。4モデル中3モデルは、32ビット状態を基準とする正解率との差が約2%ポイント以内だった。正解率結果の原文
正解率が完全に維持されたわけではない。Nemotron-3-Nano-4Bは、2つの更新精度でそれぞれ6.7%ポイントと5.6%ポイント低下した。読み込みと更新に低精度の保存状態を共有した場合の31.3%ポイントの低下よりは小さいが、モデルごとの検証が必要だと示す結果だ。モデル別の損失の原文
5. 公開実装と費用を併せて確認する
公開コードはvLLMをフォークしたリポジトリにある。標準・投機的デコーディングのカーネルと、別途精度実験用のコードを提供する。ベースのフレームワークに統合された経路もあるが、一部のカーネルと精度実験の実装はこのリポジトリにしかない。
再現の確認:評価モデルはNemotron 3とQwen3.5系統の4B級・120B級だ。投機的デコーディング実験は120B級の2モデルにGSM8Kの問題を使い、モデルごとにB300を1枚使って実行した。
以下は原文の再現コマンドだ。最初の2つのコマンドは標準デコーディングの速度を、最後のコマンドは投機的デコーディングのスループットを比較する。
python benchmarks/replayssm/e2e_decode_speedup.py --model-id nvidia/NVIDIA-Nemotron-3-Nano-4B-BF16
python benchmarks/replayssm/e2e_decode_speedup.py --model-id Qwen/Qwen3.5-4B
python benchmarks/replayssm/e2e_spec_decode_throughput.py --batch-size 512 \
    --model-id nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4
状態の書き込みとドラフトトークンごとのコピーを減らす代わりに、入力バッファを維持する必要がある。精度を分離すると、更新時に低精度コピーも追加で書き込む。つまり、保存費用をなくすのではなく、毎回の状態書き込みを区間ごとの更新とバッファ管理に移す。
ReplaySSMの核心である出力計算と状態更新の分離は、状態転送の削減、投機的検証の最適化、低精度での誤差蓄積の抑制を結び付ける。