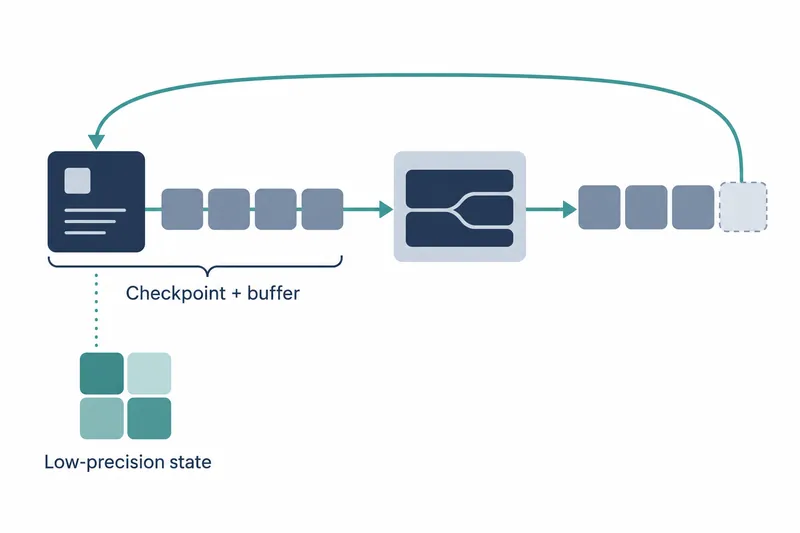
언어 모델 서버 개발자는 큰 상태를 매번 덮어쓰는 대신 최근 입력을 모아 두는 방식으로 토큰 생성 비용을 줄일 수 있다. 엔비디아와 프린스턴대학교 연구팀의 새 기법은 여러 요청을 함께 처리할 때 속도를 높이고, 잘못 예측한 토큰을 되돌리거나 저장 정밀도를 낮추기도 쉽게 한다.
1. 상태 전체 대신 최근 입력을 저장한다
하이브리드 모델은 문맥을 고정 크기 상태로 요약하는 상태 공간 모델과 이전 토큰을 참조하는 어텐션 계층을 섞는다. 상태 공간 모델은 매 토큰마다 상태 전체를 읽고 쓰지만 계산량은 적어, 메모리 전송 속도가 병목이 될 수 있다.
ReplaySSM은 상태를 구간 시작의 저장본인 체크포인트와 최근 입력 버퍼로 표현한다. 장부 전체를 매번 고치는 대신 기준 잔액과 최근 거래를 따로 두는 셈이다. 출력 계산을 위해 체크포인트는 매 토큰 읽지만, 쓰기는 버퍼가 찰 때 구간당 한 번만 한다. 매 토큰 읽기와 쓰기를 모두 하던 방식에서 쓰기 대부분을 없애므로, 지배적인 상태 전송량은 대략 절반으로 줄어든다. 기존 방식과의 출력 차이는 부동소수점 계산 오차 범위다.
2. 큰 배치에서 상태 전송을 줄인다
평가 대상은 두 계열의 소형·대형 모델로, 모두 네 모델이다. 작은 모델은 16비트, 큰 모델은 4비트 부동소수점 가중치를 썼다.
작은 두 모델은 H100 한 장, 큰 두 모델은 B300 한 장에서 실행했다. 성능 실험의 상태는 32비트 부동소수점이고 입력 구간은 16토큰이었다.
배치 크기 256에서 상태 공간 모델 커널(특정 연산을 수행하는 실행 코드 단위)은 1.46~1.80배, 전체 토큰 생성 단계는 1.20~1.47배 빨라졌다. 비교 대상은 실행 설정을 최적화한 vLLM 커널이며, 커널 수치에는 체크포인트 갱신 비용도 포함된다. 배치 크기 1에서는 다른 지연 요인이 앞서 속도 이득이 없었다. 성능 결과 원문
3. 틀린 예측은 버퍼 위치로 되돌린다
추측 디코딩은 미리 예측한 초안 토큰을 대상 모델이 한꺼번에 검증하는 방식이다. 기존 구현은 되돌리기 위해 토큰마다 상태 사본을 남겼다. ReplaySSM은 초안 입력을 버퍼에 넣고 받아들인 위치까지만 유효하게 처리하므로, 거절된 토큰의 상태를 복원할 필요가 없다. 검증 때도 중간 상태를 만들지 않고 출력만 계산한다.
앞서 평가한 대형 모델 두 개로 수학 문제를 풀게 하고, 초안 4토큰, 입력 구간 16토큰, 32비트 상태 조건으로 비교했다. 배치 크기 512에서 처리량은 기존 프레임워크인 vLLM의 추측 디코딩 대비 1.85~2.10배였으며, 받아들인 토큰 길이는 맞췄다. 추측 디코딩 결과 원문
4. 낮은 정밀도의 오차가 다시 쌓이지 않게 한다
저정밀도 상태는 읽는 데이터양을 줄이지만 반올림 오차가 다음 갱신으로 넘어가면 누적된다. ReplaySSM은 갱신용 고정밀도 체크포인트와 출력용 저정밀도 사본을 분리한다. 출력용 사본을 다음 갱신에 쓰지 않아 그 사본의 오차가 이후 갱신으로 전파되지 않는다.
GPQA-Diamond의 표준 디코딩, 입력 구간 16토큰 실험에서는 4비트 부동소수점 출력용 사본을 썼다. 갱신에는 16비트 또는 8비트 부동소수점과 확률적 반올림(인접한 표현값으로 확률에 따라 반올림하는 방식)을 적용했다. 네 모델 중 세 모델이 32비트 상태 기준 정확도와 약 2%포인트 이내였다. 정확도 결과 원문
정확도가 완전히 보존되지는 않았다. Nemotron-3-Nano-4B는 두 갱신 정밀도에서 각각 6.7%포인트와 5.6%포인트 낮았다. 읽기와 갱신에 저정밀도 저장본을 공유할 때의 31.3%포인트 하락보다는 작지만, 모델별 검증이 필요하다는 결과다. 모델별 손실 원문
5. 공개 구현과 비용을 함께 확인한다
공개 코드는 vLLM을 분기한 저장소다. 표준·추측 디코딩 커널과 별도 정밀도 실험 코드를 제공한다. 기본 프레임워크에 합쳐진 경로도 있지만, 일부 커널과 정밀도 실험 구현은 이 저장소에만 있다.
재현 확인: 평가 모델은 Nemotron 3과 Qwen3.5 계열의 4B급·120B급이다. 추측 디코딩 실험은 120B급 두 모델에 GSM8K 문제를 사용하고, 모델당 B300 한 장에서 실행했다.
다음은 원문의 재현 명령이다. 앞의 두 명령은 표준 디코딩 속도, 마지막 명령은 추측 디코딩 처리량을 비교한다.
python benchmarks/replayssm/e2e_decode_speedup.py --model-id nvidia/NVIDIA-Nemotron-3-Nano-4B-BF16
python benchmarks/replayssm/e2e_decode_speedup.py --model-id Qwen/Qwen3.5-4B
python benchmarks/replayssm/e2e_spec_decode_throughput.py --batch-size 512 \
    --model-id nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4
상태 쓰기와 초안 토큰별 사본을 줄이는 대신 입력 버퍼를 유지해야 한다. 정밀도를 분리하면 갱신 때 저정밀도 사본도 추가로 쓴다. 즉, 저장 비용을 없애기보다 매번 하던 상태 쓰기를 구간별 갱신과 버퍼 관리로 옮긴다.
ReplaySSM의 핵심인 출력 계산과 상태 갱신의 분리는 상태 전송 감소, 추측 검증 최적화, 저정밀도 오차 누적 억제를 연결한다.