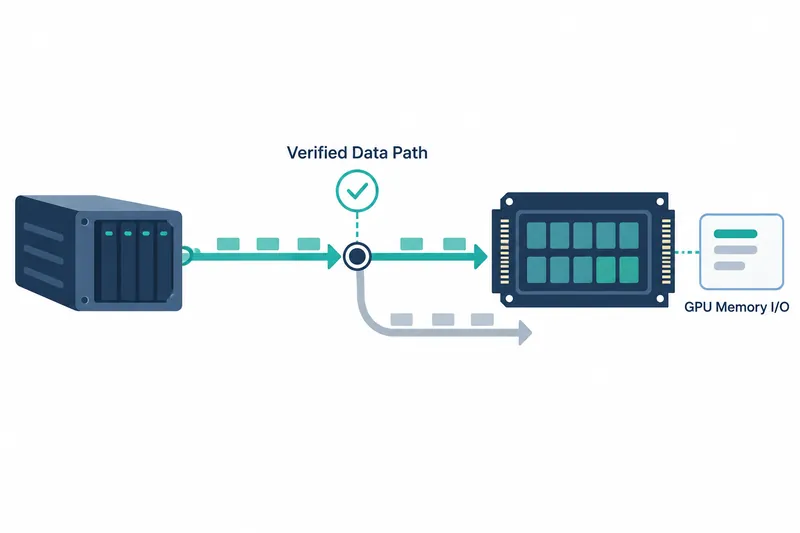
NVIDIA 公布了在 Python 中将文件读入 GPU 内存并确认是否实际使用加速路径的 KvikIO 使用方法。将大量数据移至 GPU 的开发者可结合读取代码和运行统计信息,检查数据是否经过 CPU 内存。
1. KvikIO 和 cuFile 分层决定路径
GPUDirect Storage(GDS)在支持的存储设备与 GPU 内存之间提供直接数据路径。这项技术减少了将 CPU 内存作为中转站的环节。
对于基于文件系统的存储设备,cuFile 是访问 GDS 的 C 库。KvikIO 在其之上提供 Python 和 C++ 接口,用于文件读取和运行设置。
实际路径选择分为两步。首先,KvikIO 决定将请求发送给 cuFile,还是通过自身经过 CPU 内存的兼容路径处理。随后,底层库根据系统支持情况、文件系统和设置,选择加速路径或经过 CPU 内存的路径。
2. 检查安装环境和读取设置
运行教程需要配备 NVIDIA GPU 且已安装 GDS 的 Linux 系统,以及受支持的存储设备和文件系统。还需具备在存储设备上创建、读取和写入文件的权限,以及访问诊断工具的权限。
安装适用于 CUDA 13 的 KvikIO 时,用于处理 GPU 数组的 CuPy 也会作为依赖项安装。教程环境中的兼容模式为自动选择,尝试使用加速路径的最小请求大小为 16 KiB。
自动选择模式会先尝试 cuFile,若不可用,则转为通过 CPU 内存的自身文件读取路径。小于最小请求大小的读取也会直接使用这条自身路径。
可通过以下原文代码检查安装版本和设置。
import kvikio
import kvikio.cufile_driver as cufile_driver
import kvikio.defaults as defaults

kvikio.__version__
cufile_driver.libcufile_version()
defaults.get("compat_mode").name
defaults.get("gds_threshold")
3. 读入 GPU 缓冲区后检查统计信息
读取时,在 GPU 内存中创建与文件大小相同的 CuPy 数组,并将其作为目标缓冲区传入。使用 KvikIO 打开文件并读取后,可通过返回值确认读取的字节数。
仅凭读取成功或调用了 cuFile,无法判断是否实际使用加速路径。传输路径需通过运行统计信息检查。
将 cuFile 的进程级统计级别,即按各个运行程序分别汇总的级别,设置为 3 后执行读取。以交互方式运行 Python,即即时输入并获取结果,在保持进程运行的状态下,用 gds_stats 查看累计计数器,也就是运行后持续累加的统计值。
NVIDIA 公布的 1 GiB 读取按默认任务大小 4 MiB 拆分为 256 次操作。下表为该公司公布的同一次运行中按 GPU 统计的信息。
x86_64、NVIDIA H100、CUDA 13.3、cuFile 1.18、本地 NVMe·ext4、GPU 与存储设备之间最多经过一个 PCIe 桥的 PIX 连接、禁用 IOMMU·ACS、加载 nvidia-fs 内核模块、KvikIO 任务大小 4 MiB、读取大小 1 GiB
| 项目 | 操作次数 |
|---|---|
| 全部读取(n) | 256 |
| 加速路径(nvfs) | 256 |
| cuFile 兼容路径(posix) | 0 |
全部 256 次操作均被计入加速路径。据该公司公布的数据,这条路径的读取总量为 1,024 MiB。这些统计信息展示了上述配置下数据实际采用的路径。
4. 综合考虑请求拆分与开销
大规模读取先由 KvikIO 拆分为任务单元,cuFile 还可根据运行设置再次分块并行处理。因此,调整请求拆分时,需要同时检查上层库的任务大小与底层的并行执行设置。
直接路径的优势在于减少经过 CPU 内存的环节,据 NVIDIA 介绍,系统 CPU 使用率也会降低。不过,如果像教程中那样未将目标 GPU 缓冲区注册用于存储设备传输,就会产生先读入已注册的 GPU 临时缓冲区、再复制到目标位置的开销。
使用 KvikIO 的关键是同时具备 GPU 内存读取代码和运行路径检查手段,以确认数据的移动方式。