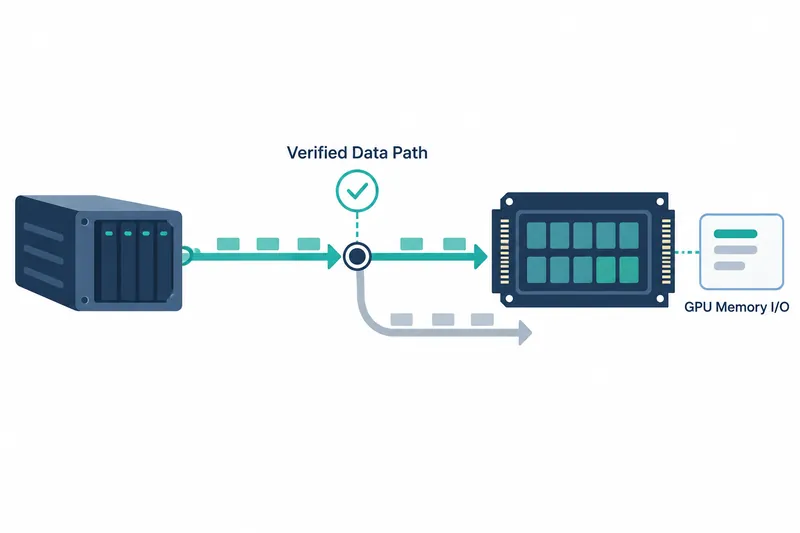
NVIDIA가 파이썬에서 파일을 GPU 메모리로 읽고 실제로 가속 경로를 이용했는지 확인하는 KvikIO 활용법을 공개했다. 대용량 데이터를 GPU로 옮기는 개발자는 읽기 코드와 실행 통계를 함께 살펴 데이터가 CPU 메모리를 거쳐 갔는지 점검할 수 있다.
1. KvikIO와 cuFile이 경로를 나눠 결정한다
GPUDirect Storage(GDS)는 지원 저장장치와 GPU 메모리 사이에 직접 데이터 경로를 제공한다. CPU 메모리를 중간 집하장처럼 거치는 단계를 줄이는 기술이다.
파일 시스템 기반 저장장치에서는 cuFile이 GDS에 접근하는 C 라이브러리다. KvikIO는 그 위에서 파이썬과 C++ 인터페이스를 제공해 파일 읽기와 실행 설정을 다룬다.
실제 경로 선택은 두 단계다. 먼저 KvikIO가 요청을 cuFile로 보낼지, CPU 메모리를 거치는 자체 호환 경로로 처리할지 정한다. 다음으로 아래 계층의 라이브러리가 시스템 지원 상태와 파일 시스템, 설정에 맞춰 가속 경로 또는 CPU 메모리 경유 경로를 고른다.
2. 설치 환경과 읽기 설정을 살핀다
튜토리얼을 실행하려면 NVIDIA GPU와 GDS가 설치된 리눅스 시스템, 지원 저장장치와 파일 시스템이 필요하다. 저장장치의 파일을 만들고 읽고 쓸 권한과 진단 도구에 접근할 권한도 준비한다.
CUDA 13용 KvikIO를 설치하면 GPU 배열을 다루는 CuPy도 의존성으로 설치된다. 튜토리얼 환경의 호환 모드는 자동 선택이었고, 가속 경로 사용을 시도하는 최소 요청 크기는 16 KiB였다.
자동 선택에서는 cuFile을 먼저 시도하고 사용할 수 없으면 CPU 메모리를 거치는 자체 파일 읽기로 전환한다. 최소 요청 크기보다 작은 읽기도 이 자체 경로를 바로 이용한다.
설치 버전과 설정은 다음 원문 코드로 확인한다.
import kvikio
import kvikio.cufile_driver as cufile_driver
import kvikio.defaults as defaults

kvikio.__version__
cufile_driver.libcufile_version()
defaults.get("compat_mode").name
defaults.get("gds_threshold")
3. GPU 버퍼로 읽은 뒤 통계를 확인한다
읽을 때는 파일 크기만큼 CuPy 배열을 GPU 메모리에 만들고 목적지 버퍼로 넘긴다. KvikIO로 파일을 열어 읽으면 반환값으로 읽은 바이트 수를 확인할 수 있다.
읽기 성공이나 cuFile 호출만으로는 실제 가속 경로 이용 여부를 알 수 없다. 전송 경로는 실행 통계로 살핀다.
cuFile의 프로세스별 통계 수준, 실행 중인 프로그램마다 나눈 집계 수준을 3으로 설정하고 읽기를 실행한다. 파이썬을 대화형으로, 입력과 결과를 바로 주고받는 방식으로 실행해 프로세스를 살려 둔 상태에서 gds_stats로 누적 카운터, 실행 뒤 계속 더해지는 집계값을 확인하는 방식이다.
NVIDIA가 공개한 1 GiB 읽기는 기본 작업 크기 4 MiB에 따라 256개 연산으로 나뉘었다. 다음은 회사 발표 기준으로 같은 실행에서 확인한 GPU별 통계다.
x86_64, NVIDIA H100, CUDA 13.3, cuFile 1.18, 로컬 NVMe·ext4, GPU와 저장장치 사이 PCIe 브리지 최대 하나인 PIX 연결, IOMMU·ACS 비활성, nvidia-fs 커널 모듈 적재, KvikIO 작업 크기 4 MiB, 읽기 크기 1 GiB
| 항목 | 연산 수 |
|---|---|
| 전체 읽기(n) | 256 |
| 가속 경로(nvfs) | 256 |
| cuFile 호환 경로(posix) | 0 |
전체 256개 연산이 가속 경로로 집계됐다. 회사 발표 기준으로 이 경로의 읽기 총량은 1,024 MiB였다. 이 통계는 위 구성에서 데이터가 어느 길을 택했는지 보여 주는 결과다.
4. 요청 분할과 비용을 함께 고려한다
큰 읽기는 KvikIO가 먼저 작업 단위로 나누고, cuFile이 실행 설정에 따라 다시 조각내 병렬로 처리할 수 있다. 따라서 요청 분할을 조정할 때는 상위 라이브러리의 작업 크기와 아래 계층의 병렬 실행 설정을 함께 살피는 것이 중요하다.
직접 경로의 이익은 CPU 메모리 경유 단계를 줄이는 데 있으며, NVIDIA 설명에 따르면 시스템 CPU 사용률도 낮아진다. 다만 튜토리얼처럼 목적지 GPU 버퍼를 저장장치 전송용으로 등록하지 않은 경우에는 등록된 GPU 임시 버퍼로 먼저 읽고 목적지로 복사하는 비용이 생긴다.
KvikIO 활용의 핵심은 GPU 메모리 읽기 코드와 실행 경로 점검을 함께 갖춰 데이터 이동 방식을 확인하는 데 있다.