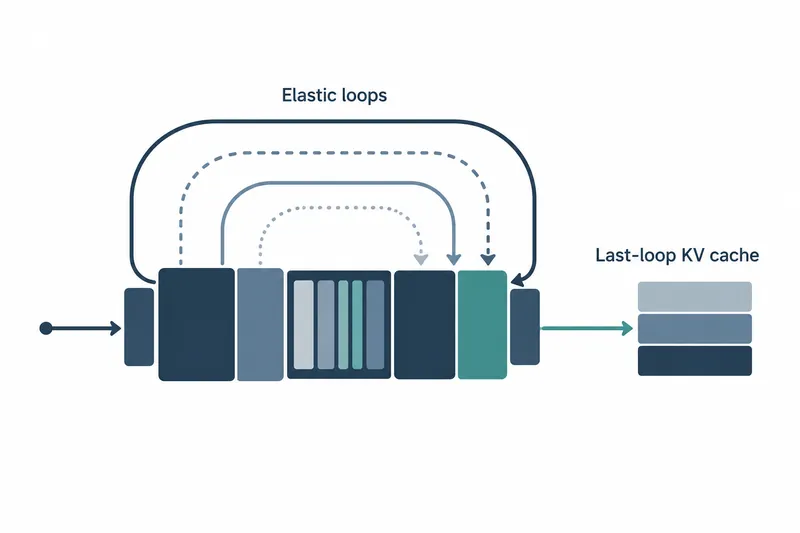
英伟达发布了一款重复使用相同计算层的40亿参数语言模型。希望将小模型用于服务的开发者,无需重新训练或更换模型,即可通过改变循环次数,调整各类任务的准确率与计算量之间的平衡。
1. 调整循环次数,而非模型大小
2026年10月16日发布的 Dory1.0-4B 会反复处理模型内部的中间表示。其方式是让数据多次通过同一计算块,并在每轮循环时重新注入输入。
英伟达建议以2轮循环作为平衡准确率与计算量的起点。若要尽量减少每个词元的计算量,可选1轮;对于编程智能体等更看重准确率的任务,可考虑4轮。词元是模型处理文本的片段单位。
2. 增加循环次数并不意味着准确率持续上升
准确率是在16位基准版本上测得的。英伟达表示,使用了由 NeMo Gym 和 Nemo Evaluator SDK 构成的同一评估体系。
在软件问题解决评估 SWE-bench Verified 中,循环1·2·4轮的得分分别为50.3、59.5、61.8。从1轮增加到2轮时提升幅度更大,为默认推荐值提供了依据。
终端任务评估 Terminal-Bench 2.1 对参与比较的模型也采用了相同的 Terminus-2 评估体系。循环1·2·4轮的得分分别为12.5、18.1、22.2。
相比之下,不使用工具的推理评估 GPQA Diamond 在相同循环设置下的得分为69.19、72.41、72.16。增加循环次数并不保证准确率提升,而是一项需按任务选择的计算预算。
3. 仅保存最后一轮,避免内存增长
KV cache 保存先前词元的信息,是生成时复用过去计算结果的存储空间。默认方式为每轮循环设置独立空间,而仅保留最后一轮的方式会覆盖每个循环层的一份缓存,因此即使循环次数增加,也能保持1轮的缓存大小。
这种方式的好处是能为长输入或并发请求留出内存。但循环计算本身并未消失。循环次数增加时,输出词元数也有减少的趋势,因此总响应时间与成本需要用实际任务测量。
英伟达表示,在其内部实验中,即使仅保存最后一轮,准确率也接近默认方式,输出长度几乎相同。两种方式的准确率差异未给出具体数值。
4. 运行需要使用支持该模型的源码
按原文所述,vLLM 支持仍在第60149号拉取请求中接受审查,纳入正式版本前需从该源码安装。llama.cpp 也提示,在正式版本发布前需构建支持该模型的源码。
以下是原文中的服务器启动示例,保持原样。循环次数为2轮,缓存按循环分别保存。
vllm serve --model nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 \
    --hf-overrides '{"n_recurrent_loops": 2, "recurrent_kv_cache_mode": "per_loop"}' \
    --max-model-len 262144 \
    --max-num-seqs 128 \
    --enable-prefix-caching \
    --async-scheduling \
    --reasoning-parser nemotron_v3 \
    --tool-call-parser qwen3_coder \
    --enable-auto-tool-choice
若仅保存最后一轮,将上述配置中的 recurrent_kv_cache_mode 值改为 last_loop。已验证的上下文长度最多为256K词元;若内存不足或希望增加并发请求数,建议降低最大长度。
5. 区分发行格式与测量条件
BF16 是权重与激活值均为16位的基准版本。MXFP8 是将权重降至8位、同时保持激活值为16位的发行版。
NVFP4 的权重为4位,激活值为16位。预训练也从一开始便使用4位浮点数,之后转为16位继续训练。
在英伟达 DGX Spark 上,批大小为1、输入2560·输出300词元时,8位与4位权重的推理速度分别为 BF16 的1.69倍、2.17倍。输入128·输出1024词元时,分别为1.84倍、2.44倍。不能直接比较这两种输入输出条件下的数值。
GGUF 发行版是5位系列量化文件,由 llama.cpp 直接读取。面向 Apple 芯片 Mac 的运行示例将上下文设为4096词元。不能将前述准确率分数视为该量化版本的结果,量化版本的准确率差异尚未给出。
该模型的价值在于以较小的参数规模调整计算预算,而是否引入,取决于在循环次数、缓存方式和发行格式相匹配的条件下开展的实际任务评估。