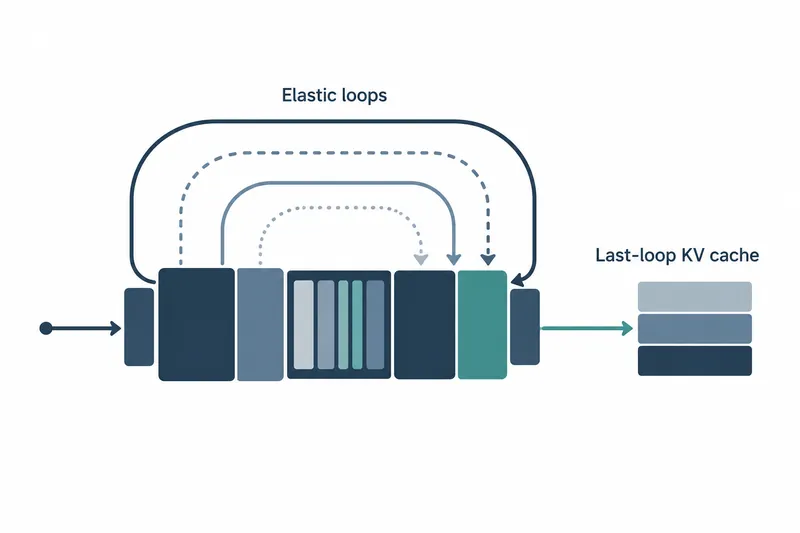
엔비디아가 같은 계산 층을 되풀이해 쓰는 40억 매개변수 언어 모델을 공개했다. 작은 모델을 서비스에 넣으려는 개발자는 재학습이나 모델 교체 없이 반복 횟수를 바꿔 작업별 정확도와 연산량의 균형을 조절할 수 있다.
1. 모델 크기 대신 반복을 조절한다
2026년 10월 16일 공개된 Dory1.0-4B는 모델 내부의 중간 표현을 반복해서 처리한다. 같은 계산 블록을 여러 번 통과시키는 방식이며, 반복할 때마다 입력을 다시 넣는다.
엔비디아는 정확도와 계산량의 균형을 위한 출발점으로 2회 반복을 권한다. 토큰당 계산을 최소화하려면 1회, 코딩 에이전트처럼 정확도가 더 중요한 작업에서는 4회를 고려하라는 안내다. 토큰은 모델이 글을 처리하는 조각 단위다.
2. 반복을 늘려도 정확도가 계속 오르지는 않는다
정확도는 16비트 기준형에서 측정했다. 엔비디아는 NeMo Gym과 Nemo Evaluator SDK로 구성한 동일 평가 체계를 썼다고 밝혔다.
소프트웨어 문제 해결 평가인 SWE-bench Verified 점수는 반복 1·2·4회에서 각각 50.3, 59.5, 61.8이다. 1회에서 2회로 갈 때 상승 폭이 더 커 기본 권장값을 뒷받침한다.
터미널 작업 평가인 Terminal-Bench 2.1은 비교 모델에도 같은 Terminus-2 평가 체계를 적용했다. 점수는 반복 1·2·4회에서 12.5, 18.1, 22.2였다.
반면 도구를 쓰지 않는 추론 평가 GPQA Diamond는 같은 반복 설정에서 69.19, 72.41, 72.16이었다. 반복 증가는 정확도 향상의 보장이 아니라 작업별로 선택할 계산 예산이다.
3. 마지막 반복만 저장해 메모리 증가를 막는다
이전 토큰의 정보를 보관하는 KV cache는 생성할 때 과거 계산을 재사용하는 저장 공간이다. 기본 방식은 반복마다 별도 공간을 두지만, 마지막 반복만 남기는 방식은 순환 층마다 하나의 캐시를 덮어써 반복 횟수가 늘어도 1회 크기를 유지한다.
이 방식의 이익은 긴 입력이나 동시 요청에 쓸 메모리를 남기는 데 있다. 다만 반복 계산 자체가 사라지는 것은 아니다. 반복이 늘면 출력 토큰 수는 줄어드는 경향도 있어, 전체 응답 시간과 비용은 실제 작업으로 측정해야 한다.
엔비디아는 자체 실험에서 마지막 반복만 저장해도 기본 방식과 정확도가 가깝고 출력 길이가 거의 같았다고 설명했다. 두 방식의 정확도 차이에 대한 구체적인 수치는 제시되지 않았다.
4. 실행에는 지원 소스가 필요하다
원문 기준으로 vLLM 지원은 풀 리퀘스트 60149번에서 검토 중이며, 정식 릴리스에 포함되기 전에는 해당 소스에서 설치해야 한다. llama.cpp도 정식 릴리스 전에는 지원 소스를 빌드하도록 안내한다.
다음은 원문 그대로의 서버 실행 예시다. 반복은 2회이며 캐시는 반복별로 저장한다.
vllm serve --model nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 \
    --hf-overrides '{"n_recurrent_loops": 2, "recurrent_kv_cache_mode": "per_loop"}' \
    --max-model-len 262144 \
    --max-num-seqs 128 \
    --enable-prefix-caching \
    --async-scheduling \
    --reasoning-parser nemotron_v3 \
    --tool-call-parser qwen3_coder \
    --enable-auto-tool-choice
마지막 반복만 저장하려면 위 설정의 recurrent_kv_cache_mode 값을 last_loop로 바꾼다. 검증된 문맥 길이는 최대 256K 토큰이며, 메모리가 부족하거나 동시 요청을 늘리려면 최대 길이를 낮추도록 권한다.
5. 배포 형식과 측정 조건을 구분한다
BF16은 가중치와 활성값이 모두 16비트인 기준형이다. MXFP8은 활성값을 16비트로 유지하면서 가중치를 8비트로 줄인 배포본이다.
NVFP4는 가중치가 4비트이고 활성값은 16비트다. 사전 학습도 처음부터 4비트 부동소수점으로 시작한 뒤 16비트로 이어 갔다.
엔비디아의 DGX Spark에서 배치 크기 1, 입력 2560·출력 300토큰일 때 8비트와 4비트 가중치의 추론 속도는 BF16 대비 각각 1.69배, 2.17배였다. 입력 128·출력 1024토큰에서는 각각 1.84배, 2.44배였다. 두 입출력 조건의 수치를 직접 비교해서는 안 된다.
GGUF 배포본은 5비트 계열 양자화 파일이며 llama.cpp가 직접 읽는다. 애플 실리콘 맥용 실행 예시는 문맥을 4096토큰으로 설정한다. 앞의 정확도 점수를 이 양자화본의 결과로 옮겨 읽어서는 안 되며, 양자화본의 정확도 차이는 제시되지 않았다.
이 모델의 가치는 작은 매개변수 규모에서 계산 예산을 조절하는 데 있으며, 도입 판단은 반복 횟수·캐시 방식·배포 형식을 맞춘 실제 작업 평가에 달려 있다.