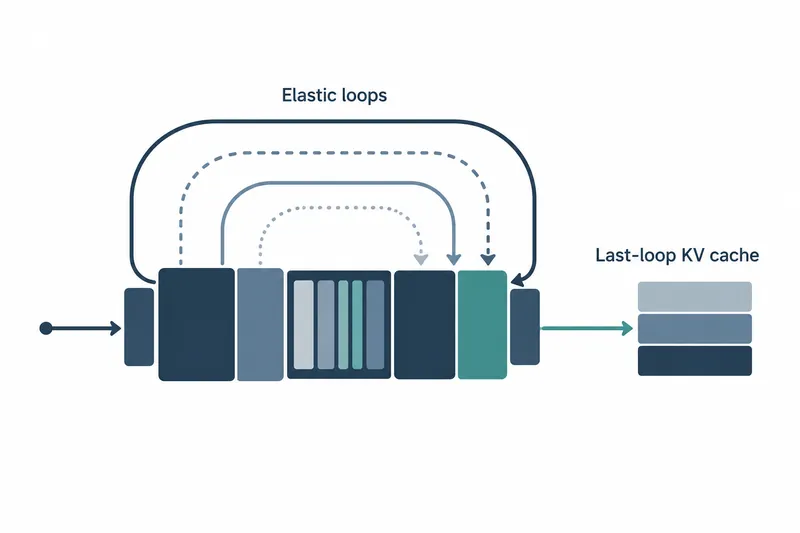
NVIDIAが、同じ計算層を繰り返し使う40億パラメータの言語モデルを公開した。小型モデルをサービスに組み込む開発者は、再学習やモデルの入れ替えなしに反復回数を変え、タスクごとの精度と計算量のバランスを調整できる。
1. モデルのサイズではなく反復を調整する
2026年10月16日に公開されたDory1.0-4Bは、モデル内部の中間表現を繰り返し処理する。同じ計算ブロックを複数回通す方式で、反復のたびに入力を再び与える。
NVIDIAは精度と計算量のバランスを取る出発点として2回の反復を勧める。トークン当たりの計算を最小限にするなら1回、コーディングエージェントのように精度がより重要なタスクでは4回を検討するよう案内している。トークンはモデルが文章を処理する際の断片の単位だ。
2. 反復を増やしても精度が上がり続けるわけではない
精度は16ビットの基準版で測定した。NVIDIAはNeMo GymとNemo Evaluator SDKで構成した同一の評価環境を使ったと説明した。
ソフトウェアの問題解決を評価するSWE-bench Verifiedのスコアは、反復1・2・4回でそれぞれ50.3、59.5、61.8だ。1回から2回への上昇幅がより大きく、標準の推奨値を裏付ける。
ターミナル作業の評価であるTerminal-Bench 2.1では、比較対象モデルにも同じTerminus-2評価環境を適用した。スコアは反復1・2・4回で12.5、18.1、22.2だった。
一方、ツールを使わない推論評価のGPQA Diamondは、同じ反復設定で69.19、72.41、72.16だった。反復の増加は精度向上の保証ではなく、タスクごとに選ぶ計算予算だ。
3. 最終反復だけを保存してメモリの増加を防ぐ
以前のトークンの情報を保持するKV cacheは、生成時に過去の計算を再利用する保存領域だ。標準方式は反復ごとに別の領域を設けるが、最終反復だけを残す方式は循環層ごとに1つのキャッシュを上書きし、反復回数が増えても1回分のサイズを維持する。
この方式の利点は、長い入力や同時リクエストに使うメモリを確保できることだ。ただし、反復計算自体がなくなるわけではない。反復が増えると出力トークン数は減る傾向もあるため、全体の応答時間とコストは実際のタスクで測定する必要がある。
NVIDIAは自社実験で、最終反復だけを保存しても標準方式に近い精度となり、出力長もほぼ同じだったと説明した。両方式の精度差について具体的な数値は示されていない。
4. 実行には対応ソースが必要だ
原文時点では、vLLM対応はプルリクエスト60149でレビュー中であり、正式リリースに含まれるまでは当該ソースからインストールする必要がある。llama.cppも正式リリース前は対応ソースをビルドするよう案内している。
以下は原文のままのサーバー起動例だ。反復は2回で、キャッシュは反復ごとに保存する。
vllm serve --model nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 \
    --hf-overrides '{"n_recurrent_loops": 2, "recurrent_kv_cache_mode": "per_loop"}' \
    --max-model-len 262144 \
    --max-num-seqs 128 \
    --enable-prefix-caching \
    --async-scheduling \
    --reasoning-parser nemotron_v3 \
    --tool-call-parser qwen3_coder \
    --enable-auto-tool-choice
最終反復だけを保存するには、上記設定のrecurrent_kv_cache_modeの値をlast_loopに変える。検証済みのコンテキスト長は最大256Kトークンで、メモリ不足の場合や同時リクエストを増やす場合には最大長を下げることを勧めている。
5. 配布形式と測定条件を区別する
BF16は重みと活性値がともに16ビットの基準版だ。MXFP8は活性値を16ビットに維持しつつ、重みを8ビットに減らした配布版だ。
NVFP4は重みが4ビットで、活性値は16ビットだ。事前学習も最初から4ビット浮動小数点で始め、その後16ビットで続けた。
NVIDIAのDGX Sparkでバッチサイズ1、入力2560・出力300トークンの場合、8ビットと4ビットの重みでの推論速度はBF16比でそれぞれ1.69倍、2.17倍だった。入力128・出力1024トークンではそれぞれ1.84倍、2.44倍だった。両入出力条件の数値を直接比較してはならない。
GGUF配布版は5ビット系の量子化ファイルで、llama.cppが直接読み込む。Appleシリコン搭載Mac向けの実行例はコンテキストを4096トークンに設定する。前述の精度スコアをこの量子化版の結果と解釈してはならず、量子化版の精度差は示されていない。
このモデルの価値は小規模なパラメータ数で計算予算を調整できる点にあり、導入判断は反復回数・キャッシュ方式・配布形式をそろえた実タスクでの評価にかかっている。