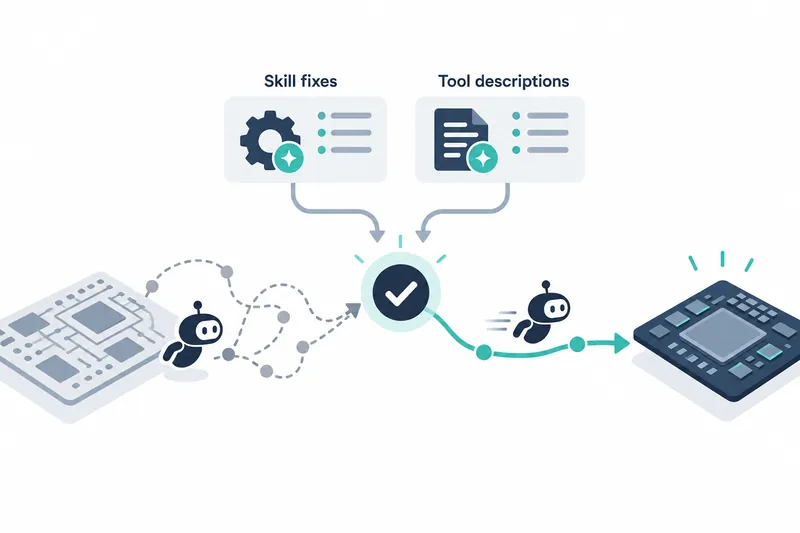
西门子修改了芯片设计AI智能体的任务指引和工具说明,提高了产物的验证得分,并减少了完成任务所需的对话轮次。这一案例没有更换模型,而是通过追踪最终设计资料中的错误来完善使用方法,值得开发设计自动化的团队参考。
1. 关注最终文件,而非工具调用
NVIDIA于2026年10月14日发布的文章介绍了使用NeMo Gym改进Siemens Fuse EDA AI Agent的过程。该智能体执行的标准单元特性分析,是为芯片的基本逻辑电路建立时序、功耗和噪声模型的工作。
分析结果保存在Liberty文件中。即使初始配置有误,也可能生成看似合理的文件,因此仅凭工具调用成功很难判断任务是否完成。实际的最终验证发现了单元和运行条件缺失、信号转换时间阈值错误,以及时序和功耗值超出允许范围等问题。
2. 验证器将失败原因反馈到下一次修改
NeMo Gym是一个将任务、智能体运行框架、验证器和运行状态组合起来进行评估的开源库。每次尝试都从干净的状态开始,并保留运行记录,以便在相同条件下重新比较同一任务。
本案例中的验证器相当于一份将产物与基准资料对照的检查表。它检查所需单元和条件是否齐全、文件能否用于验证工具、是否新增了基准资料中没有的失败,以及是否复用或截取了已有数值。只有通过这四道关卡,处于允许误差内的数值比例才会成为得分;任何一项失败,奖励均为0。
团队通过检查执行路径、失败的调用和验证器诊断,找出了含糊的指令与错误的工具选择。随后修改了作为任务指引的技能,以及智能体调用外部工具所用连接协议MCP的工具说明。核心是简化重叠的文件和Shell接口,并用明确的JSON模式定义工具输入。
3. 得分与效率的提升来自有限的开发任务
测量使用了开放的工艺设计套件GF180MCU。完整数据由229个标准单元和36种工艺、电压、温度组合构成,电路仿真使用Solido AFS。
实际用于调优的运行仅限于2个单元和相同的36种条件。模型固定为Claude Opus 4.8,运行框架固定为Claude Code。在这一开发基准测试中,平均综合验证得分从约55%提高至约95%。
在同一评估中,作为智能体对话与工具使用推进单位的轮次从155轮降至53轮,平均输出词元从约8万1000个降至约2万9000个。原文报告的降幅分别约为66%和64%。这并非运行全部229个单元的结果,文章也未提供测量硬件和以金额计的成本。
4. 先用通用示例了解评估流程
根据代码仓库说明,需要Python 3.13.14或更高版本。库本身不需要GPU,但模型推理或各任务服务器可能需要。安装后,在项目根目录的env.yaml中填入模型连接信息。
以下是原文中的快速入门配置,未作改动。这不是芯片设计实验所用的模型配置,而是通用多项选择题示例的配置。
policy_base_url: https://api.openai.com/v1
policy_api_key: <your-openai-api-key>
policy_model_name: gpt-4.1-2025-04-14
先启动连接模型、智能体与评分的本地服务器,再在另一个终端运行评估。运行后会留下执行记录和汇总指标。应用到自己的设计任务时,应先定义有效的最终产物并构建专用验证器,再反复进行失败分析、说明修改和相同条件下的重新评估。
5. 减少调用的代价是验证设计与反复运行
输出量和轮次的减少表明智能体的工作效率有所提升。但要取得这一效果,必须设计能识别遗漏和结果复用问题的领域专用验证器。团队进行了约25次运行,每次耗时约1.5~2小时。评估引入负担时,也应将这些反复验证的工作纳入考虑。
本案例的关键不是更换模型,而是验证最终产物中的错误,并将诊断结果用于修改任务指引和工具说明。