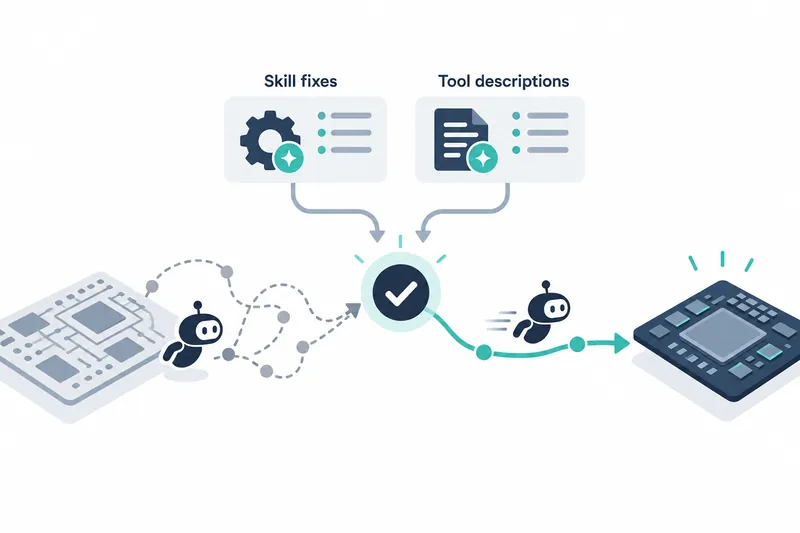
시멘스는 칩 설계용 AI 에이전트의 작업 지침과 도구 설명을 고쳐 결과물의 검증 점수를 높이고 작업에 필요한 대화 횟수를 줄였다. 모델을 바꾸기보다 완성된 설계 자료의 오류를 추적해 사용법을 다듬은 사례로, 설계 자동화를 개발하는 팀이 참고할 만하다.
1. 도구 호출보다 완성된 파일을 본다
NVIDIA가 2026년 10월 14일 공개한 글은 NeMo Gym으로 Siemens Fuse EDA AI Agent를 개선한 과정을 다룬다. 이 에이전트가 수행하는 표준 셀 특성 분석은 칩의 기본 논리 회로에 대해 동작 시간·전력·노이즈 모델을 만드는 작업이다.
분석 결과는 Liberty 파일에 담긴다. 초기 설정이 틀려도 파일이 그럴듯하게 생성될 수 있어, 도구 호출의 성공만으로 작업 완료를 판단하기 어렵다. 실제 최종 검증에서는 셀과 운용 조건 누락, 신호 전환 시간의 잘못된 임계값, 허용 범위를 벗어난 시간·전력 값이 드러났다.
2. 검증기가 실패 원인을 다음 수정으로 잇는다
NeMo Gym은 과제, 에이전트 실행 틀, 검증기, 실행 상태를 묶어 평가하는 공개 라이브러리다. 매 시도를 깨끗한 상태에서 시작하고 실행 기록을 남겨, 같은 과제를 같은 조건으로 다시 비교하게 한다.
이 사례의 검증기는 결과물을 기준 자료와 대조하는 검사표 역할을 한다. 필요한 셀과 조건이 모두 있는지, 파일이 검증 도구에서 사용 가능한지, 기준 자료에 없던 실패를 추가했는지, 기존 값을 재사용하거나 잘라낸 것은 아닌지 확인한다. 이 네 관문을 통과해야 허용 오차 안에 든 값의 비율이 점수가 되며, 하나라도 실패하면 보상은 0이다.
팀은 실행 경로와 실패한 호출, 검증기 진단을 살펴 모호한 지시와 잘못된 도구 선택을 찾았다. 이후 작업 지침인 스킬과, 에이전트가 외부 도구를 부르는 연결 규약인 MCP의 도구 설명을 수정했다. 겹치는 파일·셸 인터페이스를 단순화하고 도구 입력을 명시적인 JSON 스키마로 정의한 것이 핵심이다.
3. 점수와 효율은 제한된 개발 과제에서 개선됐다
측정에는 공개 공정 설계 키트인 GF180MCU를 사용했다. 전체 데이터는 표준 셀 229개와 공정·전압·온도 조합 36개로 구성되며, 회로 시뮬레이션에는 Solido AFS를 썼다.
실제 조정용 실행은 셀 2개와 같은 36개 조건으로 제한했다. 모델은 Claude Opus 4.8, 실행 틀은 Claude Code로 고정했다. 이 개발 벤치마크에서 평균 종합 검증 점수는 약 55%에서 약 95%로 높아졌다.
같은 평가에서 에이전트의 대화·도구 사용 진행 단위인 턴은 155회에서 53회로, 평균 출력 토큰은 약 8만1000개에서 약 2만9000개로 줄었다. 원문이 보고한 감소율은 각각 약 66%, 약 64%다. 이는 셀 229개 전체를 실행한 결과가 아니며, 측정 하드웨어와 금액 기준 비용은 제시되지 않았다.
4. 범용 예제로 평가 흐름부터 확인한다
저장소 안내에 따르면 Python 3.13.14 이상이 필요하다. 라이브러리 자체에는 GPU가 필요 없지만, 모델 추론이나 개별 작업 서버에는 필요할 수 있다. 설치 후 프로젝트 루트의 env.yaml에 모델 접속 정보를 넣는다.
다음은 원문 그대로의 퀵스타트 설정이다. 칩 설계 실험에 쓴 모델 설정이 아니라, 범용 다중 선택 문항 예제를 위한 설정이다.
policy_base_url: https://api.openai.com/v1
policy_api_key: <your-openai-api-key>
policy_model_name: gpt-4.1-2025-04-14
모델·에이전트·채점을 연결하는 로컬 서버를 먼저 시작한 뒤 다른 터미널에서 평가를 실행한다. 결과로 실행 기록과 집계 지표가 남는다. 자신의 설계 작업에 적용할 때는 유효한 최종 산출물을 정의하고 전용 검증기를 만든 다음, 실패 분석과 설명 수정, 같은 조건의 재평가를 반복하는 순서다.
5. 호출 절감의 대가는 검증 설계와 반복 실행이다
출력량과 턴 감소는 에이전트의 작업 효율이 좋아졌음을 보여준다. 다만 이를 얻으려면 누락과 결과 재사용까지 잡아내는 분야별 검증기를 설계해야 한다. 팀은 회당 약 1.5~2시간이 걸리는 실행을 약 25회 수행했다. 이 반복 검증 작업까지 포함해 도입 부담을 판단해야 한다.
이 사례의 핵심은 모델 교체가 아니라, 최종 산출물의 오류를 검증하고 그 진단을 작업 지침과 도구 설명의 수정으로 연결한 데 있다.