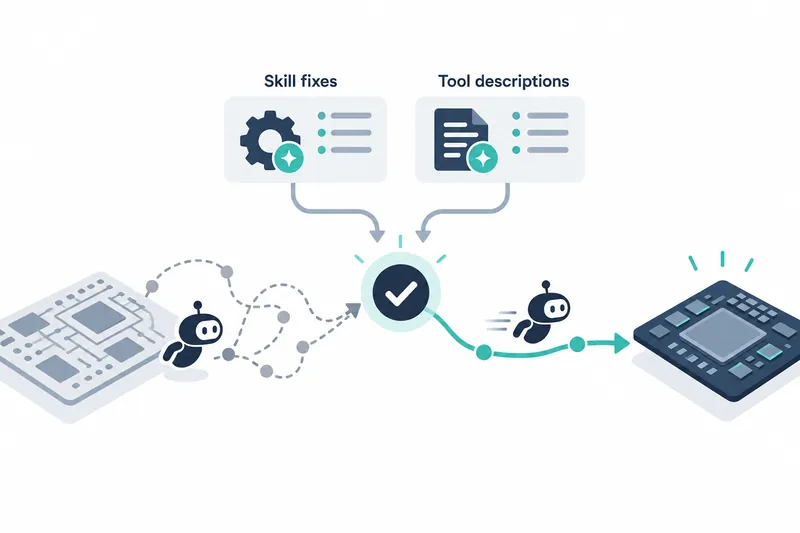
シーメンスはチップ設計用AIエージェントの作業指示とツール説明を修正し、成果物の検証スコアを高め、作業に必要な対話回数を減らした。モデルを変えるよりも、完成した設計データのエラーを追跡して使い方を磨いた事例であり、設計自動化を開発するチームの参考になる。
1. ツール呼び出しより完成したファイルを見る
NVIDIAが2026年10月14日に公開した記事は、NeMo GymでSiemens Fuse EDA AI Agentを改善した過程を扱っている。このエージェントが行う標準セルの特性評価は、チップの基本論理回路について動作時間・電力・ノイズのモデルを作る作業である。
解析結果はLibertyファイルに格納される。初期設定が誤っていても、それらしいファイルが生成されることがあり、ツール呼び出しの成功だけでは作業完了を判断しにくい。実際の最終検証では、セルや動作条件の欠落、信号遷移時間の誤ったしきい値、許容範囲外の時間・電力値が明らかになった。
2. 検証器が失敗原因を次の修正につなぐ
NeMo Gymは、課題、エージェントの実行基盤、検証器、実行状態をまとめて評価する公開ライブラリである。各試行をクリーンな状態で始め、実行記録を残すことで、同じ課題を同じ条件で再び比較できるようにする。
この事例の検証器は、成果物を参照データと照合するチェックリストの役割を担う。必要なセルと条件がすべてそろっているか、ファイルが検証ツールで使えるか、参照データになかった失敗を追加していないか、既存値を再利用したり切り詰めたりしていないかを確認する。この四つの関門を通過して初めて許容誤差内にある値の割合がスコアとなり、一つでも失敗すれば報酬は0になる。
チームは実行経路、失敗した呼び出し、検証器の診断を調べ、曖昧な指示や誤ったツール選択を見つけた。その後、作業指示であるスキルと、エージェントが外部ツールを呼び出す接続規約であるMCPのツール説明を修正した。重複するファイル・シェルのインターフェースを簡素化し、ツール入力を明示的なJSONスキーマで定義したことが要点である。
3. スコアと効率は限定的な開発課題で改善した
測定には公開プロセス設計キットのGF180MCUを使用した。全データは標準セル229個とプロセス・電圧・温度の組み合わせ36個で構成され、回路シミュレーションにはSolido AFSを使った。
実際の調整用の実行はセル2個と同じ36個の条件に限定した。モデルはClaude Opus 4.8、実行基盤はClaude Codeに固定した。この開発ベンチマークでは、平均総合検証スコアが約55%から約95%に上昇した。
同じ評価で、エージェントの対話・ツール使用の進行単位であるターンは155回から53回に、平均出力トークンは約8万1000個から約2万9000個に減少した。原文が報告した削減率はそれぞれ約66%、約64%である。これはセル229個全体を実行した結果ではなく、測定用ハードウェアや金額ベースのコストは示されていない。
4. 汎用の例で評価の流れから確認する
リポジトリの案内によると、Python 3.13.14以上が必要である。ライブラリ自体にはGPUは不要だが、モデル推論や個別のタスクサーバーには必要な場合がある。インストール後、プロジェクトルートのenv.yamlにモデルの接続情報を入力する。
以下は原文のままのクイックスタート設定である。チップ設計実験で使ったモデル設定ではなく、汎用の多肢選択問題の例に向けた設定である。
policy_base_url: https://api.openai.com/v1
policy_api_key: <your-openai-api-key>
policy_model_name: gpt-4.1-2025-04-14
モデル・エージェント・採点をつなぐローカルサーバーを先に起動し、別のターミナルで評価を実行する。結果として実行記録と集計指標が残る。自分の設計作業に適用する際は、有効な最終成果物を定義して専用検証器を作り、失敗の分析と説明の修正、同じ条件での再評価を繰り返す手順となる。
5. 呼び出し削減の代償は検証設計と反復実行である
出力量とターンの減少は、エージェントの作業効率が改善したことを示す。ただし、これを得るには欠落や結果の再利用まで検出する分野別の検証器を設計しなければならない。チームは1回当たり約1.5~2時間かかる実行を約25回行った。この反復検証作業まで含めて導入の負担を判断する必要がある。
この事例の核心はモデルの交換ではなく、最終成果物のエラーを検証し、その診断を作業指示とツール説明の修正につなげた点にある。